
AIの基礎
過学習とは何か?

 Unite.AI を Google の優先ソースに追加
過学習は、モデルがトレーニングデータ上で非常にうまく機能するパターンやノイズを捉えるが、新しい例に対しては一般化できない場合に起こります。過学習したモデルはトレーニング誤差が非常に低い一方で、検証や実際のパフォーマンスが著しく劣ることがあります。
反対の問題は過少適合です:モデルや学習プロセスがトレーニングセット上でも十分なシグナルを捉えられません。優れたモデリングは、完璧なトレーニング性能を追求するのではなく、適合と一般化のバランスを取ります。
重要ポイント
- トレーニング性能だけでは一般化を診断できません。
- 早期停止は検証の挙動を基にすべきで、最終テストセットでの繰り返しの判断は行うべきではありません。
- データを増やすことで改善できる場合がありますが、特徴量や容量を増やすと過学習が悪化することもあります。
- 正則化、データ拡張、交差検証、情報漏洩防止、適切な評価はそれぞれ異なる原因に対処します。
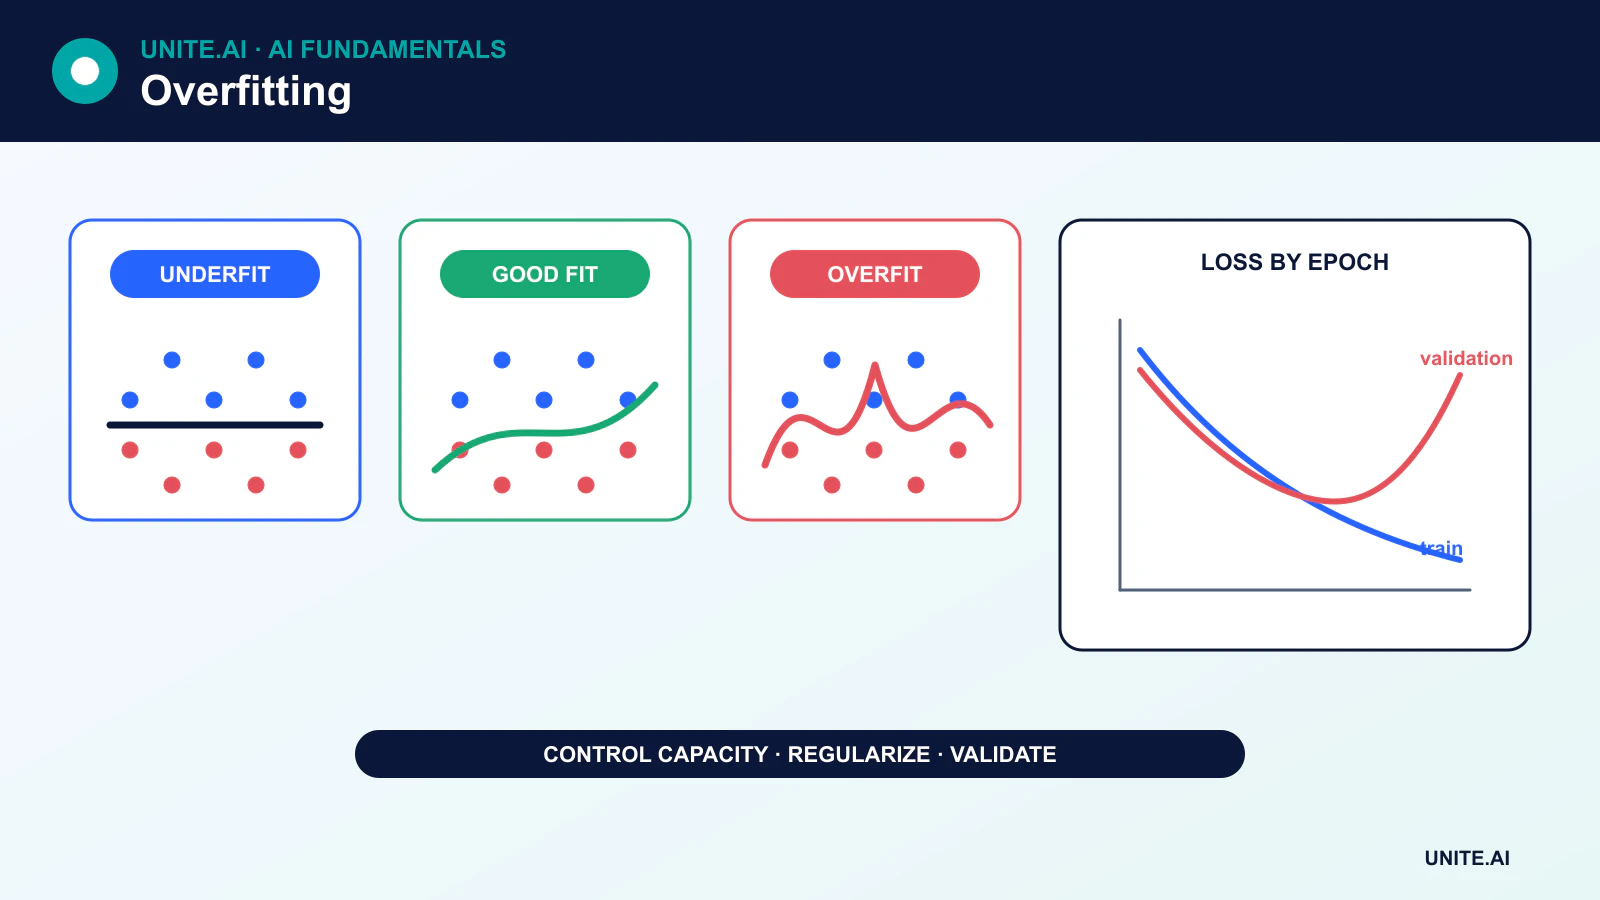
適合、過少適合、過学習
モデルが過少適合になるのは、仮定が過度に制限的である、特徴量が重要なシグナルを欠いている、最適化が不十分である、または学習が不十分である場合です。関連する特徴量や容量を追加すれば改善することがありますが、任意の特徴量を単に増やすだけではノイズが増えて過学習を招くことがあります。
モデルが過学習するのは、トレーニングデータの情報量に対して有効容量が過剰な場合です。例として、極小のリーフを多数作る深い決定木、ランダムな揺らぎに合わせた多項式、あるいは例を丸暗記するニューラルネットワークが挙げられます。
トレーニング、検証、テストデータの役割
- トレーニングデータはモデルパラメータをフィットさせます。
- 検証データはアーキテクチャ、ハイパーパラメータ、閾値、停止時点を選択します。
- テストデータはそれらの選択が完了した後の最終的な評価を提供します。
テストセットを繰り返し意思決定に用いると、開発プロセスの一部となり、偏りのない最終評価を提供できなくなります。交差検証は限られたデータをより効率的に活用できますが、前処理や特徴量選択はすべて各トレーニングフォールド内で行う必要があります。
早期停止
学習中、トレーニングロスは通常減少し続けます。検証ロスは最初は減少するものの、モデルがトレーニングノイズに特化すると後に上昇することがあります。早期停止は最良の検証指標を持つチェックポイントを保存するか、検証が所定の忍耐期間改善しなかった場合に停止します。
正しいチェックポイントは最低のトレーニングロスを持つものではありません。早期停止とチューニングの決定が完了した後に、別個の最終テストセットで評価します。
正則化手法
重みペナルティ
L2正則化(重み減衰)は大きなパラメータ値を抑制します。L1正則化はスパースな係数を促進します。その効果はモデルや最適化手法に依存します。たとえばAdamWは重み減衰を適応的更新から切り離します。
ドロップアウトと確率的正則化
ドロップアウトは学習中にアクティベーションをランダムにマスクします。他の手法はパスを削除したり、特徴量を摂動させたり、ラベルを平滑化したりします。これらの技術は学習目的を変えるため、推論時には無効化するか適切に処理する必要があります。
データ拡張
拡張は、切り取り、回転、ノイズ、パラフレーズなど、ターゲットを保持すべき現実的なバリエーションを生成します。無効な変換はラベルを変えてモデルに悪影響を与える可能性があります。画像分野では、Albumentations のようなツールが制御されたパイプライン実装に役立ちます。
容量制御
浅い木構造、パラメータ数の削減、特徴量選択、プルーニング、よりシンプルな仮説クラスは分散を減らすことができます。木のプルーニングは基準に基づくもので、学習した詳細をランダムに除去するものではありません。
データ漏洩は例外的な性能に見えることがある
漏洩は、予測時に利用できない情報がトレーニングや評価に入り込むことで発生します。一般的な例として、全データセットで正規化を適用する、重複レコードをフォールド間で分割する、過去を予測するために将来データを使用する、ターゲットから派生した特徴量を含める、などがあります。
漏洩は通常の過学習とは異なりますが、オフライン結果と本番導入との間に同様の誤解を招くギャップを生み出します。分割戦略は時間、個体識別、場所、データ生成プロセスを考慮すべきです。
分布シフトは別問題
モデルはテスト分布には一般化できても、実運用データが変化すると失敗することがあります。新しいデバイス、ポリシー、集団、季節、あるいは敵対的な振る舞いが入力とターゲットの関係を変える可能性があります。元のモデルが過学習していなくても、モニタリングと定期的な再評価が必要です。
過学習の診断
学習曲線、交差検証の分散、サブグループ指標、キャリブレーション、エラー検査を活用します。トレーニングと検証の両方の性能が低い場合は、過少適合、特徴量、ラベル、最適化に注目します。トレーニングは良好だが検証が弱い場合は、容量、漏洩、正則化、代表性を調査し、単にデータを増やす前に対策を講じます。
過学習が起こる理由と検出方法
過学習は、モデルがトレーニング誤差を減らすパターンを学習するものの、ターゲット集団に一般化できない場合に起こります。原因としては、実効データに対して過剰な容量、ラベルノイズ、重複エンティティ、柔軟な特徴量選択、漏洩、同一検証セットでのチューニングが挙げられます。トレーニングと検証性能のギャップが拡大することが一般的な証拠ですが、両セットが汚染を共有している、または本番と異なる場合は小さなギャップでも過学習の可能性があります。データ量と容量に対する学習曲線は、分散とバイアスを区別するのに役立ちます。
漏洩は特に欺瞞的です。将来情報、重複、対象の重複、全データに対する前処理の適用、メタデータにエンコードされたラベルなどが、保持データで優れたスコアを生むことがあります。変換や拡張を適用する前に、デプロイ時に新しくなる単位(患者、顧客、機械、場所、時間)で分割します。特徴量、アーキテクチャ、閾値を選択する間は最終テストセットを封印しておきます。チームがテスト結果を繰り返し確認すると、テストセットは別の検証セットとなり、置き換えや正式な修正が必要です。
正則化、モデル選択、そして本番ドリフト
より代表的なデータ、容量の削減、重み減衰、ドロップアウト、早期停止、データ拡張、アンサンブル、ドメイン構造を反映した制約などで過学習を抑制します。各手法にはトレードオフがあり、拡張はラベルを歪める可能性があり、ドロップアウトは最適化を変え、アンサンブルは提供コストを増加させます。交差検証は選択の変動性を推定しますが、グループ化や時間感覚のフォールドはデプロイ境界を保つ必要があります。シンプルなモデルと比較し、最も有利な実行を選ぶのではなく、フォールドやシード間の不確実性を報告します。
本番環境では、入力、ユーザー、インセンティブ、測定が変化した際に別の一般化失敗が顕在化します。特徴量と予測の分布、キャリブレーション、サブグループの結果、遅延した真値をモニタリングします。未レビューのフィードバックで自動的に再学習しないでください。モデルの決定が後に見るラベルを形成することがあります。失敗がドリフト、データパイプライン、ポリシー変更、または無効なターゲットに起因するか診断します。過学習は実験設計とライフサイクルの規律で制御され、単一の正則化設定で解決できるものではありません。
実例:不正検知モデルにおける漏洩除去
最初の不正分類器は、カードや加盟店の重複イベントがランダムなトレーニング・テスト行に現れ、数週間後に記録されたチャージバック情報が特徴量として含まれていたため、非常に高いスコアを示しました。チームは各特徴量の利用可能時点を再構築し、決定後のフィールドを除去し、アカウント単位でグループ化し、前方時間分割を使用しました。性能は急激に低下しましたが、実際の判断を推定できるようになりました。シンプルなルールベースのベンチマークと学習曲線が必要なモデル複雑度を導きます。
正則化と早期停止は過去のフォールド内でのみチューニングされます。最終評価では、レビュー容量における適合率、再現率、キャリブレーション、そして不正タイプと顧客セグメント別のコストを報告します。本番では、確定ラベルが遅れて到着し、どの取引がレビューされたかに偏りがあるため、モニタリングによりスコアドリフトと結果推定を分離します。再学習は裁定済みケースを使用し、現在のポリシーに対して再実行します。プロジェクトは、展開に耐えられない高い漏洩スコアよりも、低めだが正直なスコアを好みます。
実装エビデンスと運用準備性
本番での導入判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しやすいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプとエビデンスを区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間のオーバーライド、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せず、デプロイ後に実世界のエビデンスをレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントを文書化する必要があります。
よくある質問
シンプルなモデルでも過学習しますか?
はい。繰り返しの特徴量選択、閾値調整、または同一のホールドアウトでの評価は、最終モデルがシンプルであっても開発プロセスを過学習させる可能性があります。
より多くのトレーニングデータは常に過学習を解決しますか?
いいえ。より代表的で正しくラベル付けされたデータは助けになりますが、重複したデータやバイアスのあるデータ、漏洩したデータ、ドメイン外のデータは効果がありません。学習目的と評価設計は依然として重要です。
主要参考文献












