
AIの基礎
市販の機械学習モデル vs カスタム機械学習モデル

 Unite.AI を Google の優先ソースに追加
機械学習ソリューションの選択は、単純な購入対自作の決定であることは稀です。実際の連続体は、ホスト型 API やパッケージ化されたモデルから、プロンプト、検索、ファインチューニングを経て、組織固有のデータで訓練された完全にカスタムなアーキテクチャまでです。
最適な選択肢は、検証済みの製品要件を満たす中で最もシンプルなアプローチです。カスタムモデルは制御性と差別化をもたらしますが、データパイプラインの運用、評価、モニタリング、セキュリティ、更新、ロールバックといった継続的な義務も伴います。
重要ポイント
- 測定可能なタスク、機械学習を使用しないベースライン、受け入れ閾値から始める。
- 候補モデルは、公開ベンチマークのスコアだけでなく、代表的なプライベートデータで評価する。
- 統合コスト、レイテンシ、レビュー、再訓練、インシデントコストを総所有コストに含める。
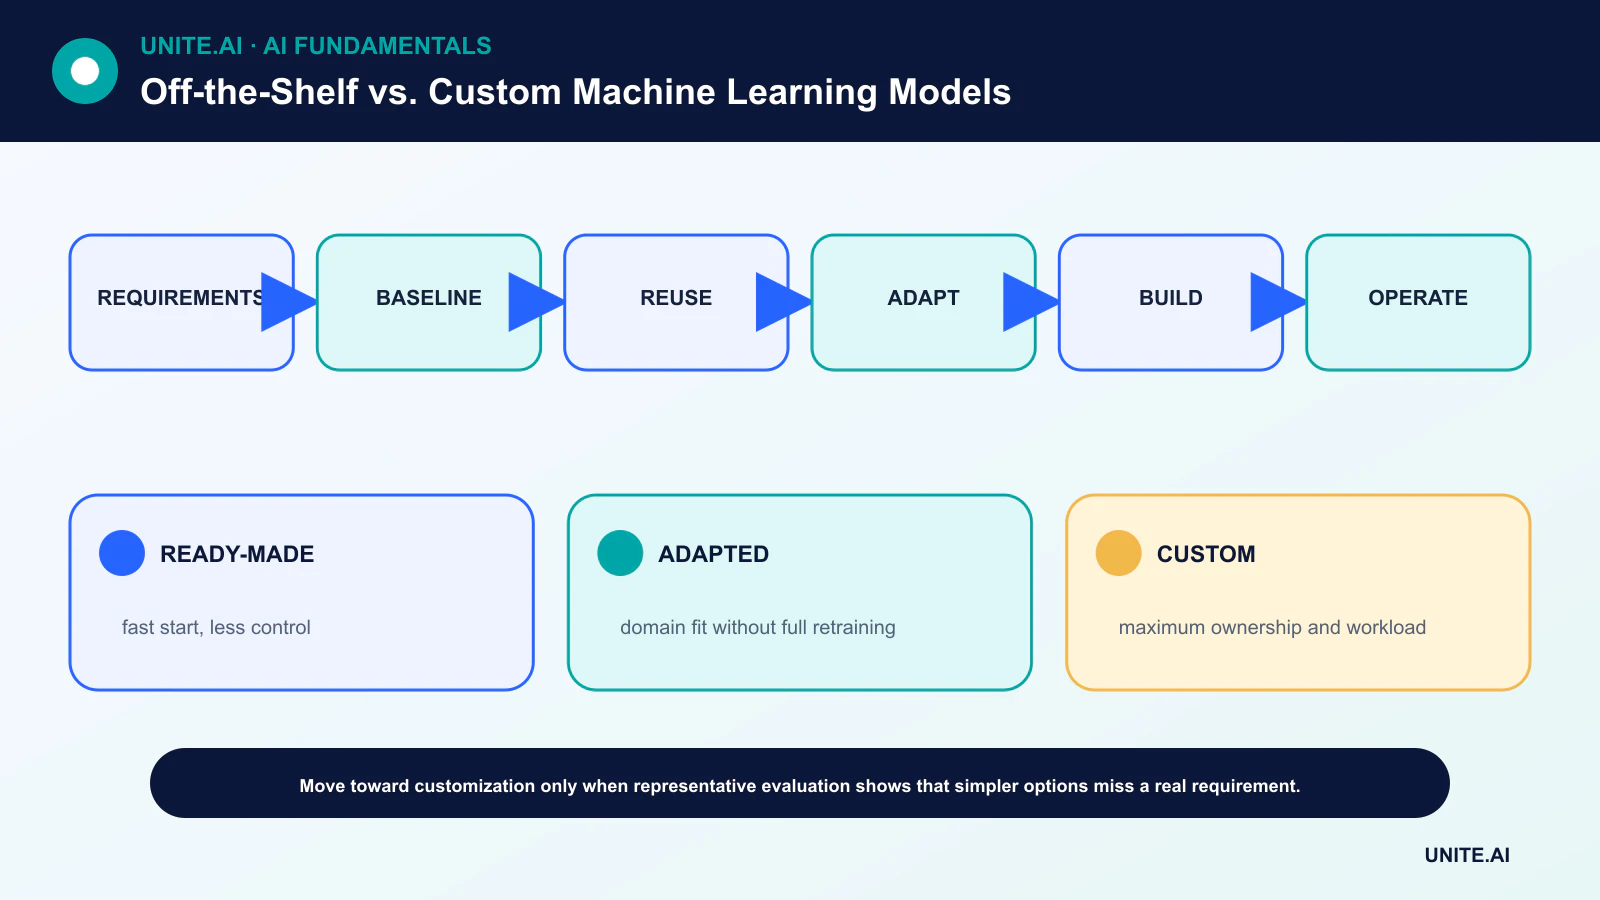
- 可逆的な段階を優先する: ベースライン、検索またはプロンプト、ファインチューニング、そして証拠がある場合にのみスクラッチで訓練する。
モデルを選択する前に意思決定を定義する
ユーザー、意思決定、入力、出力、エラーコスト、レイテンシ予算、トラフィックパターン、エスカレーションパスを明示します。決定論的ルールや検索システムが問題の十分な部分を解決できるかを判断します。Google の Rules of ML は、複雑なモデリングに入る前にシンプルなベースラインと信頼できるインフラを推奨しています。
本番環境を反映したオフライン評価セットを作成し、稀なケースや敵対的ケースも含めます。意思決定が人に影響する場合は、サブグループチェックや人的レビュー規則を定義します。これらのゲートは、アーキテクチャ選択を好みの問題にするのではなく、比較を具体的にします。
再利用と適応の連続体
ホスト型 API は高速な統合と管理されたスケーリングを提供しますが、モデル内部、バージョン、データ処理に対する制御は限定的です。オープンな事前学習モデルはデプロイ時の制御性を高めます。検索やプロンプトエンジニアリングは、重みを変更せずにドメインコンテキストを追加できます。
ファインチューニングやパラメータ効率の高いアダプタは振る舞いを特化させます。スクラッチでの訓練は、データ、目的、規模、所有権要件が再利用で満たせない場合にのみ正当化されます。転移学習は、はるかに少ないデータと計算で大部分の価値を捉えることが多いです。
品質、制御、ロックイン
タスクの品質、キャリブレーション、レイテンシ、スループット、可用性、障害の一貫性を測定します。ベンダーモデルは自動的に改善される可能性がありますが、挙動が変わることもあります。セルフホストモデルは固定できますが、チームがアップデートや脆弱性を管理する必要があります。
契約条件は、データ保持、訓練利用、地域別処理、知的財産、サービスレベル、輸出経路、廃止に関する事項を含めるべきです。アプリケーションがモデル固有のアダプタをビジネスロジックから分離し、再現可能な評価成果物を保存すると、ポータビリティが向上します。
プライバシー、安全性、運用
すべてのデータフローと脅威境界をマッピングします。機密性の高い入力は、プライベートネットワーク、オンプレミス推論、またはエッジ AI が必要になることがあります。セルフホスティングはシステムを自動的に安全にするわけではなく、セキュリティとコンプライアンスの責任を運用者に移転します。
本番環境の所有権には、可観測性、ドリフトチェック、悪用モニタリング、インシデント対応、ロールバックが含まれます。運用チームは、どのモデル、プロンプト、データバージョン、ポリシーが結果を生んだかを回答できる必要があります。
段階的なエビデンスを使用し、イデオロギーに流されない
同一データセットと受け入れ基準で、オプション間の時間枠付きベンチマークを実施します。エンジニアリング時間、アノテーション、アクセラレータ使用、ベンダー料金、レビュー作業、障害コスト、変化の予想頻度を見積もります。
ゲートをクリアする最もシンプルな候補を選び、要件や価格が変わるたびに再評価します。カスタマイズは、測定可能な利益や必要な制御をもたらす場合に価値があります—単にオーダーメイドモデルが戦略的に重要に聞こえるからというだけではありません。
要件と総コスト比較
市販のモデル、API、またはパッケージ化システムは、ベンダーサポートと迅速な初期導入を伴う事前構築された機能を提供します。カスタムモデルは特定のタスク、データ、運用環境向けに訓練または大幅に適応されます。選択は要件: 目標成果、サブグループやエッジケースごとの品質、レイテンシ、スループット、可用性、説明可能性、データ所在、更新制御、統合、セキュリティ、障害の結果、から始まります。汎用ベンチマークやデモだけでは、製品がこれら要件を満たすか判断できません。
総コストには、評価、データ準備、ラベリング、統合、ライセンスまたは使用料、インフラ、モニタリング、レビュー、インシデント対応、アップグレード、退出が含まれます。市販品は初期エンジニアリングコストを下げますが、変動コスト、ロックイン、挙動変化、観測性の制限を招く可能性があります。カスタム開発はデータと MLOps の責任を追加し、事前学習済みウェイトやベンダーに依存することもあります。モデルコストは、必要な品質で成功したタスクごとに測定すべきで、トークン単位や訓練実行回数だけで測るべきではありません。
評価、調達、適応
ベンダー選定前に代表的なプライベートテストセットを構築し、すべての候補を同一のプロンプト、前処理、閾値、運用制限の下で実行します。曖昧、敵対的、未対応、多言語、高リスクケースも含めます。精度、キャリブレーション、レイテンシ、コスト、拒否率、セキュリティ、人的ワークフローへの影響を測定します。API の停止、レートリミット、地域別挙動、バージョン変更もテストします。ベンダーの主張には、訓練、権利、プライバシー、保持、サブプロセッサ、安全性、サポート、インシデント通知に関する文書が必要です。
適応オプションは、構成、検索、プロンプト、ファインチューニング、パラメータ効率の更新、カスタムヘッド、またはスクラッチ訓練といったスペクトラムを形成します。エビデンスを満たす最もシンプルな手法を使用します。検索は頻繁に変わる知識に適し、チューニングは形式やドメインの振る舞いを形作ります。決定論的コードは正確なルールを処理すべきです。強力なベースモデルでも、検索の不備、権限、統合の問題で失敗する可能性があるため、統合システムを検証します。
ライフサイクルと退出計画
ホスト型製品は変更されたり消滅したりする可能性がありますが、カスタムモデルは所有者がいなければ技術的負債になります。バージョン依存性を監視し、挙動と結果を把握し、再訓練や再評価のトリガーを定義し、ロールバックを維持します。移行に必要なデータとインターフェースを保存し、削除とエクスポートを交渉し、アプリ全体で単一ベンダーの独自スキーマが露出しないようにします。最適な選択はハイブリッドかもしれません: コモディティタスクには商用機能を、ドメインパフォーマンス、制御、リスクが持続的価値を生む領域にはカスタムコンポーネントを使用する。
実例:文書抽出モデルの選択
ある企業は、サプライヤー、言語、スキャン、手書き、エッジケースを網羅した請求書のプライベートテストセットを作成し、マネージド API、オープン事前学習モデル、適応モデル、ルールベースラインを比較します。項目精度、金額誤差、未対応文書、レイテンシ、スループット、プライバシー、データ所在、統合、正しく処理された請求書1件あたりのコストを評価します。ベンダーデモや公開ベンチマークはこのマッチング評価に取って代わりません。
選択されたハイブリッドは、商用 OCR サービスを使用し、低信頼度や高額の場合にローカル検証と人的レビューを行います。契約では保持、サブプロセッサ、更新、削除を定義し、アーキテクチャはソースファイルと退出パスを保持します。シャドウ期間でスキーマやサプライヤーのギャップを検出します。モニタリングは OCR、抽出、検証、レビュアーの修正を分離します。ベンダーの挙動が変わった場合、チームは金融ワークフローを書き換えることなく、凍結、切替、またはカスタムコンポーネントへの作業移行が可能です。
実装エビデンスと運用準備
本番導入の決定には、成功したデモ以上のものが必要です。対象ユーザー、運用環境、入力、出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正または欠損入力、分布シフト、依存障害、誤用、そして支援が不足しやすいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプとエビデンスを区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間のオーバーライド、確認された結果を示し、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、展開後に実世界のエビデンスをレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確な時点も必要です。
よくある質問
チームがスクラッチでモデルを訓練すべきタイミングは?
事前学習済みまたはホスト型オプションが検証済み要件を満たせず、チームが十分な独自データ、計算リソース、専門知識、長期的な運用体制を持っている場合です。
市販のモデルはメンテナンスフリーですか?
いいえ。統合、評価、バージョン変更、モニタリング、プライバシー制御、フォールバック動作は導入者の責任です。
主要参照文献











