
AIの基礎
生成AIとは何ですか?

 Unite.AI を Google の優先ソースに追加
Generative AIは、データ中のパターンを学習し、指示や例に条件付けられたときに新しいテキスト、画像、音声、動画、コード、その他の表現を生成するモデルを指します。出力は確率モデルから合成されたもので、データベースからそのまま取得されるわけではありませんが、検索ツールが外部の根拠を提供することはあります。
異なるモデルファミリーはそれぞれ異なる方法で生成します。自己回帰型トランスフォーマーはトークンを一つずつ予測し、拡散モデルはサンプルを反復的にノイズ除去し、生成的敵対ネットワーク(GAN)は生成器と識別器の対決を通じて学習します。
主なポイント
- 生成は学習された分布からの条件付きサンプリングであり、事実の正確な再現が保証されるわけではありません。
- トランスフォーマー、拡散モデル、GAN、変分オートエンコーダーはそれぞれ異なるトレードオフがあります。
- 検索とツールはシステムを根拠付けできるが、その出力や許可は依然として検証が必要です。
- リスク管理はデータ、モデル、インターフェース、デプロイ、モニタリング、コンテンツの出所にまたがります。
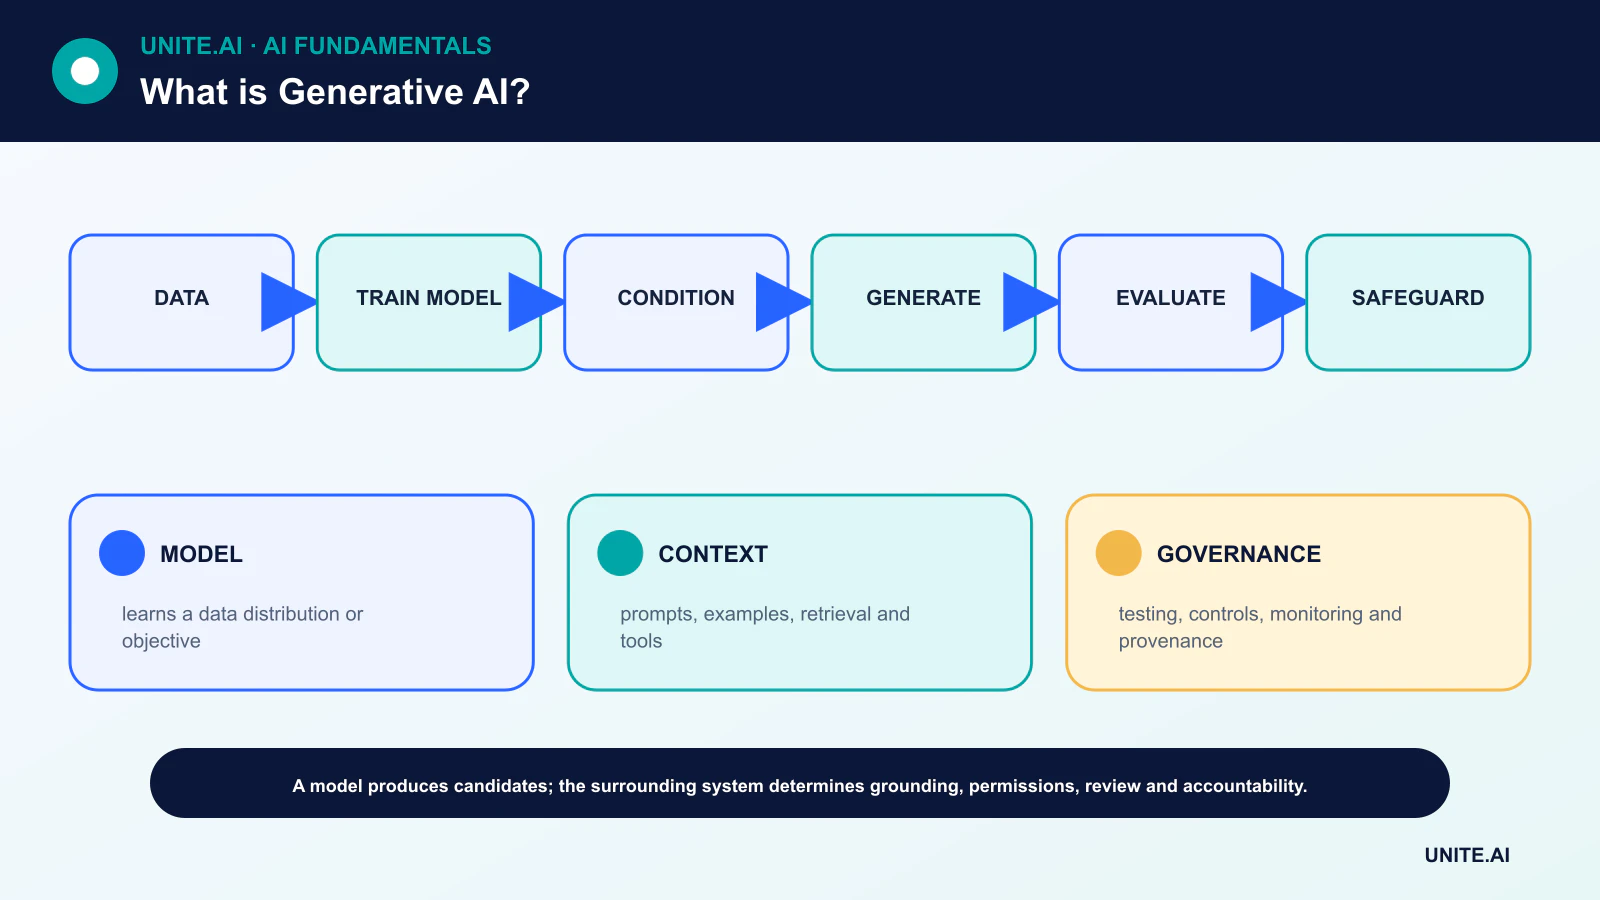
生成モデルの学習方法
学習目的は、モデルが例中のパターンを予測または再構築することに報酬を与えます。言語モデルは次のトークンを推定し、拡散モデルはノイズ過程を逆転させることを学び、変分オートエンコーダーは構造化された潜在分布とデコーダーを学習します。
この学習により統計的な一般化が可能になる一方で、バイアスを再現したり、稀なシーケンスを記憶したり、データ分布外で失敗したりすることがあります。そのため、データセットの文書化、重複除去、プライバシー制御、ホールドアウト評価はデプロイ前に重要です。
主要なアーキテクチャファミリー
自己回帰型トランスフォーマーはテキストを支配し、マルチモーダルシーケンスもサポートします。拡散モデルは高忠実度の画像や音声生成に広く用いられます。GANは鮮明なサンプルや制御可能な画像システムを作成できますが、訓練が難しいことがあります。
変分オートエンコーダーは潜在変数モデリングと効率的な表現を提供し、時には大規模な生成パイプライン内で使用されます。実際の製品はしばしば、検索、フィルタ、ツール、決定的コードと組み合わせて複数のモデルを統合しています。
条件付け、サンプリング、制御
プロンプト、クラスラベル、画像、音声クリップ、構造化レコードは生成を条件付けできます。サンプリングパラメータは多様性と決定性を変化させます。温度を下げるとトークン確率が集中しますが、誤った回答が正しくなるわけではありません。
システムが明示的なスキーマ、制約付きデコード、参照資料、検証を使用すると制御が向上します。プロンプトエンジニアリングはコンテキストを変え、ファインチューニングはパラメータを変え、検索は外部情報を提供します。それぞれが異なる失敗モードに対処します。
評価はアプリケーション固有
テキストシステムは事実性、タスク完了、引用サポート、毒性、キャリブレーションテストが必要になることがあります。画像や音声システムは忠実度、意味的整合性、多様性、アイデンティティ安全性、知覚的レビューが必要です。自動指標と代表的な人間評価を組み合わせます。
通常、稀少、敵対的、ポリシー関連ケースを含むバージョン管理された評価セットを構築します。レイテンシ、コスト、拒否動作と出力品質を追跡します。作成者が選んだデモは、全体的な信頼性の証拠ではありません。
リスク、保護策、出所
重要なリスクには、幻覚、プロンプト注入、有害コンテンツ、なりすまし、ツールの不安全な使用、プライバシー漏洩、著作権紛争、オートメーションバイアス、透明性のないサプライチェーンが含まれます。NISTのGenerative AI Profileは、ガバナンス、コンテンツ出所、デプロイ前テスト、インシデント開示にわたる行動を整理しています。
最小権限のツール、入出力制御、重要な判断に対する人間のレビュー、ロギング、ロールバック、ユーザー報告を使用します。ウォーターマークやコンテンツ認証はシグナルを追加できますが、単一の検出器やラベルで真実が確立されるわけではありません。より広範な合成メディアワークフローは、コンテキストと説明責任を保持しなければなりません。
モデルファミリーと生成メカニズム
Generative AIモデルは、新しいテキスト、画像、音声、動画、コード、または構造化データを生成できるプロセスを推定または学習します。自己回帰モデルは次のトークンや要素を予測し、拡散モデルはノイズ過程を逆転させることを学び、変分オートエンコーダーは確率的潜在変数を学習し、GANは識別器に対抗して生成器を訓練します。マルチモーダルシステムはメディア間の表現を結びつけます。出力はプロンプト、コンテキスト、ツール、その他の入力に条件付けられた学習された統計構造からサンプリングされ、保証された事実として取得されるわけではありません。
基礎モデルは広範なデータで事前学習され、プロンプト、検索、ファインチューニング、好み最適化、制御ネットワーク、タスク固有ヘッドを通じて適応されます。トークナイザ、エンコーダ、デコーダ、潜在空間、サンプリング設定が結果を形作ります。温度と候補フィルタリングは決定性と多様性のトレードオフです。長いプロンプトはコンテキストを提供しますが、矛盾したり、注意を逸らしたり、悪意ある指示を含むことがあります。検索は変化する知識を根拠付けられ、決定的コードは正確な計算や規則を処理すべきです。
評価、出所、権利
タスク: 正確性と引用(回答)、実行とセキュリティ(コード)、忠実度と多様性(メディア)、人間の成果(創造支援)で評価します。拒否、キャリブレーション、レイテンシ、コスト、言語、アクセシビリティ、敵対的テストも含めます。流暢またはフォトリアリスティックな出力でも間違っていることがあります。再現性のためにモデル、プロンプト、シード、ソース証拠、ツール呼び出し、ポストプロセスを保持します。検索品質と生成を分離し、洗練された回答が証拠欠如を隠さないようにします。
学習と出力は著作権、ライセンス、同意、プライバシー、パブリシティ、機密性の問題を提起します。入力データの出所と許可された使用を確立し、ユーザーが機密情報を露出しないようにし、記憶性をテストし、報告と削除プロセスを提供します。合成メディアは、可能な限り耐久性のある出所情報や開示を付与すべきです。特に証拠と誤認される可能性がある場合はなおさらです。権利を侵害したり欺く形で、肖像、声、スタイルを使用しないでください。
デプロイ制御
モデルの出力は信頼できない入力として扱います。スキーマを検証し、コードやファイルをサニタイズし、実行を分離し、すべてのツールを外部で認可し、コストとレートを制限し、重要な操作には確認を要求します。失敗、悪用、ドリフト、ユーザー修正を監視し、ロールバックと非生成的フォールバックを備えます。意図された使用と禁止された使用を文書化します。Generative AIは情報の作成・変換インターフェースを拡張しますが、信頼性と説明責任は周囲のデータ、評価、セキュリティ、出所、人間の意思決定プロセスから得られます。
実例: 生成的商品説明アシスタント
小売業者は、編集者が承認された商品属性とブランドガイダンスに基づいてドラフト説明を生成できるようにします。プロンプトには構造化された事実が含まれ、検索は最新のポリシーを提供します。出力はスキーマに従い、ソース値と照合して検証されます。サポートされていない項目、安全性の主張、認証は却下されます。評価は事実の正確性、スタイル、重複、多言語品質、アクセシビリティ、レイテンシ、編集者の修正をカバーし、テンプレートや手動執筆と比較します。
編集者はすべての公開を承認し、ソースフィールドを確認できます。モデルは価格、在庫、直接の公開を変更する能力を持ちません。プロンプトと商品データは注入から保護され、機密のサプライヤーノートは除外されます。モニタリングはサポートされていない主張、編集、苦情、コスト、プロバイダーのバージョンを追跡します。生成されたテキストは出所情報と共に保存されます。修正やレビューが利益を消さず、製品の真実が権威あるデータで管理される場合にのみ、システムはドラフト時間を節約します。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力、出力、依存関係、所有者、各重要な失敗の結果を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正または欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間の介入、確認された結果を明らかにすべきです。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧、インシデント学習、削除・保持手順の文書化、そして無効化または置換すべき明確な時点も必要です。
よくある質問
生成AIは大規模言語モデルと同じですか?
いいえ。LLMは生成モデルの一種です。生成AIには、画像、音声、動画、構造化データシステムなど、複数のアーキテクチャで構築されたものも含まれます。
モデルは訓練データをコピーしますか?
通常は学習したパターンから合成しますが、記憶やほぼ重複が起こることがあります。プライバシーと出所のリスクは、無視せずに評価する必要があります。
主要参考文献












