
AIの基礎
データサイエンスとは何か?

 Unite.AI を Google の優先ソースに追加
Data science は、データを裏付け可能な知識、予測、または意思決定に変換する実践です。ドメインの専門知識、統計、コンピューティング、データエンジニアリング、可視化、コミュニケーションを組み合わせます。モデルは作業の一部になることがありますが、学問はモデリングの前に始まり、デプロイ後も続きます。
最も重要な問いは「どのアルゴリズムを使うべきか?」ではありません。「どの意思決定を支援し、どのような証拠でそれに答えるか、そして結果が有用であり続けるかをどう確認するか?」です。
重要なポイント
- データサイエンスはエンドツーエンドのエビデンスワークフローであり、機械学習の同義語ではありません。
- 問題定義、測定、データガバナンスは、モデルの複雑さよりも成功を左右することが多いです。
- 予測的な質問と因果的な質問は、異なる前提条件と評価設計を必要とします。
- 展開された分析は、利用者に適したモニタリング、文書化、コミュニケーションが必要です。
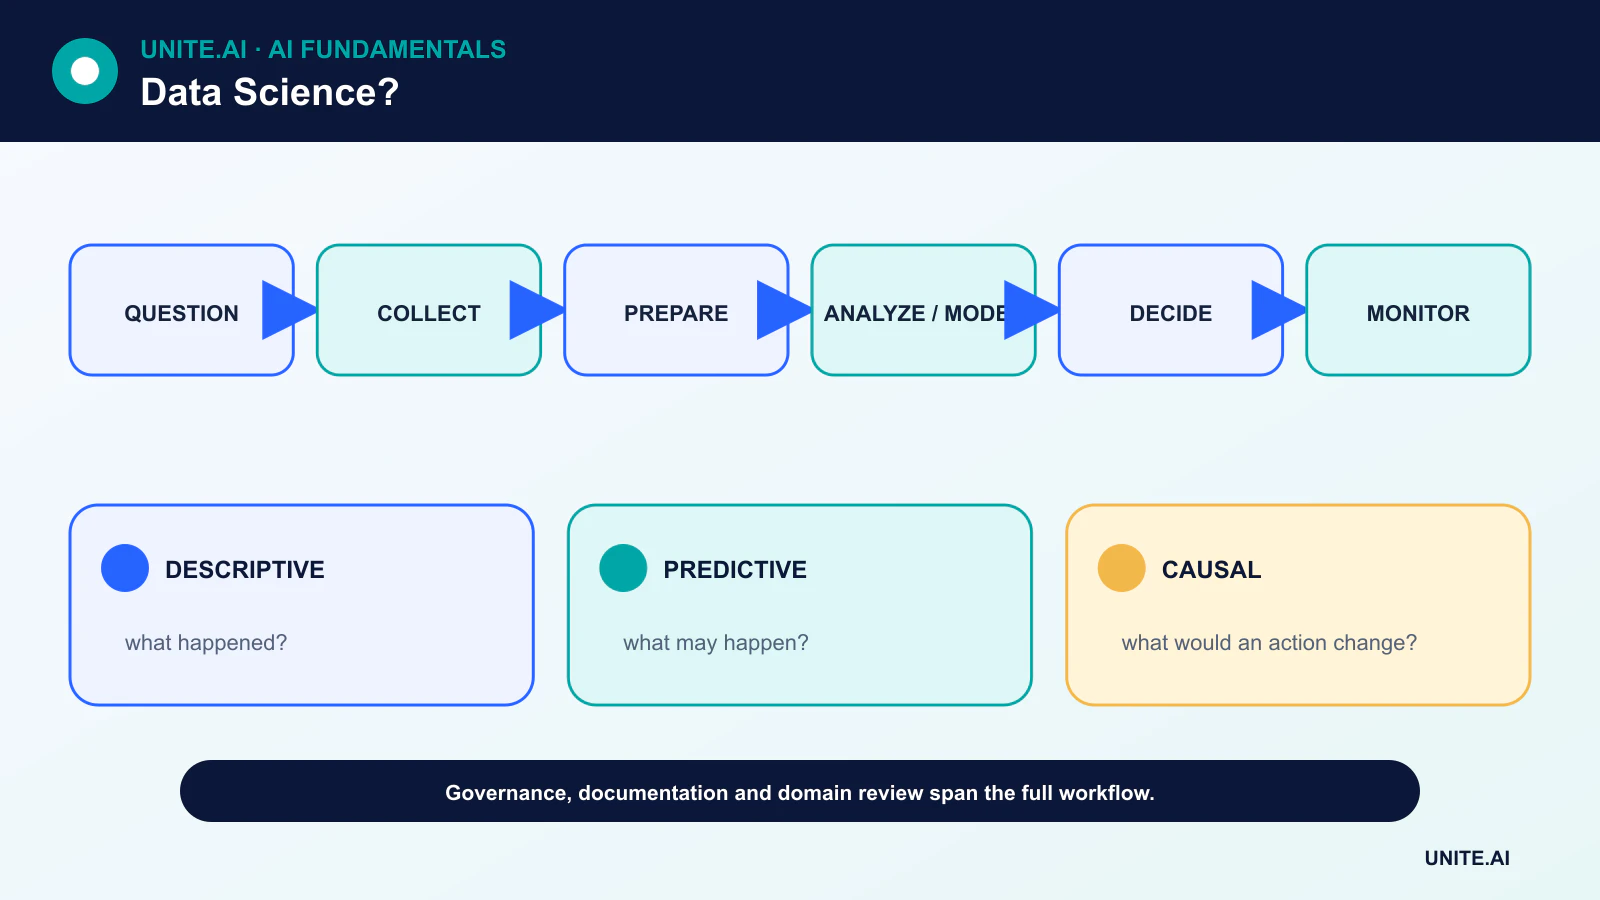
意思決定と推定量から始める
プロジェクトは、ユーザー、意思決定、介入、エラーのコストを特定すべきです。記述的な質問では、対象は率やトレンドになることがあります。予測の場合は、将来の需要やリスクが対象です。因果的な質問では、推定量は明示された前提の下で定義された介入の効果を表します。
「インサイトを見つける」など曖昧な目標では評価が不可能です。測定可能な目的はデータ収集の範囲を設定し、分析が利用可能なすべての領域に拡大するのを防ぎます。
データの収集、ガバナンス、理解
チームは、データソース、所有権、同意、保持、系統、アクセスを一覧化します。構造化データと非構造化データを区別し、単位とタイムスタンプを定義し、レコードが対象とする母集団や期間を表しているかを検証します。
クレンジングは欠損行を削除するだけではありません。重複の解消、あり得ない値の修正、ラベルの曖昧さ、スキーマドリフト、検閲、分析単位を変える結合などを含みます。すべての変換は再現可能で文書化されるべきです。
モデリング前に探索する
探索的分析は、分布、欠損、関係性、測定上の潜在的なアーティファクトを調べます。可視化により、要約平均が隠す外れ値やサブグループの違いが明らかになります。探索は仮説形成に役立てるべきで、確認的証拠と誤認してはなりません。
特徴エンジニアリング、次元削減、表現学習はモデリングを改善する可能性がありますが、変換はリークを防ぐためにトレーニングデータのみに適用すべきです。
質問に適した手法を選ぶ
統計的推定は関心のある量の不確実性を定量化します。機械学習は新しいデータに対する予測性能が主目的のときに有用です。介入効果が目的の場合は実験と因果推論手法が必要です。
ベースラインは理解しやすいほど単純であるべきです。より複雑なモデルは、保持データでの性能向上、較正された不確実性、運用価値、あるいは画像や自然言語処理といった必要な機能によって追加コストに見合う必要があります。
評価・コミュニケーション・モニタリング
評価は意思決定に合わせるべきです。分類器は単なる精度ではなく、適合率、再現率、較正、サブグループ分析が必要になることがあります。予測システムは時間感覚のバックテストが求められます。過学習やリークはプロセスの失敗であり、モデルの特性だけではありません。
コミュニケーションには前提条件、不確実性、制限、推奨アクションが含まれます。モデルやダッシュボードが使用され始めたら、チームは入力品質、結果のドリフト、ユーザー行動、下流への影響をモニタリングします。廃止された意思決定プロセスはアーカイブと明確な所有権が必要であり、展開されたものはオペレーターが必要です。
データサイエンスのライフサイクルと分析的質問
データサイエンスはドメイン知識、統計、コンピューティング、コミュニケーションを組み合わせ、データを意思決定のエビデンスに変換します。まず、記述、診断、予測、因果推論を区別します。何が起きたかを報告するダッシュボード、解約予測モデル、介入が解約に与える影響を推定する実験は、それぞれ異なる質問に答えます。データ抽出前に単位、母集団、時間窓、アウトカム、アクション、エラーコストを定義します。多くの失敗プロジェクトは、意図した意思決定を支えられない測定可能な代理指標を解決しようとします。
取得には出所、許可、サンプリング設計、データ契約が必要です。探索では分布、欠損、重複、外れ値、関係性、測定変化、潜在的リークを確認します。クレンジングの選択は分析上の前提です: 欠損行の削除、値の補完、外れ値の上限設定は母集団や結論を変える可能性があります。生データは不変にバージョン管理し、変換はコードとして管理し、単位と意味を含むデータ辞書を作成します。変換を学習する前、または仮説を繰り返しテストする前に評価データを分割します。
モデリング、推論、再現性
統計的推論は前提の下で不確実性を定量化します。予測モデリングはアウトオブサンプル性能を推定します。因果分析は設計または裏付け可能な前提による同定が必要です。質問とデータ生成プロセスに合致する手法を選択します。シンプルなベースラインと比較し、グループ化または時間感覚の検証を用い、不確実性と感度を報告します。高い相関や特徴重要度は因果関係を示すものではありません。多重検定、研究者の自由度、選択的報告は説得的なパターンを作り出す可能性があるため、事前登録や明確に分離された確認段階が有効です。
再現性はコード、環境、データスナップショット、乱数シード、クエリ定義、手動決定の記録を含みます。自動テストはスキーマ、ビジネス不変条件、変換、指標をカバーすべきです。ノートブックは探索に有用ですが、本番作業はモジュール化されレビュー可能なパイプラインが必要です。ピアレビューは前提、リーク、ターゲットの妥当性、結果の汎化性に挑むべきです。効果サイズ、不確実性、制限、反証を伝え、統計的有意性やモデルスコアだけに頼らないようにします。
デプロイと意思決定への影響
分析が定常的なプロセスを駆動する場合、所有者を割り当て、データの鮮度と結果の品質をモニタリングし、ロールバックや廃止を定義します。個人情報や機密情報は最小化、アクセス制御、保持、安全な出力で保護します。サブグループ効果やユーザーのモデルへの反応を評価し、フィードバックループが将来のデータを変える可能性があります。意思決定が実際の目標を改善したかどうかを測定し、単にモデルがデプロイされたかどうかだけで評価しません。データサイエンスは、エビデンスが信頼性かつ透明に行動を変えるときに成功し、所有者のないダッシュボードや機能、実験が蓄積されるだけでは成功しません。
実例:リテンション介入の測定
あるプロダクトチームはリテンション低下を観測し、アクティブユーザー、コホート、期間、除外条件、意思決定を定義します。アナリストはモデリング前に計測、欠損イベント、取得ミックスを監査します。記述的コホートは低下箇所を特定し、予測モデルは調査対象者を優先付けし、ランダム化オンボーディング実験は提案変更がリテンションを改善するかを推定します。これらは別々の前提と出力を持つ3つの異なる分析です。
ノートブック、クエリ、データスナップショット、指標定義、実験計画はバージョン管理されピアレビューされます。結果は効果サイズと不確実性を報告し、サポート需要とアクセシビリティのガードレールを設けます。ダッシュボードは実験をモニタリングしますが、事前に宣言された分析の代替にはなりません。介入が成功すれば、ロールアウトは段階的に行われ、長期的な行動をチェックします。作業は、複雑なモデルや視覚的に魅力的なチャートが作成されたからではなく、再現可能な意思決定を支える場合にのみ価値があるとみなされます。
実装エビデンスと運用準備
本番での意思決定は成功したデモだけでは不十分です。想定ユーザー、運用環境、入力、出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、サービスが行き届きにくいグループや環境をテストします。タスク品質を較正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプとエビデンスを区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間のオーバーライド、確認された結果を示すべきです。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せずにデプロイ後の実世界エビデンスをレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
データサイエンスはデータ分析と同じですか?
これらの用語は重なります。データサイエンスはデータ製品や予測システムの構築を含むことが多く、データ分析は記述的・診断的な意思決定支援に重点を置くことが多いです。組織によって使い方は異なります。
すべてのデータサイエンスプロジェクトにAIは必要ですか?
いいえ。適切に設計されたクエリ、チャート、実験、統計的推定は、複雑なモデルよりも有用で信頼性が高いことがあります。
主要参考文献











