
AIの基礎
データウェアハウスとは何か? アーキテクチャ、ETL、活用事例

 Unite.AI を Google の優先ソースに追加
データウェアハウスは、運用ソースから情報を統合し、レポーティング、ビジネスインテリジェンス、繰り返し可能な分析のために整理する分析データシステムです。取引を記録するアプリケーションとは別に、多くの分析ワークロードを分離します。
最新のウェアハウスは、カラム指向、分散型、サーバーレス、またはオブジェクトストレージに接続された形態を取ることがあります。重要な要素は一貫しています: ガバナンスされた取り込み、モデル化された意味、履歴、クエリ性能、セキュリティ、品質、そしてユーザーへの信頼できる提供です。
主なポイント
- 運用システムは現在の取引を最適化し、ウェアハウスはソース全体の履歴分析を最適化します。
- ETL はロード前に変換を行い、ELT は先にロードしてから分析プラットフォーム内で変換します。
- 次元モデル、正規化モデル、ワイドテーブルモデルは、異なるワークロードとガバナンス要件に対応します。
- 信頼性は、データ系統、テスト、鮮度、アクセス制御、セマンティック定義、コスト監視に依存します。
ソース、取り込み、ストレージ
データはバッチ、変更データキャプチャ、ストリーム、ファイル、API などで到着します。ランディングレイヤーはソースのコンテキストを保持し、変換は型を標準化し、レコードの重複除去、遅延イベントの処理、再利用可能な分析エンティティの作成を行います。
これは ETL ワークフローを拡張します。ELT はウェアハウスの計算リソースで変換を行い、ETL はロード前にデータを削減または検証できます。適切な選択はレイテンシ、プライバシー、規模、ツールチェーンに依存します。
質問向けデータモデリング
次元モデルは、顧客、製品、時間といった記述的次元を中心に測定可能な事実を整理します。正規化されたコアモデルは企業間の関係性を保持でき、非正規化されたマートは一般的なクエリを簡素化します。
セマンティックレイヤーは指標に一貫した定義を提供します。これがないと、チームは同じ行から見た目は正しいが異なる収益やリテンションの数値を作り出す可能性があります。構造化データでも合意された意味付けが必要です。
ウェアハウス、レイク、レイクハウス
データレイクは通常、オブジェクトストレージにファイルや多様な生データ・加工データを保存します。ウェアハウスは管理された分析テーブルとクエリサービスを提供します。レイクハウスの設計は、レイクストレージにテーブルメタデータ、トランザクション、ガバナンスを付加します。
これらは保証ではなくアーキテクチャパターンです。組織はしばしば データファブリック または共有ガバナンス層を通じて組み合わせます。ラベルよりもワークロード、スキル、相互運用性、ライフサイクルコストが重要です。
品質、セキュリティ、運用
所有者、契約、鮮度目標、系統、テスト、保持期間、行または列へのアクセスを定義します。個人識別情報は分離し、最小特権を使用し、機密クエリを監査します。バックフィルやスキーマ変更は制御された可視化可能な手順が必要です。
成功したリフレッシュ、データ遅延、テスト失敗、クエリ性能、採用率、インシデント影響、ワークロードごとのコストを測定します。指標をガバナンスされたデータに遡って結果を再現できる場合、ウェアハウスは有用です。
次元モデリングとセマンティクス
ファクトテーブルは、1つの注文行や1時間あたりの1デバイスなど、宣言された粒度でイベントや定期測定を記録します。次元は記述的なコンテキストを提供します。列を選択する前に粒度を宣言することで、二重集計を引き起こすレベル混在を防げます。加算可能な指標はすべての次元で合計できますが、半加算指標は時間軸で注意が必要です。
サロゲートキーは、変化するソース識別子からウェアハウスの履歴を切り離します。スロウチェンジングディメンションは属性変更の処理方法を定義します: 上書き、新しい履歴行の保持、または限定的な過去値の保持です。適切な手法は分析質問と保持義務に従います。
セマンティック指標は、式、フィルタ、時間挙動、通貨、除外項目、所有者、テストを定義すべきです。中央定義は不整合を減らしますが、ガバナンスは提案された変更とバージョン管理を許容すべきです。ユーザーが適切に検査・拡張できない場合、単一のセマンティックレイヤーはボトルネックになります。
最新のストレージとクエリアーキテクチャ
カラム指向ストレージは同一列の値をまとめて保持し、圧縮率を向上させ、必要なフィールドだけをスキャンします。パーティショニングは日付やその他のキーで大規模セクションを除外し、クラスタリングは関連値を同一に配置します。マテリアライズドビューやキャッシュは結果を再利用します。パーティション選択が不適切だと、小さなファイルやスキュー、コストの高いフルスキャンが発生します。
大規模並列クエリエンジンは、スキャン、結合、集計をワーカー間で分割します。結合時のデータ移動が実行時間の大部分を占めることがあるため、分散方式、統計、結合順序が重要です。オートスケーリングやサーバーレスサービスは容量管理を簡素化しますが、コスト管理、ワークロードの優先順位、無制限クエリへの制限が必要です。
レイクハウスのテーブルフォーマットは、オブジェクトファイル上にメタデータ、スナップショット、スキーマ進化、トランザクションセマンティクスを付加します。相互運用性は向上しますが、カタログや保守の責任が生じます。オープンフォーマットは、コンピュートエンジン、ガバナンス、運用手順が実際に利用できる場合にのみロックインを緩和します。
信頼性の高いパイプラインとデータプロダクト
パイプラインは冪等であるか、重複を調整できる必要があります。ウォーターマークとイベント時間で遅延到着を処理し、バックフィルで過去の変換を再現します。スキーマ契約は互換性のある変更を定義します。データテストは一意性、完全性、許容値、リレーションシップ、ビジネス不変条件をカバーし、ジョブが実行されたかどうかだけでは評価しません。
重要なデータセットは所有者、ドキュメント、サービス期待値、発見性、サポート、利用者を持つプロダクトとして扱います。系統はソースフィールドを変換経由でレポートに結びつけ、変更影響やインシデント調査を迅速にします。データがコピーされる際はアクセスポリシーを伝播または再評価すべきです。
ウェアハウスプログラムは、ストレージ容量が増えることではなく、意思決定がより信頼性と迅速さを得たときに成功します。未使用テーブルを廃止し、クエリとストレージコストを公開し、機密アクセスを見直し、チームがプライベートなスプレッドシートを維持する代わりにガバナンスされた指標を信頼・再利用しているか測定します。
実例:販売分析ウェアハウスの設計
事実粒度を「完了した注文行1件」と定義し、サロゲートキーで製品、顧客、チャネル、プロモーション、地域、日付の次元と結びつけます。注文ステータスイベントはスナップショットとトランザクションを混在させず、別のファクトテーブルに保持します。収益、数量、割引、税金、コストは明示的な通貨、返品、キャンセル、認識ルールが必要です。指標定義はダッシュボード、ノートブック、財務調整で同一の結果を出すべきです。
取り込みはソースの変更を捕捉し、不変の生データを着地させ、スキーマを検証し、テスト済みのステージングと次元モデルへ変換します。遅延更新は事実を重複させず、適切な履歴期間を修正しなければなりません。行数と金額合計をソースシステムと比較し、一意性とリレーションシップをテストし、レポートフィールドからソースへの系統を記録します。バックフィルはバージョン管理されたコードと分離された検証を使用し、信頼されたテーブルに置き換える前に実行します。
アクセスは顧客識別子を広く利用可能な集計から分離し、役割と目的に応じた最小特権を適用します。ワークロード管理により、エグゼクティブ向けダッシュボードは応答性を保ち、アナリストは探索的クエリを実行できます。鮮度、テスト失敗、クエリコスト、未使用テーブル、セマンティック変更を監視します。ガバナンスされた指標が繰り返し可能な意思決定を支えるとき、ウェアハウスは成功です。所有権、品質、定義が未解決のままデータを集約するだけでは混乱が集中します。
ディザスタリカバリはバックアップ範囲、リージョン間コピー、カタログと権限の復元、許容できるデータ損失、復旧時間を明示すべきです。分離環境で復元テストを行い、ファイルだけでなく指標を検証します。暗号化キー、アイデンティティ設定、オーケストレーションコード、セマンティック定義は復旧可能なシステムの一部です。ペタバイト規模を復元できても、アクセスポリシーや信頼できる計算を再現できなければ、分析サービスは復旧していません。
実装チェックリスト
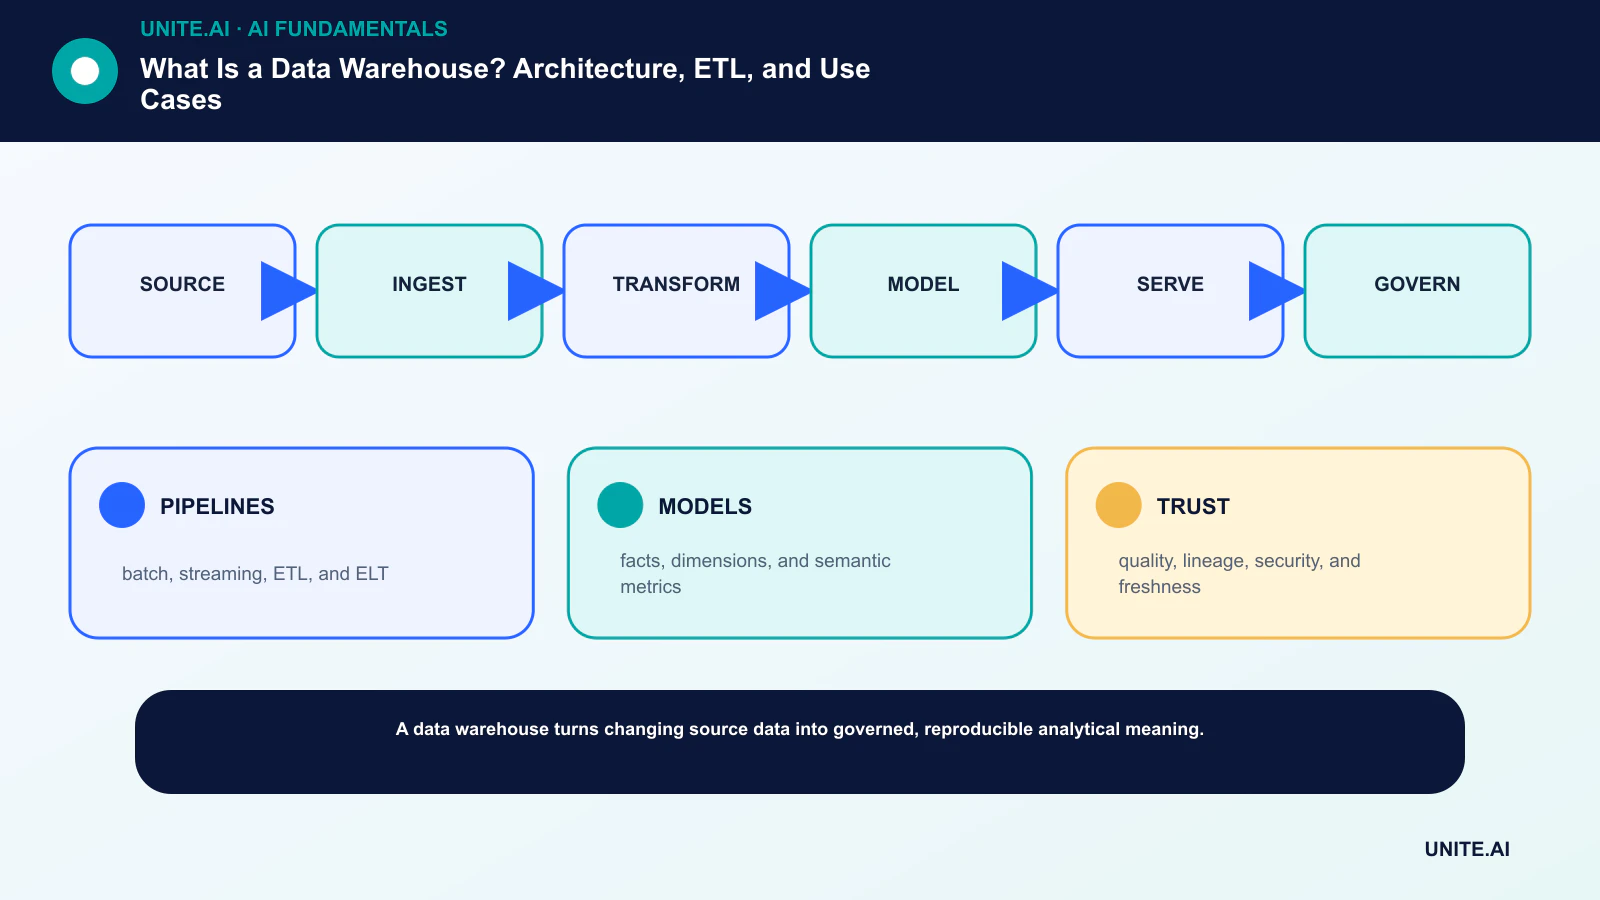
概念を範囲が限定されテスト可能なワークフローに変換します: source → ingest → transform → model → serve → govern。責任者を指名し、データと依存関係を文書化し、シンプルなベースラインを確立し、受け入れ基準と停止基準を設定し、代表的な失敗をテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し変更点を把握できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と文書化された準備状況レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保持します。リリース承認、閾値変更、出力上書き、運用停止を誰が行えるか定義します。実データが到着した後に判断を再検討します。技術的に成功したパイロットでも、規模拡大時の信頼できるパフォーマンスは保証されません。
- PIPELINES: バッチ、ストリーミング、ETL、ELT。
- MODELS: ファクト、ディメンション、セマンティック指標。
- TRUST: 品質、系統、セキュリティ、鮮度。
よくある質問
データウェアハウスは単なる大規模データベースですか?
それは統合された履歴分析を前提としたデータベースまたは分析プラットフォームです。そのモデリング、取り込み、ガバナンス、ワークロードパターンは取引処理アプリケーションのデータベースとは異なります。
企業は ETL と ELT のどちらを使用すべきですか?
多くの企業が両方を併用しています。プライバシー、検証、帯域幅が必要な場合は早期に変換し、ウェアハウスの計算リソースと迅速なイテレーションが有利な場合はロード後に変換します。
主要参考文献











