
AIの基礎
生成的敵対的ネットワーク(GAN)とは何か?

 Unite.AI を Google の優先ソースに追加
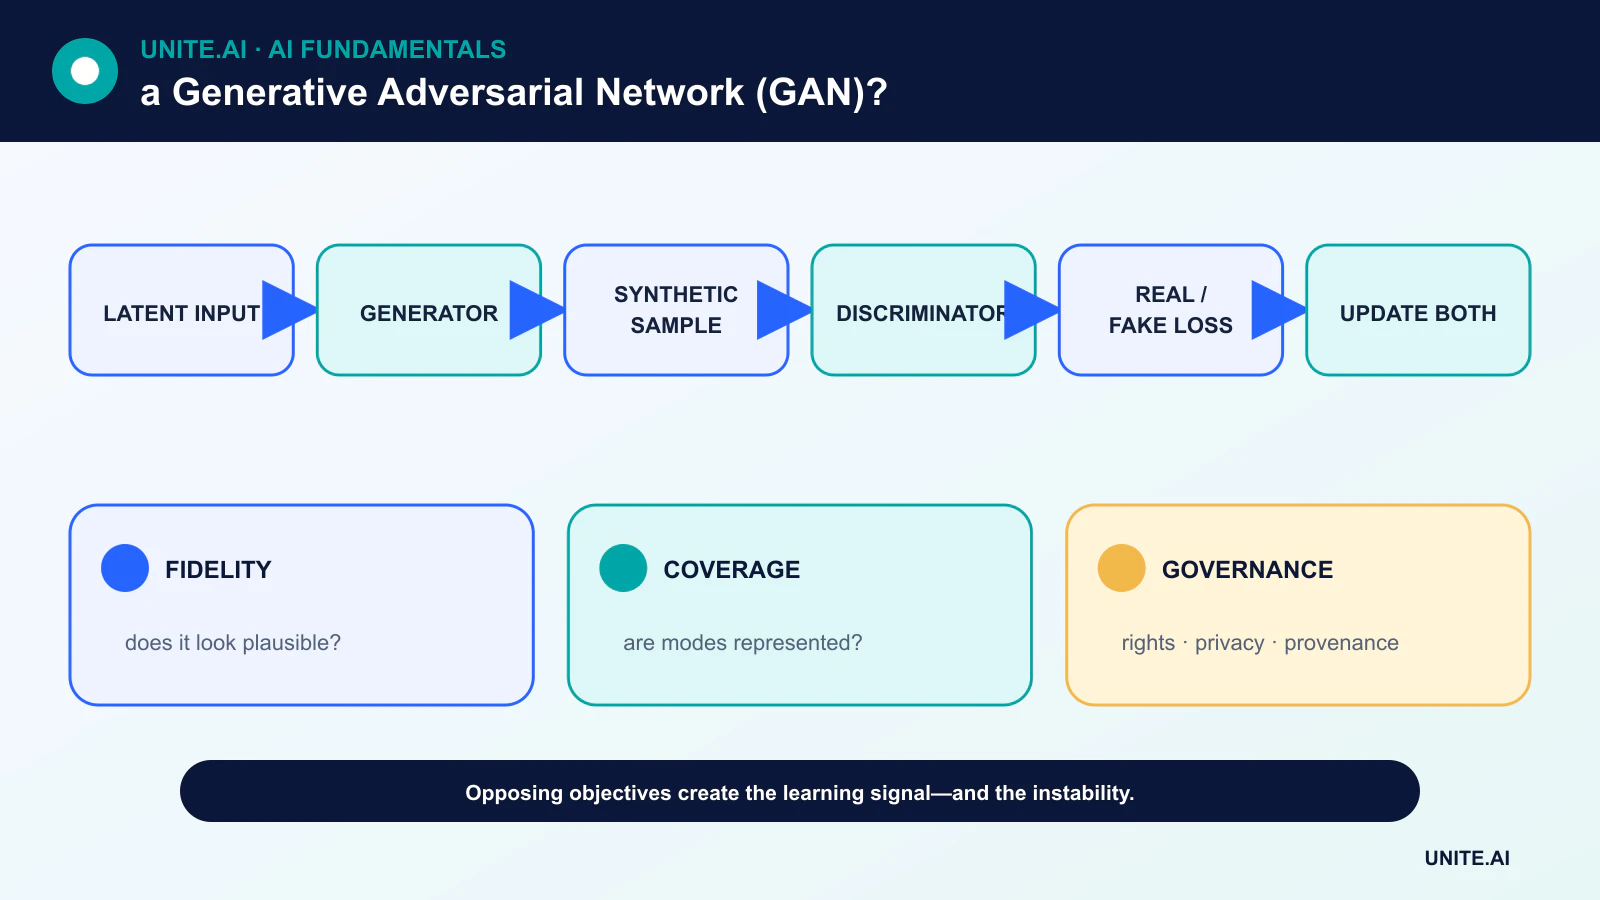
生成的敵対的ネットワーク(GAN)は、競合させる形で2つのニューラルネットワークを訓練します。ジェネレータはランダムまたは条件付けされた入力を合成サンプルに変換します。ディスクリミネータは生成されたサンプルと実際の訓練例を区別しようとします。各ネットワークのフィードバックが相手の学習課題を変化させます。
GANは鮮明な画像や制御可能な合成データを生成できますが、敵対的訓練は安定させるのが難しいです。視覚的にリアルであることは、多様性や事実的妥当性、訓練データ使用の許可を証明するものではありません。
重要なポイント
- ジェネレータはサンプルを生成し、ディスクリミネータは実サンプルと生成サンプルを区別する判定信号を学習します。
- 訓練は均衡を目指しますが、相手が変わると不安定化、振動、またはモード崩壊が起こり得ます。
- 条件付きGANはラベルやテキスト、その他のコンテキストを用いて生成を制御します。
- 評価は忠実度、カバレッジ、記憶性、下流リスクをテストすべきであり、画像品質だけで判断すべきではありません。
敵対的ゲーム
元々の定式化は2人プレイヤーのミニマックスゲームです。ディスクリミネータは実データと生成データを分離する能力を高め、ジェネレータはディスクリミネータが実と判定するサンプルを作る能力を高めます。両者は逆伝播で訓練されます。
ディスクリミネータが過度に正確になると、ジェネレータへのフィードバックが役に立たなくなることがあります。逆にディスクリミネータが弱すぎると、ジェネレータは簡単な抜け道を利用してしまいます。そのため訓練は交互に更新され、容量、損失、最適化設定を慎重にバランスさせます。
モード崩壊と訓練の安定性
モード崩壊は、多くの潜在入力が類似した出力を生むときに起こり、サンプルは妥当に見えてもデータ分布の一部しかカバーしません。他の失敗例として振動、勾配爆発、ランダム初期化への感度があります。
Wasserstein 目的、勾配ペナルティ、スペクトル正規化、アーキテクチャ変更、更新比率の調整などが安定性向上に寄与しますが、これらは多様性の検証や複数シードでの実験を省くものではありません。
条件付き生成と潜在制御
条件付き GAN はジェネレータとディスクリミネータにラベルやその他のコンテキストを与え、特定のクラスや属性をターゲットにした生成を可能にします。スタイルベースのアーキテクチャは異なる解像度で潜在制御の側面を分離し、非常にリアルな画像を生成しています。
潜在空間の方向は人間の概念と相関することがありますが、1つの属性を編集すると他の属性も変化することがあります。これは訓練データに相関した特徴が含まれるためです。制御性の主張は、多様な属性やコンテキストでテストすべきです。
評価、プライバシー、出所
Fréchet Inception Distance などの指標は特徴分布を比較しますが、特徴モデルの前提に依存し、記憶やサブグループの失敗を見逃すことがあります。最近傍分析、精度/再現率ベースのカバレッジテスト、人間によるレビューが補完的証拠を提供します。
GAN は稀な例を記憶したり、バイアスを再現したり、欺瞞的メディアを生成したりする可能性があります。チームはデータセット、権利、フィルタリング、透かしや出所管理、悪用防止策を文書化すべきです。合成データが自動的に匿名になるわけではありません。
GAN、VAE、拡散モデル
変分オートエンコーダー(VAE)は尤度ベースの潜在目的を最適化し、サンプルの鮮明さと構造化された潜在空間の間でトレードオフします。拡散モデルはノイズ付加過程を逆転させることを学習し、画像生成の一般的な基盤となっています。
高速なワンパスサンプリング、特定の画像間マッピング、コンパクトなデプロイが重要な場合、GAN は依然有用です。適切な手法は品質、多様性、レイテンシ、訓練安定性、ガバナンスに基づき選択すべきであり、最新のアーキテクチャかどうかで決めるべきではありません。
敵対的目的と訓練ダイナミクス
生成的敵対的ネットワークは、ジェネレータにサンプル生成を、ディスクリミネータに生成サンプルと実データの識別を学習させます。元のミニマックスゲームでは、ディスクリミネータは密度比に関連する信号を推定し、ジェネレータはそれを騙そうとします。訓練は交互に更新され、各ネットワークは固定された損失ではなく変動する相手に対抗して学習します。ディスクリミネータが強すぎるとジェネレータの勾配が役に立たなくなり、弱すぎると生成品質が停滞します。損失値だけではサンプル品質と直接対応しません。
モード崩壊は、ジェネレータがディスクリミネータを騙す限定的なバリエーションしか生成しないときに起こります。振動、ハイパーパラメータへの感度、不安定な正規化も一般的です。Wasserstein 目的、勾配ペナルティ、スペクトル正規化、特徴マッチング、ミニバッチ統計、慎重にバランスされた更新スケジュールがそれぞれの失敗メカニズムに対処します。条件付き GAN はラベル、テキスト、画像を用いて出力を誘導し、スタイルベースのアーキテクチャは潜在的影響を分離します。データセットの品質とカバレッジは根本的に重要で、ジェネレータは見た分布を再現・再構成します。
評価と責任ある利用
忠実度と多様性は別々に評価すべきです。Fréchet Inception Distance は特徴分布を比較しますが、サンプルサイズ、特徴モデル、前処理、ドメインに依存します。Inception Score は実データとの比較を省きます。生成モデル向けの精度・再現率、最近傍分析、記憶チェック、人間タスク評価が証拠を補強します。科学や医療の合成ではドメイン固有指標と下流検証を使用してください。保持用の実データセットを確保し、拡散モデルや自己回帰ベースのベンチマークと同等の計算リソースと解像度で比較します。
GAN はデータ増強、ドメイン変換、超解像、メディア合成、シミュレーション支援に利用できますが、合成データはバイアスを増幅したり訓練例を漏洩したりする恐れがあります。ライセンス、同意、身元、出所を確認し、非合意的ななりすましや欺瞞的利用から保護し、必要に応じて出力にラベルや署名を付与し、生成メタデータを保持してください。フォトリアルな画像は文書証拠ではなく、意思決定に影響する際は不確実性と合成であることを明示すべきです。
デプロイと再現性
ジェネレータ、ディスクリミネータ、オプティマイザ、データセット、ランダムシード、トランケーション、サンプリング設定を記録します。量子化やエクスポートは正規化や出力を変える可能性があるため、提供アーティファクトを検証してください。プロンプトや条件分布、安全フィルタ、出力多様性、レイテンシ、レポートを監視し、公開システムではレートリミットと身元保護を実装します。GAN 訓練は結合最適化実験であり、選択されたショーケース画像だけでロバスト性、カバレッジ、記憶欠如を証明できません。モデルは意図された生成タスク全体の分布で評価すべきです。
実例:GAN を用いた合成欠陥画像
あるメーカーは稀少な表面欠陥画像を生成する条件付き GAN を訓練します。訓練画像の権利を確認し、製造ロットを分割して訓練と評価を行います。生成サンプルは最近傍記憶、欠陥形状、背景アーティファクト、多様性、専門家の妥当性でチェックされます。合成増強で訓練した分類器は、従来の増強と同じ分類器で独立した実欠陥のみを用いて評価されます。
合成データは、実世界の再現率が向上し、偽陽性やサブグループエラーが増えなければ受け入れられます。生成設定と出所情報はすべての画像に付与され、合成ファイルがテストセットや証拠アーカイブに実検査として混入することはありません。オペレーターがジェネレータを使って監査記録を捏造することはできません。チームは拡散モデルの代替案と、より多くの実例を収集するコストを比較し、見た目がリアルでも GAN が物理的な故障プロセスを捕捉した証明にはならないことを認識します。
実装証拠と運用準備性
単なるデモ成功だけでは実装判断に不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、各重要障害の結果を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、欠損入力、分布シフト、依存障害、誤用、過小サービス化が予想されるグループや環境をテストします。タスク品質と同時にキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティを測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の介入、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、無効化または置換の明確なタイミングも文書化する必要があります。
よくある質問
GAN は生成した画像を理解していますか?
GAN は生成に有用な統計構造を学習しますが、これだけで人間のような意味的・因果的理解があるとは言えません。
GAN で生成したサンプルは訓練データとして安全に使用できますか?
カバレッジ、ラベルの妥当性、記憶性、バイアス、そして合成分布が実際の保持テストセットで有益かどうかを確認した後でのみ安全です。
主要参考文献












