
AIの基礎
バックプロパゲーションとは何か?

 Unite.AI を Google の優先ソースに追加
バックプロパゲーションは、ニューラルネットワークの損失が学習可能パラメータに対してどのように変化するかを計算するアルゴリズムです。フォワードパス中に記録された演算に対して、微分の連鎖律を逆方向に適用します。
バックプロパゲーションは勾配を計算しますが、更新そのものは決定しません。確率的勾配降下法や AdamW などの最適化手法が、これらの勾配を用いて重みやバイアス、その他の学習可能パラメータを変更します。
主なポイント
- フォワードパスは中間値を構築し、予測を生成します。
- 損失関数は予測と目標をスカラーの学習目的に変換します。
- バックプロパゲーションは局所的な導関数と連鎖律を用いて、パラメータ勾配を効率的に算出します。
- 最新のフレームワークは計算グラフ上で逆モード自動微分を実装しています。
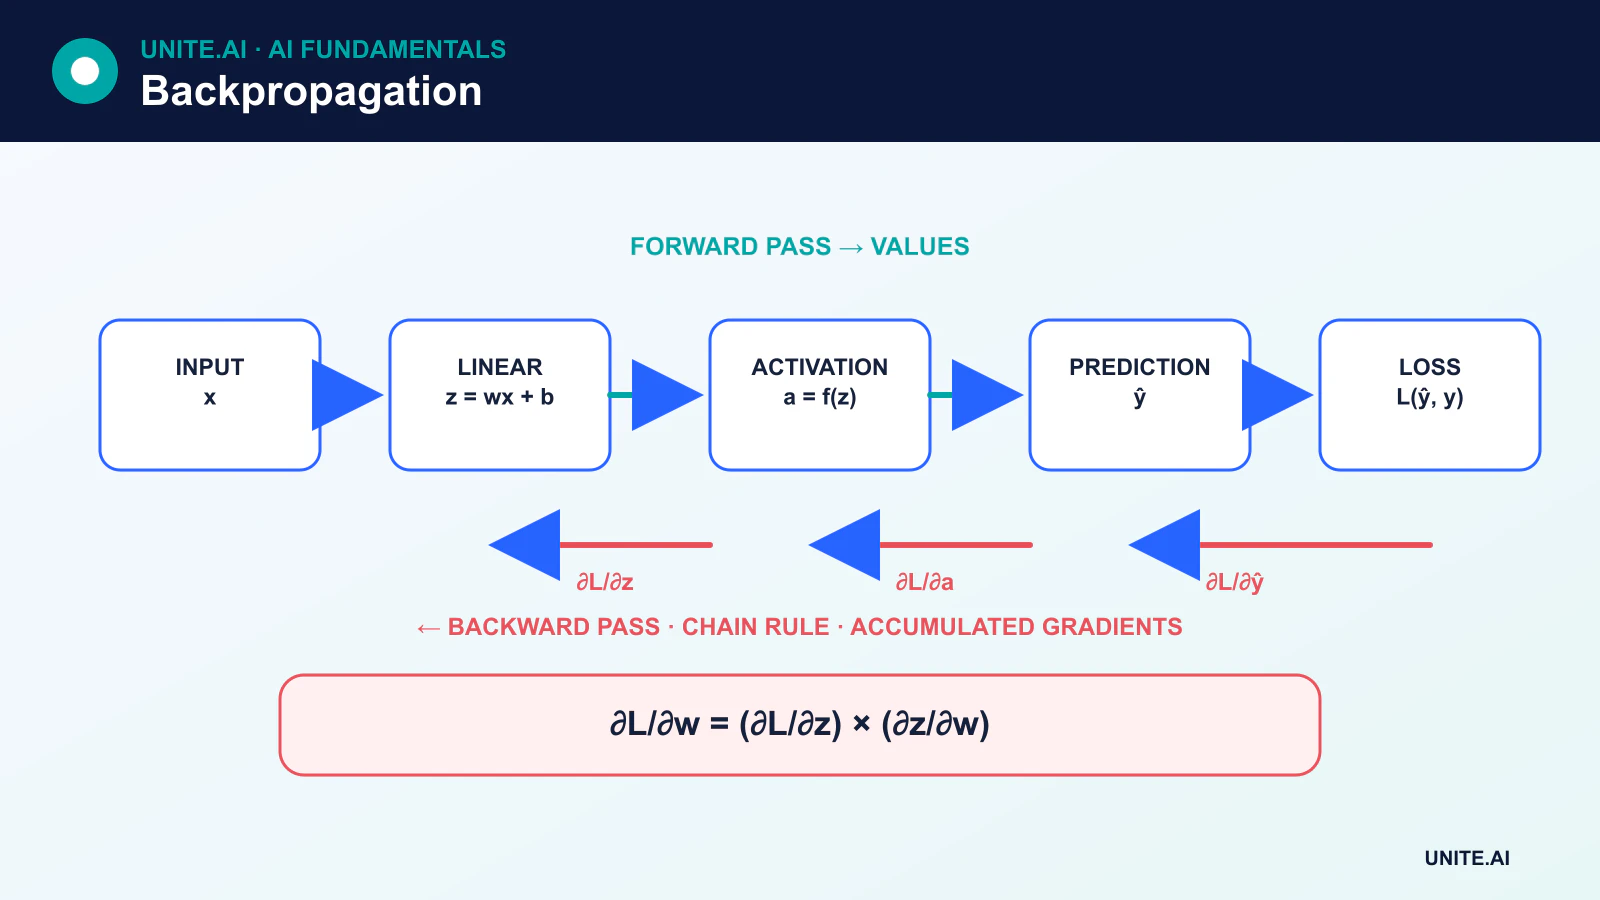
フォワードパス
単純なユニットを考えてみましょう:
z = wx + bŷ = activation(z)
入力は x で、w と b は学習可能な重みとバイアスです。バイアスは通常、重みと同様に学習中に変化します。ネットワークはこのような演算を多数組み合わせ、正規化、アテンション、畳み込み、残差接続、その他の微分可能ブロックを加えます。
フォワードパスはこれらの演算を評価し、予測を生成します。クロスエントロピーや平均二乗誤差といった損失関数が目的関数を測定します。最適な損失はタスクや出力の解釈に依存します。
連鎖律
損失 L が中間値 z に依存し、z がパラメータ w に依存する場合、連鎖律は次のように表せます:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
深層ネットワークは多数の経路を持ちます。バックプロパゲーションは計算グラフを逆方向にたどり、ある値が複数の経路を通って損失に影響を与える場合に寄与を蓄積します。その結果、フォワード計算に参加したすべての学習可能パラメータについて勾配が得られます。
小さな数値例
例えば ŷ = wx + b とし、x = 2、w = 3、b = 1 とします。予測は 7 です。目標が 5 で、損失を L = ½(ŷ - y)² とすると:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
この勾配を用いて w と b を負の勾配方向に更新できます。この式は選択した線形ユニットと二乗誤差損失に特化したものであり、汎用的なバックプロパゲーション則は実際のグラフ上の連鎖律であり、固定された「誤差」方程式ではありません。
バックプロパゲーションと勾配降下法の比較
勾配降下法は最適化手法です。バックプロパゲーションはそのために必要な勾配を提供します。典型的な学習ステップは次のように進みます:
- 蓄積された勾配をクリアまたはリセットする。
- フォワードパスを実行する。
- 損失を計算する。
- バックワードパスを実行する。
- 最適化器でパラメータを更新する。
これらの概念を分離することで、モメンタム、AdamW、勾配の蓄積、混合精度学習などを理解しやすくなります。
自動微分
PyTorch などのフレームワークは演算を記録し、フォワードパス中にグラフを構築します。逆モード自動微分は、出力からパラメータへ向かってベクトル・ヤコビ積を効率的に計算します。これは固定ネットワークに対して手作業で導関数を実装するよりも汎用的で、現代の深層学習フレームワークの基盤となっています。
一部の演算は微分不可能であったり、導関数が不安定だったりします。フレームワークはサブグラディエントや特定ケースでの慣例を定義しますが、実務者はテンソルのデタッチ、インプレース演算、数値精度について依然として理解しておく必要があります。
勾配の消失と爆発
多数の層や時間ステップを通した掛け算により、勾配が極端に小さく(消失)または大きく(爆発)なることがあります。勾配の消失は浅い層の学習を遅らせ、勾配の爆発は更新を不安定にします。ReLU 系列の活性化関数、注意深い初期化、残差接続、正規化、ゲート付き再帰、勾配クリッピングなどが対策となりますが、万能な解決策は存在しません。
勾配のチェック
有限差分による勾配チェックは、解析的または自動的に得られた勾配と数値近似を比較します。計算コストは高いですが、カスタム演算のデバッグには有用です。勾配ノルムの監視や NaN・無限大の検出は、学習中の不安定性を明らかにします。
計算グラフにおける連鎖律
バックプロパゲーションはスカラー損失に対するすべての微分可能パラメータの勾配を効率的に計算します。フォワードパスは計算グラフに中間値を記録します。損失から開始し、逆モード自動微分が連鎖律を適用し、局所導関数を掛け合わせ、経路が交差する箇所で寄与を蓄積します。層 y = f(x, w) に対して、上流からの感度が y に対して伝播し、部分導関数と組み合わせて x と w の感度を生成します。バックプロパゲーションは勾配を計算し、最適化器がパラメータの変化を決定します。
単純なアフィン層は y = Wx + b を生成します。W の勾配は上流勾配と入力の外積、b の勾配は上流値の総和、入力勾配は転置重み行列との積となります。活性化は要素ごとの導関数を加えます。畳み込み、正規化、アテンション、再帰も同様のグラフ原理に従いますが、テンソル形状、ブロードキャスト、マスク、パラメータ共有に注意が必要です。フレームワークはバックワード後に保存された活性化を解放します(保持しない限り)。そのため、メモリ使用量はバッチサイズ、深さ、シーケンス長に比例して増加します。
勾配の失敗、検証、そしてエンジニアリング実務
多数の導関数の積は消失または爆発し得ます。ReLU 系列の活性化、注意深い初期化、正規化、残差接続、ゲーティング、勾配クリッピングはそれぞれ異なるメカニズムに対処します。飽和した活性化や微分不可能な演算は有用な信号を遮断し、切り捨てバックプロパゲーションはシーケンス履歴を制限し、混合精度はロススケーリングなしではアンダーフローを起こすことがあります。勾配の爆発は症状の一つであるため、クリッピングは学習率、データ、アーキテクチャ、数値誤差の調査と併せて行うべきで、問題を隠す手段にすべきではありません。
カスタム演算は、小規模な倍精度入力に対して有限差分勾配チェックを行い、意図的に微分不可能な点を除外して検証します。形状、ブロードキャスト、パディング、複素数から実数への変換は別個のケースとして扱います。パラメータが再利用される場合の累積勾配を検証し、マスクされた音声フレームが勾配を生成しないことを確認します。
実例:カスタムニューラル層の検証
エンジニアが音声ネットワーク向けの微分可能なスペクトル層を実装します。倍精度の小規模テストで、入力とパラメータに対する自動勾配を中心差分と比較し、演算が意図的に微分不可能な点は除外します。形状、ブロードキャスト、パディング、複素数から実数への変換をそれぞれ個別に検証します。また、パラメータが再利用される場合に勾配が正しく累積されること、およびマスクされた音声フレームでは勾配が発生しないことを確認します。
学習中はダッシュボードで勾配・活性化ノルム、NaN、非活性パラメータ、ロススケーリングを追跡します。意図的に破損させたバッチで検証が非有限出力を検出すれば、最適化器更新前に問題が捕捉されます。混合精度とエクスポート実装は参照実装と比較されます。チェックポイント再開テストは最適化器状態とランダム順序を含みます。総損失が減少しただけで層が受け入れられるわけではなく、単位勾配、数値安定性、下流の汎化が一貫した証拠を提供する必要があります。
実装の証拠と運用準備
単なるデモの成功だけでは実装判断に不十分です。対象ユーザー、運用環境、入出力、依存関係、所有者、重要な失敗ごとの影響を明確に定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、過小評価されやすいグループや環境をテストします。タスク品質を校正・不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現できるようにし、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは入力品質、出力挙動、モデルまたはルールのバージョン、依存健康状態、人間によるオーバーライド、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わった際は再評価が必要です。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化しておく必要があります。
よくある質問
バックプロパゲーションは重みを更新しますか?
バックプロパゲーションは勾配を計算します。最適化器がその勾配、学習率、そしてモメンタムや適応モーメントといった状態を用いて更新を適用します。
バックプロパゲーションは生物学的に現実的ですか?
標準的なバックプロパゲーションは工学的アルゴリズムであり、生物学的脳における学習の詳細なモデルとしては受け入れられていません。歴史的な神経類似性は生物学的等価性として扱うべきではありません。
主要参考文献












