
AIの基礎
次元削減とは何か?

 Unite.AI を Google の優先ソースに追加
次元削減は、タスクに有用な情報を保持しながら、変数を減らしてデータを表現します。ストレージやノイズを削減し、可視化を改善し、冗長な特徴を緩和し、下流のモデルの学習を容易にします。
どの手法もすべての関係性を保持できるわけではありません。有用な削減は、何を残すべきかを明示することから始まります: 分散、クラス分離、局所近傍、全体的な形状、再構築品質、あるいは解釈可能性などです。
主なポイント
- 特徴選択は元の変数を保持し、特徴抽出は新しい低次元座標を作成します。
- PCAは線形で分散重視、t‑SNEとUMAPは可視化のために近傍構造を強調します。
- 可視化の埋め込みは、距離やクラスタサイズ、全体的な分離を歪める可能性があります。
- 削減は訓練データのみに適合させ、学習した変換を検証データとテストデータに適用します。
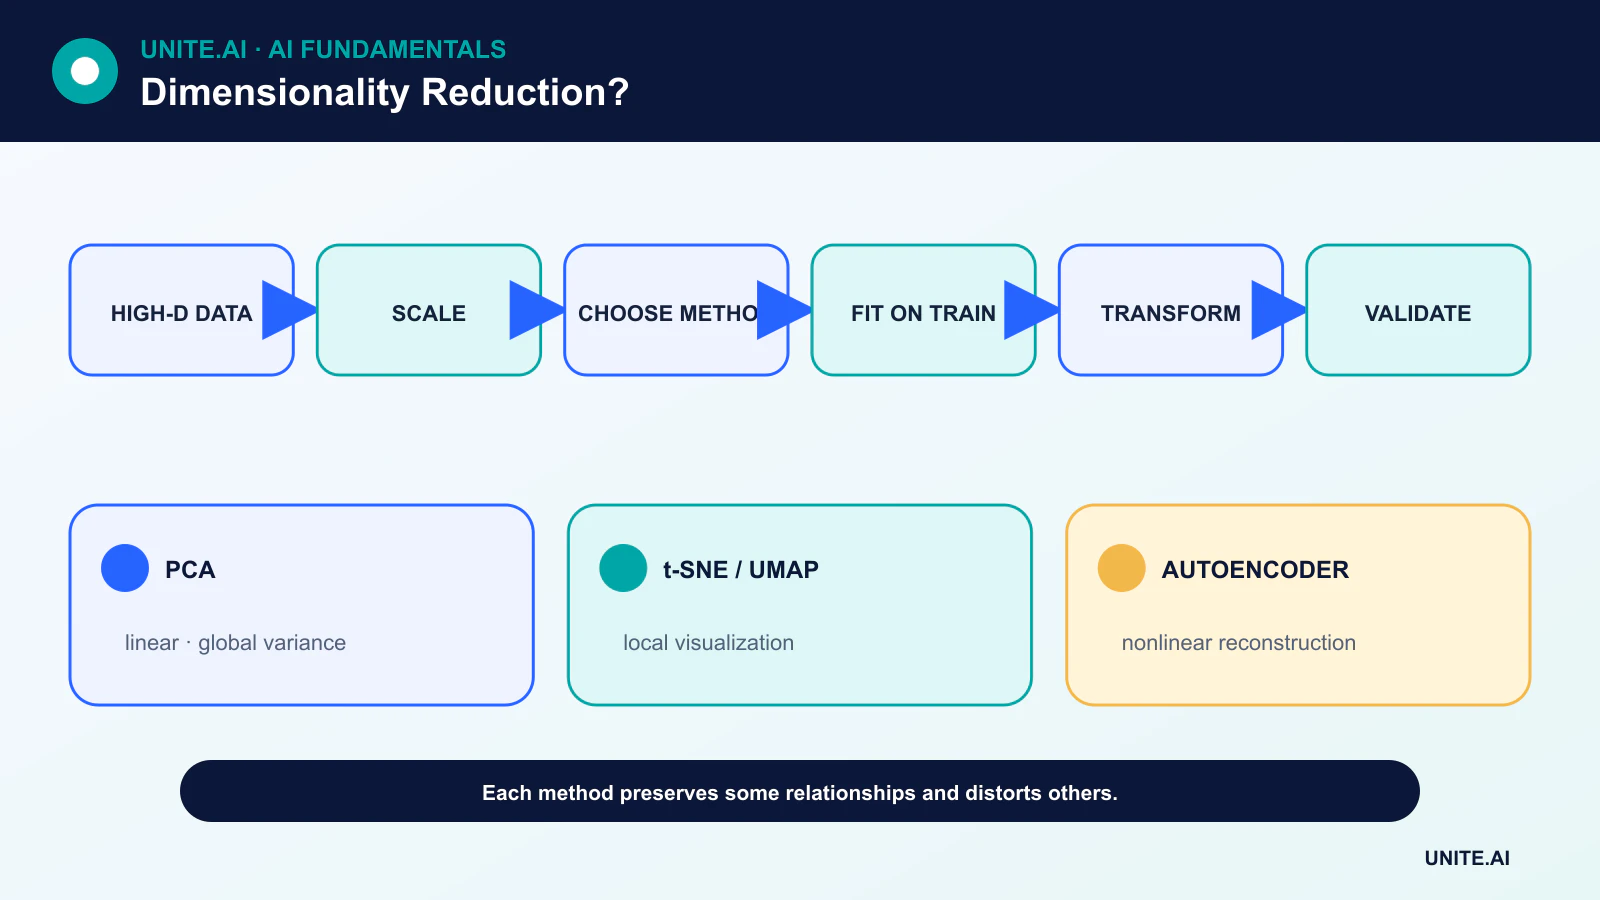
特徴選択と射影の比較
特徴選択は、ドメインルール、欠損、冗長性、予測テスト、または正則化を用いて変数を除去します。元の意味を保持するため、ガバナンスや説明に役立ちます。
射影手法は変数を新しい座標に結合します。分散した構造を捉えることができますが、各座標の解釈が難しくなることがあります。オートエンコーダは再構築を通じて非線形射影を学習します。
PCA と SVD
主成分分析は、データを中心化した後、分散が減少する直交方向を特定します。特異値分解は一般的な数値的手法を提供します。スケーリングは重要です: 高分散の測定単位が成分を支配する可能性があります。
PCAは符号や重複固有値を除き決定的で、サンプル外変換をサポートし、説明分散の概要を提供します。高い分散が必ずしもタスクに関連するわけではなく、線形成分だけでは曲がった多様体をすべて展開できません。
t‑SNE と UMAP
t‑SNEは近傍に対する確率分布を構築し、局所的類似性を強調した低次元マップを最適化します。UMAPは重み付き近傍グラフを構築し、関連する局所構造を目指した低次元表現を最適化します。
どちらも強力な探索ツールですが、前処理、距離指標、ハイパーパラメータに敏感です。2次元プロットにおける空白領域、クラスタ面積、クラスタ間距離は、実世界の解釈を自動的に与えるべきではありません。
教師あり手法とタスク認識表現
線形判別分析はクラスラベルを用いて分離を追求し、教師なしのPCAとは異なります。ニューラル表現学習は、再構築ではなく予測やコントラスト目的を最適化できます。
ラベルが削減を導く場合、すべてのフィッティングとチューニングは訓練プロセス内に留める必要があります。そうしないと、テストセットの情報がモデル選択に漏れ、楽観的な結果を生む可能性があります。
手法の選択と検証
まず前処理とシンプルなベースラインから始めます。圧縮の場合、次元ごとの再構築誤差や下流タスクの性能を測定します。可視化の場合、シードやハイパーパラメータに対する安定性をテストし、近傍保持をドメイン知識と比較します。
本番環境では、手法が新しいレコードを変換できるか、欠損値をどのように扱うか、再訓練時に変化するか、ユーザーが元の特徴の説明を必要とするかを確認します。過学習は、最終モデルと同様に削減ステップでも発生し得ます。
線形および非線形削減手法
次元削減は、高次元データを選択された構造を保持しつつ、より少ない座標へマッピングします。主成分分析は中心化後、最大分散の直交方向を見つけ、単位が同等に寄与すべき場合はスケーリングが必要です。特異値分解は関連する低ランク構造を計算し、スパース行列をサポートします。線形判別分析はラベルを用いてクラス分離方向を見つけます。これらの手法は明示的な変換を提供しますが、分散やクラス分離が下流タスクに必要な情報を保持できないことがあります。
t‑SNEやUMAPといった多様体手法は近傍を構築し、低次元レイアウトを最適化します。探索には強力ですが、全体的な距離、密度、クラスタサイズ、時には分離を歪めます。結果は前処理、距離指標、近傍数やパープレキシティ、初期化、シードに依存します。離散的なグループがなくても、二次元で魅力的なクラスタが現れることがあります。複数の設定を使用し、フィッティングに使われていないメタデータでのみ色付けし、元空間や独立ラベルで構造を検証してください。
特徴選択、埋め込み、評価
特徴選択はフィルタ、ラッパー、またはモデルベースの重要度を通じて元の変数を保持します。表現学習はオートエンコーダや教師ありモデルを用いて新たな潜在特徴を生成します。ランダム射影は特定の条件下で距離を近似的に保持し、効率的なベースラインを提供します。圧縮、可視化、ノイズ除去、速度、ストレージ、モデル性能の観点から手法を選択してください。削減器は訓練データのみに適合させ、検証・テストデータに変換を適用します。教師あり削減はラベル漏れを防ぐため、交差検証内にネストする必要があります。
線形圧縮では説明分散や再構築を、可視化では信頼性と近傍保持を、予測では下流の精度、キャリブレーション、レイテンシ、ロバスト性を評価します。サンプルやシード間の安定性を測定します。希少クラスやセンシティブなグループが圧縮で失われていないか、逆変換が可能かを検査してください。削減された座標は依然としてプライベート情報を含む可能性があり、二次元プロットは匿名化ではありません。変換、スケーラ、特徴順序、制限事項を文書化してください。
本番での利用
サービス提供には、正確に適合した変換と入力スキーマが必要です。欠損特徴、範囲シフト、成分スコアの分布、再構築誤差、下流の結果をモニタリングします。新しいカテゴリやセンサーが出現した場合、静かに列を追加するのではなく、パイプライン全体を再訓練しバージョン管理してください。削減は計算コストを削減しモデルのノイズ除去に寄与しますが、希少イベントに重要な弱いシグナルを失うこともあります。保持された情報と失われた情報を意思決定に対して検証すべき学習済み測定ステップとして扱います。
実例:顧客行動特徴の削減
アナリストは200の行動指標を標準化し、訓練顧客データのみに対してPCAを適合させます。クロスバリデーションは、二次元散布図ではなく、下流の解約予測性能と安定性に基づいて成分数を選択します。ロードゥィングは支配的な要因や欠損を検査します。PCA、特徴選択、ランダム射影、そして非削減の正則化モデルを、キャリブレーション、レイテンシ、希少顧客セグメントの結果で比較します。繰り返しサンプルにより、主要成分と下流結論が安定しているかもテストします。
展開されたパイプラインは特徴の順序、スケーラ、成分を固定し、欠損したスキーマバージョンは受け付けません。モニタリングは成分分布、再構築誤差、下流の結果を追跡します。見かけ上のクラスタを持つ可視化は質問を生成するために使用され、顧客ペルソナを割り当てるためではありません。潜在成分が依然として行動をエンコードしているため、アクセスと保持は管理下にあります。ソース定義が変更された場合、古い成分に互換性のないデータを投影するのではなく、完全な変換とモデルを再構築し検証します。
実装の証拠と運用準備
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健康状態、人間の介入、確認済み結果を明らかにすべきです。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せず、展開後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されるシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントを文書化する必要があります。
よくある質問
次元削減は常にモデルを改善しますか?
いいえ。予測に必要な情報が失われたり、解釈が複雑になることがあります。保持データ上で削減なしのベースラインと比較してください。
分離した t‑SNE クラスタは実際のクラスが存在することを証明しますか?
いいえ。このマップは近傍関係の最適化された可視化であり、見かけ上の分離を生むことがあります。クラスタは独立した証拠で検証してください。
主要参考文献












