
AIの基礎
強化学習とは何か?

 Unite.AI を Google の優先ソースに追加
強化学習 (RL) は、エージェントが環境と相互作用しながら行動を学習する機械学習の枠組みです。各行動の後に環境が変化し、報酬が返されることがあります。エージェントの目的は、次の一手の報酬だけでなく、期待される累積報酬を最大化する方策を学習することです。
RL は、意思決定が時間を通じて展開し、ある行動が次に起こる事象に影響を与える場合に使用されます。これは、データセットが各学習例に対して正解を提供する 教師あり学習 とは概念的に異なります。
重要なポイント
- RL の問題は、エージェント、環境、状態、行動、報酬、そして方策で構成されます。
- 正の強化も負の強化も行動を増加させますが、罰は行動を減少させます。
- エージェントは、未知の行動を探索することと、既に有効と分かっている行動を活用することのバランスを取らなければなりません。
- 価値ベース、方策ベース、アクター・クリティック、モデルベース、オフラインの各手法は、異なる RL の設定に対応します。
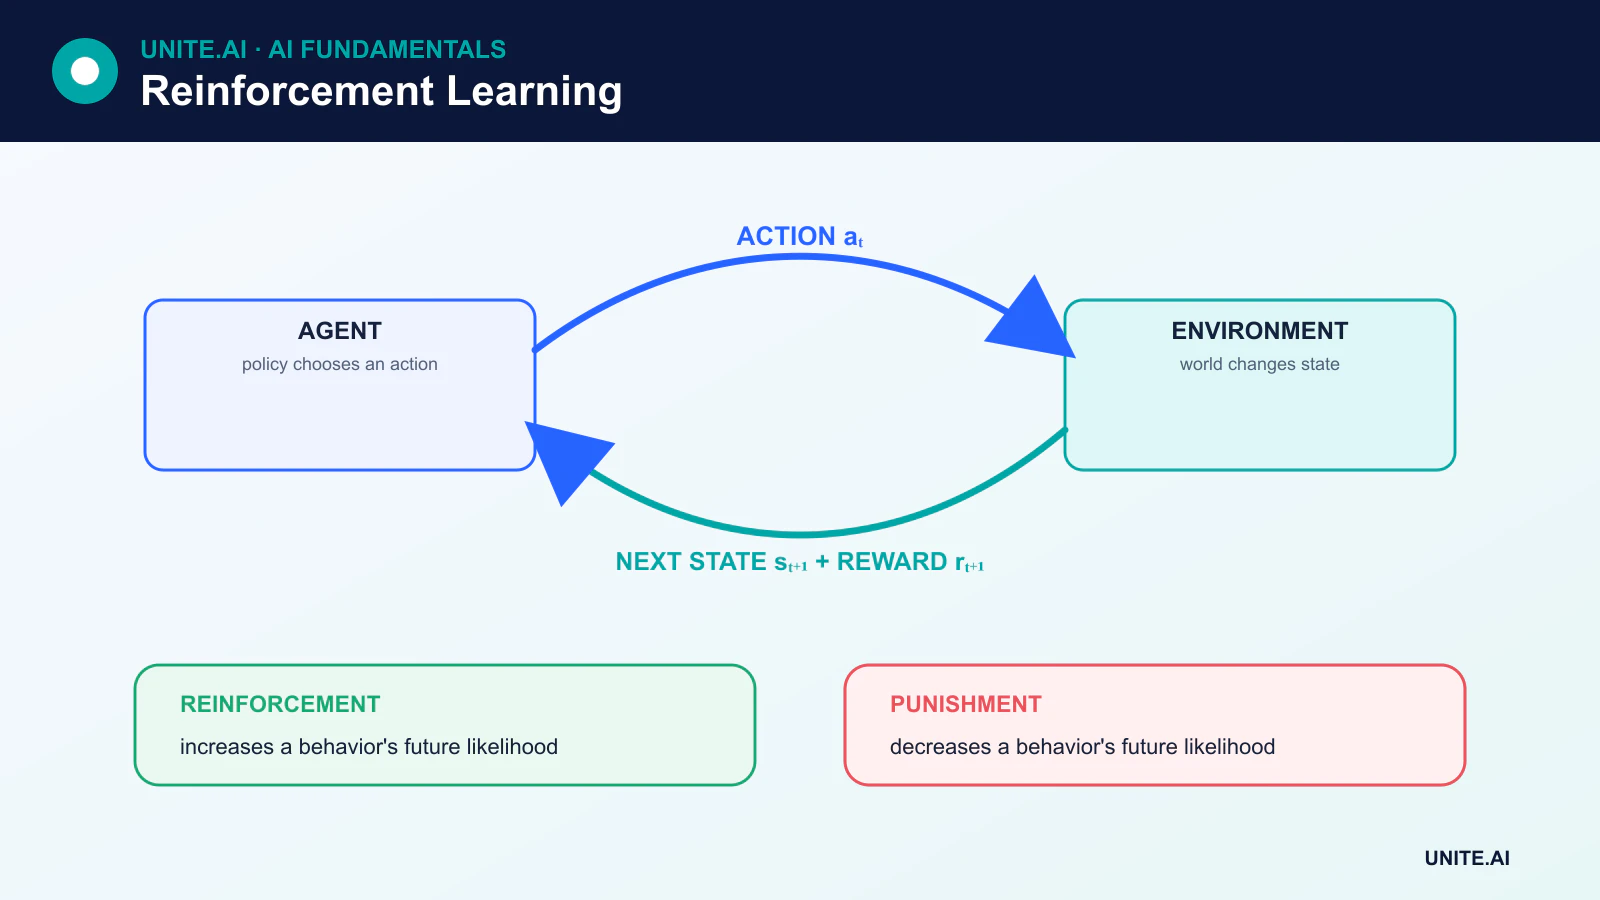
強化学習の構成要素
多くの RL 問題は マルコフ決定過程 (MDP) としてモデル化されます。MDP には以下が含まれます:
- 状態: 現在の状況を記述する情報。
- 行動: エージェントが選択できる選択肢。
- 遷移: 行動後に状態がどのように変化するか。
- 報酬: 遷移によって生じる即時のフィードバック。
- 方策: エージェントが行動を選択する戦略。
- 割引率: 将来の報酬が即時の報酬に対してどれだけ重視されるか。
状態は世界のすべてを公開する必要はありません。重要な情報が隠されている場合、問題は部分観測可能となり、エージェントはメモリや信念状態を必要とすることがあります。
強化は罰と同じではない
この用語は行動心理学に由来します。正の強化 は、行動の発生確率を高める結果を付加します。負の強化 は、不快な状態を除去し、同様に行動の発生確率を高めます。行動の発生確率を下げることを目的とした罰は、負の強化ではなく罰です。
機械学習においては、実務者は正の報酬、負の報酬、コスト、罰則について直接言及することが多いです。重要なのは、これらのシグナルがエージェントが最大化しようとするリターンにどのように影響するかです。
リターン、価値、そして帰属問題
報酬は 1 回の遷移を記述します。リターン は時間を通じて報酬を合算し、通常は将来遠くに到達する報酬を割引します。状態価値関数 はある状態から期待されるリターンを推定し、行動価値関数 はその状態で特定の行動を取った後の期待リターンを推定します。
これが帰属問題を生み出します: 有用な結果がかなり後に現れた場合、どの早期の行動に功績を帰すべきかです。RL アルゴリズムはこの関係を推定する方法が異なります。
モンテカルロ法と時間差分学習
モンテカルロ法 は、エピソード終了後に得られる完全なサンプルリターンから学習します。時間差分 (TD) 法 は、観測された報酬と次に来るものの推定を組み合わせて、最終結果が出る前に推定値を更新します。したがって、TD 学習は現在の価値推定からブートストラップします。
どちらの手法も万能に優れているわけではありません。モンテカルロの目標はサンプルされた方策の下でバイアスがなく、しかし分散が大きくエピソードの完了が必要です。TD 法はオンライン学習や継続タスクから学習可能ですが、ブートストラップされた目標はバイアスを導入します。
探索と活用のトレードオフ
探索 は、価値が不確かな行動を試すことで情報を収集します。活用 は、現在最も高いリターンをもたらすと信じられる行動を選択します。探索を全く行わないエージェントは劣った戦略に甘んじ、活用を全く行わないエージェントは学んだことから利益を得られません。
シンプルな戦略としては、ε‑greedy 行動選択、信頼度に基づく探索、エントロピー報酬、内在的報酬手法などがあります。安全性が重要な設定では、無制限の探索は受け入れられないことがあるため、シミュレーション、制約、オフラインデータ、あるいは人間の監視が重要になります。
主要な強化学習アプローチ
価値ベース手法
Q 学習や関連アルゴリズムは行動価値を学習し、価値が高い行動を選択することで方策を導出します。深層強化学習 は、状態空間がテーブルで表すには大きすぎる場合に、価値関数や方策を近似するためにニューラルネットワークを利用します。
方策勾配法
方策勾配法は、パラメータ化された方策を直接調整して期待リターンを向上させます。連続的な行動や確率的方策に有用ですが、勾配推定の分散が大きくなることがあります。
アクター・クリティック手法
アクターは行動を選択し、クリティックは価値を推定して学習シグナルを提供します。これにより、直接的な方策最適化と価値推定が組み合わさります。
モデルベースとモデルフリーの RL
モデルベースのシステムは遷移と報酬のモデルを学習または利用し、計画を立てることができます。モデルフリーのシステムは環境を明示的にモデル化せずに価値や方策を学習します。モデルベース手法は経験を効率的に活用できますが、学習したモデルの誤差が計画を誤らせる可能性があります。
オフライン強化学習
オフライン RL は、トレーニング中に新たな相互作用を収集するのではなく、固定されたデータセットから学習します。これにより探索のコストやリスクを低減できますが、データで十分に表現されていない行動を過大評価しないようエージェントは注意が必要です。
RLHF と人間の好み
人間のフィードバックからの強化学習 (RLHF) は、好みデータを用いて報酬シグナルを学習するか、直接方策を最適化します。これは言語モデルの振る舞いを人間の判断と整合させるために利用されています。好みの最適化は真実や安全性を保証するものではなく、結果はフィードバックを提供した人物、評価対象、そして目的関数の設計に依存します。
制限事項
RL は膨大な数の相互作用を必要とし、学習中に不安定に振る舞い、報酬関数の意図しない抜け道を利用してしまうことがあります。評価はランダムシードや環境の詳細により結果が変わりやすく困難です。堅実な実践としては、複数回の実行、透明なベースライン、制約付き目的関数、分布外テスト、そして報酬ハッキングの監視が含まれます。
RL 問題の設計:状態、行動、報酬、そしてホライズン
強化学習は順次的な意思決定をモデル化します。環境は観測を生成し、エージェントは方策に従って行動を選択し、遷移により報酬と次の観測が得られます。マルコフ決定過程は、状態が将来の遷移と報酬を予測するために必要な情報を含むと仮定します。部分観測可能性がある場合は、メモリ、信念状態、あるいはリカレント表現が必要です。割引は遅延結果の重みを制御し、エピソード型タスクと継続タスクは異なるリターン定義を要します。状態や行動の設計が不適切だと、解決可能な目的でも学習できなくなることがあります。
報酬設計は行動を間接的に規定し、失敗の主要因となります。代理指標が悪用されることがあります: 速度に対して報酬が与えられると安全性が無視され、タスク完了時のみ報酬が与えられると学習シグナルが不足します。実際の要件に基づく制約や終了条件を追加し、報酬感度をテストし、意図しない戦略がないか軌跡を検査します。探索手法は情報収集と現在の知識の活用のバランスを取ります。オフポリシーデータはサンプル効率を向上させますが、行動方策と目標方策の不一致にはそれに適したアルゴリズムが必要です。
評価、シミュレーション、そして安全なデプロイ
価値ベース手法は状態や行動の期待リターンを推定し、方策勾配法はパラメータ化された方策を最適化し、アクター・クリティック手法は両方を学習します。モデルベース RL は遷移ダイナミクスを学習または利用して計画します。適切な手法は行動タイプ、データ、シミュレータの忠実度、ホライズン、安定性要件に依存します。ヒューリスティック、教師あり、制御理論のベースラインと比較します。学習曲線が最良の実行を選ぶのではなく、平均・最悪ケースのリターン、制約違反、サンプル効率、環境変化へのロバスト性、シード間の分散を評価します。
医療、金融、ロボティクス、インフラなどの分野ではオンライン探索が容認できないことがあります。可能な限りシミュレーションや記録データで訓練し、シミュレータと実世界のギャップを定量化し、未観測の行動はサポートがないためオフポリシー評価を慎重に行います。デプロイ時は行動、レート、リソース、稼働領域を制限し、重要な選択には人間の承認を組み込み、安全なコントローラやシャットダウン機構を提供します。エージェントはスコアを上げても本来の目的を損なう可能性があるため、報酬と実際の結果を同時に監視します。環境、方策、報酬が変化した後は再検証が必要です。
実例:強化学習によるエネルギー制御
建物管理者は温度、占有率、天候、機器状態、電力料金をモデル化し、行動は安全な設定値調整に限定します。報酬は快適性、エネルギー消費、需要料金、機器制約を組み合わせますが、実際の快適性違反は別途評価されるため、報酬最適化だけで問題を隠すことはできません。過去の制御やモデル予測制御がベースラインとなります。訓練は、天候のランダム化、センサーノイズ、機器効率を組み込んだ較正シミュレータを使用します。
建物に実際に影響を与える前に、方策はライブ観測に対して実行されますが、実際の制御は行いません。エンジニアは軌跡、制約マージン、休日、熱波、停電、センサー欠損時の挙動を検査します。デプロイ時は行動頻度と範囲を制限し、既存の安全コントローラを保持します。人間はいつでも介入可能です。モニタリングはエネルギーと快適性を同期間と比較し、介入を記録し、違反や予期せぬサイクル、モデル不一致が閾値を超えた場合はロールバックします。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、稼働環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式が不正または欠損した入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質を較正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に障害を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間の介入、確認された結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。オフライン性能が持続すると仮定しません。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されるシステムは、復旧手順、インシデントからの学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化する必要があります。
主要参考文献












