
AIの基礎
サポートベクターマシンとは何か?

 Unite.AI を Google の優先ソースに追加
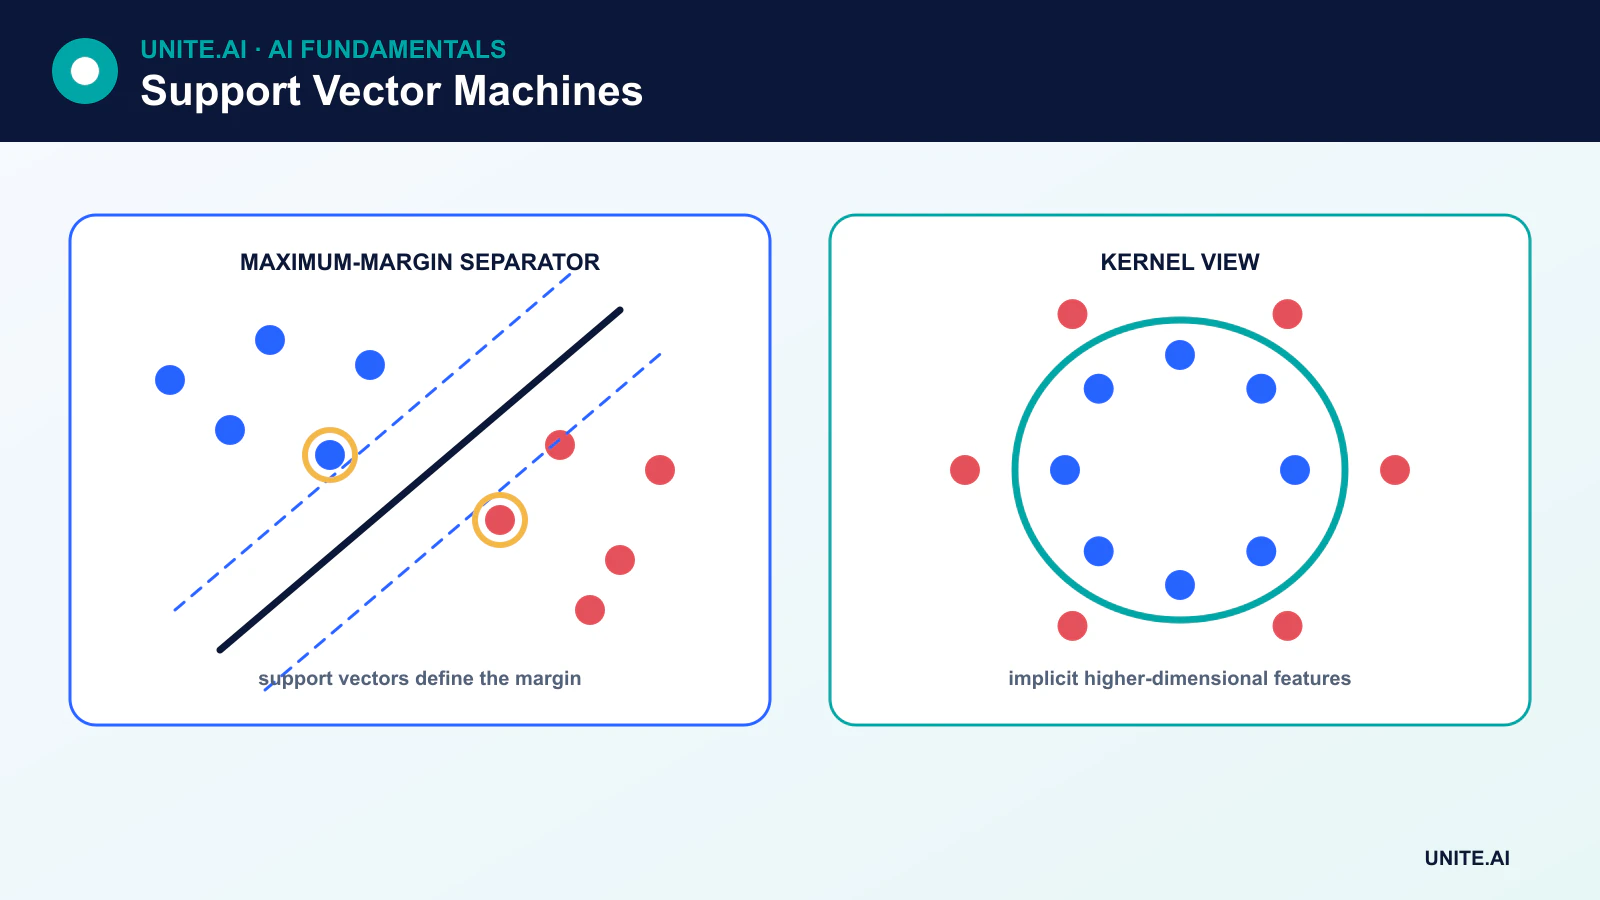
サポートベクターマシン (SVM)は、クラス間の可能な限り広いマージンを持つ決定境界を見つける教師あり学習手法です。その境界を決定する学習例はサポートベクターです。
SVMは線形または非線形の分類、回帰、そして新規性検出を行うことができます。特に、情報量の多い特徴を持つ小規模から中規模のデータセット(高次元のスパースデータを含む)に有用ですが、非常に大規模なデータセットでは学習コストが実用的でなくなることがあります。
重要なポイント
- SVMは境界と最も近い学習サンプルとの最小マージンを最大化します。
- サポートベクターはデータ点であり、追加のハイパープレーンではありません。
- パラメータCはマージン幅と違反に対するペナルティのバランスを取ります。
- カーネルは、すべての変換特徴を明示的に生成せずに、暗黙の特徴空間での類似度を計算します。
最大マージンの考え方
線形二値分類器において、決定境界はハイパープレーンです:
w · x + b = 0
ベクトル w が方向を、b がオフセットを決定します。トレーニングクラスを分離できるハイパープレーンは多数存在しますが、SVMは両側で最も近いサンプルまでの距離を最大化するものを選択します。その最も近いサンプルがサポートベクターであり、フィットされた境界に最も大きな影響を与えます。
目的は、境界と各点との距離を個別に最大化することではなく、クラス制約を満たす(または違反にペナルティを課す)中で最小マージンを最大化することです。
ハードマージンとソフトマージン
ハードマージンSVMは完全な線形分離を要求し、外れ値に敏感です。実際のデータセットでは通常、マージン内または境界の反対側にある観測に対してスラック変数を導入するソフトマージンが必要です。
ハイパーパラメータ C はこれらの違反に対するペナルティを制御します:
- C を大きくすると違反に対するペナルティが強くなり、トレーニング例により密着した狭いマージンが生成されやすくなります。
- C を小さくすると、より広く正則化されたマージンと引き換えに、違反を多く許容します。
サポートベクターの数はデータと解に依存し、C を増やしても特定のサポートベクター数が保証されるわけではありません。
カーネルトリック
元の特徴空間では直線的なハイパープレーンで分離できないクラスがあります。カーネルは別の特徴空間に対応する内積を評価します。これにより、SVMはすべての変換座標を明示的に計算せずに非線形境界をフィットさせることができます。
一般的なカーネルには以下があります:
- 線形:テキストなどの高次元スパース特徴に対して効率的です。
- 多項式:選択した次数までの相互作用をモデル化します。
- RBF(放射基底関数):距離に基づく柔軟な局所境界を作成します。
- シグモイド:ニューラルの活性化に似ていますが、デフォルトとしてはあまり一般的ではありません。
RBF SVMでは、gamma が各トレーニング例が境界に与える影響の局所性を制御します。gamma が大きいと非常に詳細な領域を作り過学習overfitしやすく、gamma が小さいと影響が滑らかになります。
マルチクラス分類
従来のSVMの目的関数は二値です。ライブラリは one-vs-rest(クラスごとに1つの分類器を訓練)や one-vs-one(クラスペアごとに分類器を訓練し、決定を統合)といった戦略で拡張します。マルチクラスSVMはクラス数より1本少ない線を引くだけではありません。
サポートベクター回帰とワンクラスSVM
サポートベクター回帰(SVR)は、ε幅のチューブ内の誤差を無視し、より大きな偏差にペナルティを課しながら関数をフィットさせます。ワンクラスSVMは典型的なデータの周囲に境界を推定し、新規性検出をサポートできます。異常な点が自動的に詐欺や故障を意味するわけではなく、フィットされた表現上で異常であるということです。
実務上の要件
SVMは距離と内積に依存するため、数値特徴は一般にスケーリングが必要です。C、カーネル、gamma、クラス重みは検証を通じて選択すべきです。確率推定はマージンに固有ではなく、しばしばキャリブレーションが必要で、コストが増加するため別途評価する必要があります。
カーネルSVMの学習は、データや実装によりサンプル数に対して二次から三次の時間でスケールします。線形SVMのバリエーションや確率的線形モデルは非常に大規模なデータセットに適しています。生画像、音声、言語の場合、ディープラーニングから得られた表現がより効果的であることが多いですが、SVMは固定された埋め込みを分類することは依然可能です。
SVMの強みと限界
SVMは多数の特徴を扱いやすく、明確な正則化目的を提供し、予測時は主にサポートベクターに依存します。制限点としては、スケーリングやハイパーパラメータに対する感度、学習コストの高さ、非線形カーネル下での解釈性低下、そして確率キャリブレーションが必要になることが挙げられます。
マージン、カーネル、最適化目的
サポートベクターマシンは、クラス間に大きなマージンを持つ分離ハイパープレーンを求めます。マージン上または内部にあるサポートベクターだけが境界を決定します。ソフトマージンSVMは重なりや誤ラベル点に対してスラックを導入し、パラメータCは広いマージンと学習違反とのトレードオフを行います。入力は通常スケーリングすべきで、距離と内積が解を駆動するためです。エラーコストや出現頻度が不均等な場合はクラス重みやリサンプリングが有効ですが、閾値や確率は依然として独立した検証が必要です。
カーネルトリックは、入力が高次元の特徴空間にマッピングされたかのように類似度を評価します。線形、ポリノミアル、放射基底、特殊カーネルはそれぞれ異なる仮定をエンコードします。RBFカーネルの場合、gammaは各点が境界に与える局所的影響を制御します:高いgammaは複雑な領域を作り過学習し、低いgammaは過小適合を招きます。カーネル行列はサンプル数に対して二次的に増大し、非線形SVMは大規模データでコストが高くなります。スケール時には線形ソルバーや近似特徴マップがしばしば好まれます。
マルチクラス利用、キャリブレーション、運用上の制限
二値SVMはone-vs-rest、one-vs-one、あるいは構造化手法でマルチクラスへ拡張します。ハイパーパラメータはクロスバリデーション内で調整し、必要に応じてグループ化や時間的分割を行います。クラス別の適合率・再現率、マージン分布、キャリブレーション、シフト下での性能を評価します。生の決定スコアは確率ではなく、Plattスケーリングや等方性キャリブレーションは別データを使用し、出現頻度が変わると性能が低下することがあります。前処理とチューニングを同等にした上で、ロジスティック回帰、決定木、最新の表現ベース手法と比較してください。
運用には正確なスケーラー、特徴順序、カーネルパラメータ、サポートベクター、クラスマッピングが必要です。カーネルSVMの予測コストはサポートベクター数に比例して増加するため、実際のバッチでレイテンシとメモリを測定します。トレーニングサポートから遠い入力でも自信を持ったラベルが付くことがあるため、適切にアウト・オブ・ディストリビューションチェックや棄権ポリシーを追加してください。エラーはセンシティブな代理変数やデータセットのアーティファクトを検査します。SVMは中規模・高次元問題で依然強力ですが、最大幾何学的マージンが因果構造や安全性の証明になるわけではありません。
実例:希少文書ルーティングのためのSVM
法務オペレーションチームは、TF–IDF特徴と線形SVMを用いて短い申請書をルーティングカテゴリに分類します。テンプレート流出を防ぐために案件と時間で分割し、レビュー済みエラーコストに基づいてクラス重みをスケーリングし、入れ子のバリデーションでCを調整します。線形モデルはロジスティック回帰とトランスフォーマーと比較され、クラス別の適合率・再現率・キャリブレーション・レビューワークロードが全体精度より重要視されます。
決定スコアは別データでキャリブレーションされ、マージンが低いまたは言語が未対応の文書は手動受付に回されます。提供アーティファクトにはトークナイザー、語彙、重み付け、モデル、キャリブレーション、ラベルマップが含まれます。モニタリングは新語、カテゴリ出現頻度、マージン、修正ルートを追跡します。テキスト特徴は機密情報を露出する可能性があるため、文書とサポートベクターは保護されます。非線形カーネルは、わずかな品質向上がレイテンシ、メモリ、解釈コストを正当化できない場合に除外されます。
実装の証拠と運用準備
本番導入の判断は、単なるデモ成功以上の要件が必要です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、サービスが不十分になる可能性が高いグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現できるようにし、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の介入、確認済み結果を明らかにすべきです。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントも必要です。
よくある質問
SVMは分類だけを行うのですか?
いいえ。サポートベクター回帰は連続的なターゲットを予測し、ワンクラスSVMは新規性境界を推定できます。各バリエーションは異なる目的とハイパーパラメータのセットを持ちます。
線形SVMはどのような場合に有力な選択肢となりますか?
線形SVMは、テキスト表現などの高次元スパース特徴に対してしばしば効果的で、柔軟なカーネルを使用するとコストが増えるだけで明確なメリットが得られない場合に有力な選択肢です。
主要参考文献












