
AIの基礎
ベイズ定理とは何か?

 Unite.AI を Google の優先ソースに追加
ベイズの定理は、証拠を観測した後に仮説の確率を更新する方法を示します。仮説が与えられたときの証拠の確率と、証拠が与えられたときの仮説の確率を結びつけます。
この区別は統計的推論や機械学習の中心的概念です。条件が存在する場合にテストは非常に高い精度を示すことがありますが、条件が稀少な場合、陽性結果がその条件を示す確率はそれほど高くありません。
主なポイント
- 事後確率は事前信念と観測された証拠の尤度を組み合わせたものです。
- 証拠項は可能な仮説を正規化します。
- 基礎率は、一見強い証拠をも支配することがあります。
- ナイーブベイズは、特徴がクラスが与えられた条件下で条件独立であると仮定し、すべての状況で独立しているわけではありません。
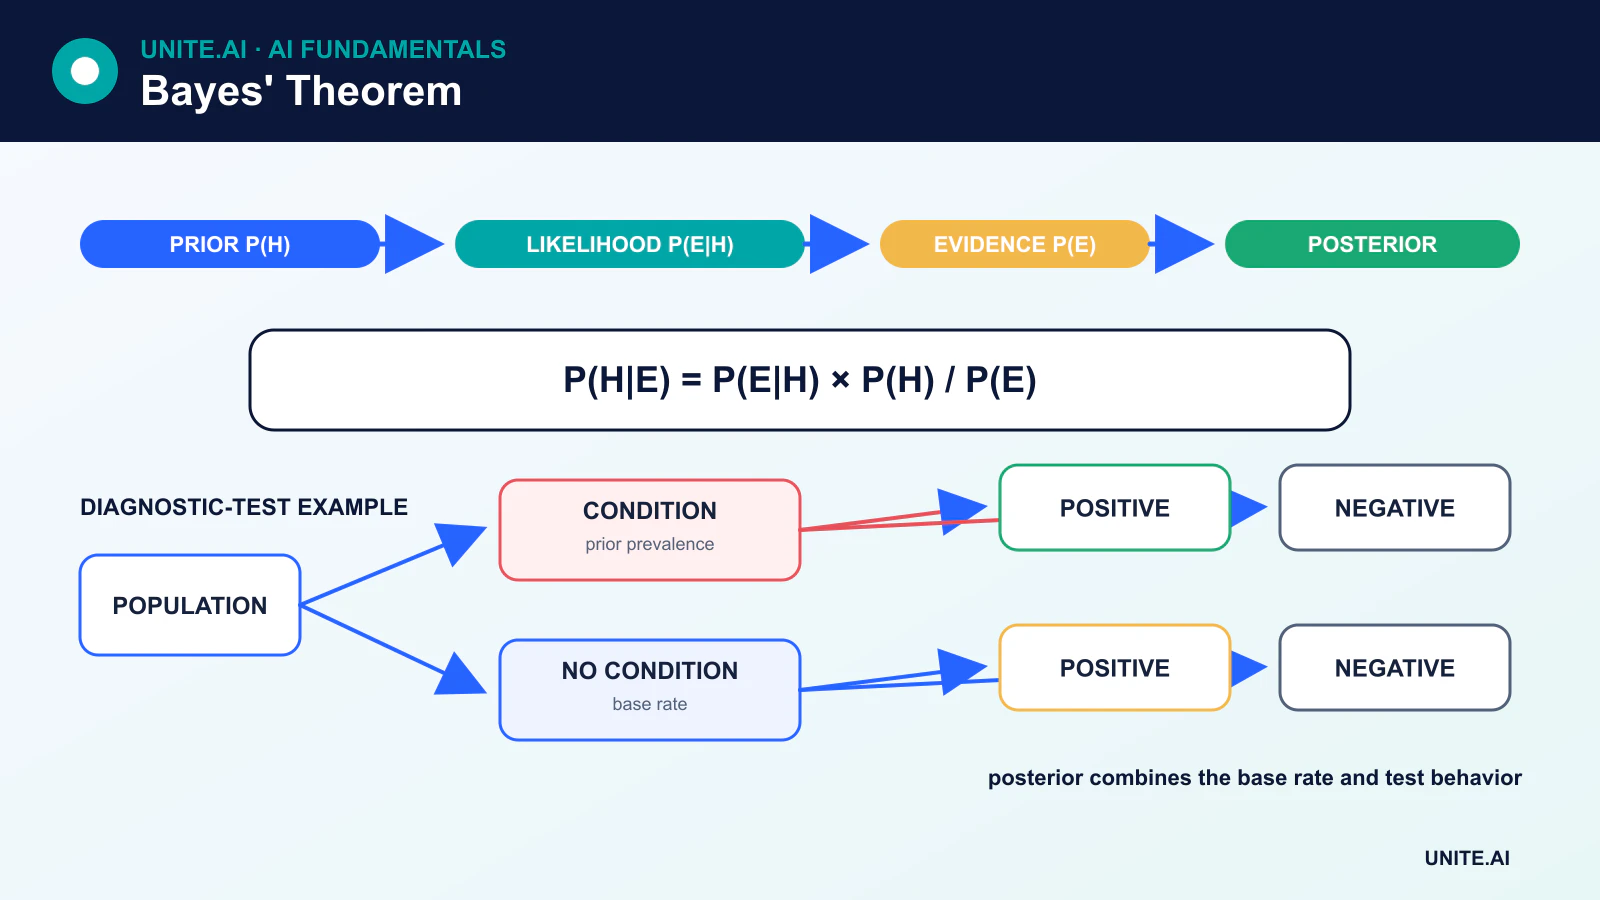
式
P(A|B) = P(B|A)P(A) / P(B)
- P(A) は仮説 A の事前確率です。
- P(B|A) は A が真である場合に証拠 B を観測する尤度です。
- P(B) は証拠全体の確率です。
- P(A|B) は B を観測した後の A の事後確率です。
この定理は、結合確率の二つの等価表現 P(A ∩ B) = P(B|A)P(A) と P(A ∩ B) = P(A|B)P(B) から導かれます。
数値的な基礎率の例
ある条件が全体の 1% に影響するとします。テストの感度は 90%、偽陽性率は 5% です。1,000 人を考えると:
- 約10人が条件を持ち、テストはうち9人を正しく陽性と判定します。
- 約990人は条件を持たず、5% の偽陽性率によりおよそ50人が誤って陽性と判定されます。
- したがって陽性結果は約59件で、そのうち9件が真の陽性です。
陽性結果が出た後の条件の確率は約 9 / 59 ≈ 15% であり、90%ではありません。テストの感度は P(positive | condition) を示しますが、ユーザーが求めるのは通常 P(condition | positive) です。ベイズの定理は基礎率を用いて両者を結びつけます。
ベイズ的更新
新たな証拠が得られるたびに、事後分布は次の更新の事前分布となります。完全なベイズモデルは、考えられる仮説、事前分布、尤度、そして推定すべき量を指定します。不確実性は点推定だけでなく、事後分布として表現されます。
事前分布は文書化し、感度分析でテストすべきです。弱情報的事前分布は不合理な値を正則化できますが、選択が不適切な強い事前分布は限られたデータを支配してしまうことがあります。
ナイーブベイズ分類器
ナイーブベイズはベイズの定理と次の仮定を用いて、特徴 x₁ … xₙ からクラス y を予測します。
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
クラスが既知であるとき、特徴は条件付きで独立していると仮定されます。これはしばしば現実的でないことがありますが、得られるクラススコアが有用であれば分類器はうまく機能します。
一般的なバリエーション
- マルチノミアルナイーブベイズは、カウント型特徴をモデル化し、文書分類で一般的に使用されます。
- ベルヌーイナイーブベイズは、二値的な特徴の有無をモデル化します。
- ガウシアンナイーブベイズは、各連続特徴をクラス条件付きガウス分布でモデル化します。
- カテゴリカルナイーブベイズは、離散的なカテゴリをモデル化します。
スムージングと数値的安定性
訓練時にある特徴値がクラスと一度も現れない場合、スムージングされていない確率推定はゼロになり、積全体を消してしまいます。加算的またはラプラス型スムージングはこれを防ぎます。実装では対数確率を計算するため、多くの小さな値の掛け算が安定した対数の加算に置き換えられます。
確率、スコア、キャリブレーション
ナイーブベイズの確率出力は、相関する特徴が実質的に複数回カウントされるため、キャリブレーションが悪くなることがあります。分類器はクラスをうまく順位付けできても、信頼度を過大評価することがあります。確率が意思決定に用いられる場合は、保持データでキャリブレーションを評価すべきです。
ナイーブベイズを超えるベイズ
ベイズ推論は階層モデル、A/B テスト、科学的パラメータ推定、予測、 不確実性を考慮した意思決定、確率的グラフィカルモデルをサポートします。事後分布が閉形式で求められない場合、マルコフ連鎖モンテカルロや変分推論といった近似手法が用いられます。
一般的な推論ミス
- P(A|B) と P(B|A) を混同すること。
- 稀少または一般的な基礎率を無視すること。
- 事前分布を客観的とみなす、または文書化しないこと。
- 高い尤度が自動的に高い事後確率を意味すると仮定すること。
- 予測的な関連性を因果関係と解釈すること。
条件付き確率、オッズ、証拠
ベイズの定理は、証拠観測後の仮説の確率を、事前確率、仮説下での証拠観測尤度、そして証拠全体の確率で結びつけます。オッズ形式では、事後オッズは事前オッズに尤度比を掛けたものに等しくなります。これにより、テスト前に信じていたことと、テストが仮説をどれだけ区別できるかが分離されます。条件が稀少な場合でも、ベースレートが事後オッズに影響するため、非常に正確に見えるテストでも多数の偽陽性が生じ得ます。
尤度は、固定された観測データに対する仮説の関数であり、仮説の確率と混同すべきではありません。証拠の正規化は、競合する仮説全体に対して和または積分を行います。条件独立の仮定は計算を簡略化しますが、ナイーブベイズのように結果に影響を与えるか検証が必要です。複数の証拠が原因を共有したり情報が重複する場合、独立として掛け算すべきではありません。因果方向も重要で、P(証拠|仮説) が一般に P(仮説|証拠) と等しいわけではなく、これは古典的な逆確率の誤りです。
モデリングの選択、計算、意思決定への活用
ベイズ分析は事前分布、尤度、事後予測分布を指定します。事前分布は既存の知識を符号化したり、小サンプルを正則化したり、弱情報的に設定したりでき、感度分析で正当性を検証すべきです。共役モデルは解析的に更新できますが、マルコフ連鎖モンテカルロ、変分推論、逐次手法は複雑な事後分布を近似します。収束、実効サンプルサイズ、近似誤差、事前予測の妥当性を診断し、計算チェックなしに事後数値だけを報告しないようにします。
事後確率は情報を提供しますが、それだけで行動を決定することはできません。意思決定には損失、利益、制約、利用可能な代替案が必要です。確率モデルはキャリブレーション、適切なスコアリング規則、新データに対する事後予測チェックで評価すべきです。証拠はモデル化されたプロセス下で収集された場合にのみ更新すべきで、選択バイアスやデータシフトは尤度を無効にします。信頼区間と仮定を伝える際は、頻度的範囲として保証しないことが重要です。ベイズの定理は正確な確率代数ですが、ベイズ的結論の質はモデルと提供された証拠に依存します。
実例:診断テストの解釈
あるテストは感度95%、特異度90%ですが、対象集団のうち条件が存在するのはわずか1%です。1万人に対しては、約95件の真陽性と990件の偽陽性が予想され、陽性予測値は9%未満になります。ベイズの定理は基礎率の影響を明示します。この計算は、陽性結果が正しい確率として感度を宣伝するのではなく、集団規模、テスト閾値、そして不確実性を示します。この区別は、慎重なデータサイエンスにも根本的です。
臨床医は、検査間の依存性がモデル化されている場合にのみ追加証拠で確率を更新します。意思決定閾値は、見逃しによる危害、確定検査のリスク、コスト、患者の嗜好を考慮します。キャリブレーションはローカル集団で確認され、罹患率の変化があれば再評価が行われます。事後分布は議論や次のステップを支援しますが、確定診断の代替にはなりません。報告は自然頻度と感度分析を用いて、患者や医師が結論が妥当な仮定下でどのように変化するかを理解できるようにします。
実装の証拠と運用準備
本番導入の判断は、単なる成功デモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を明確にします。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを用い、安全なフォールバックを保持し、意図的に失敗を注入して監視を検証します。運用テレメトリは、不要な機微データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の介入、確認された結果を明らかにすべきです。アラート閾値と対応責任者を定義し、導入後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化する必要があります。
よくある質問
尤度と確率の違いは何ですか?
パラメータが固定されている場合、モデルは可能なデータに確率を割り当てます。観測データが固定されている場合、同じ式はパラメータの可能な値に対する尤度関数とみなすことができます。数式は同じでも解釈が異なります。
ナイーブベイズは完全なベイズ推論ですか?
ナイーブベイズは、強い条件独立モデルの下でベイズの定理を用いた分類です。より広範なベイズ推論は、未知量に対して分布を設定し、事後分布で推論を行います。
主要参考文献












