Andersonの視点
画像合成システムが本当に独創的な素材を生成しているかを見分ける方法

 Unite.AI を Google の優先ソースに追加

要点KAISTとNAVERのレアリティスコアは、最近傍距離を通じて画像の独創性を測定します。
もっと見る
- KAISTとNAVERのレアリティスコアは、最近傍距離を通じて画像の独創性を測定します。
- 既存の指標(トランケーション・トリックなど)は、生成画像において新規性よりも信頼性を優先します。
- レアリティスコアは、DALL-E 2のようなシステムから真に革新的な出力を識別できる可能性があります。
韓国の新しい研究は、画像合成システムが本当に新しい画像を作るのか、それとも学習データをわずかに変えた画像を作るだけなのかを判定する方法を提案した。後者なら、新しく独創的な画像を生み出すという設計の目的を損ないかねない。
論文によると、後者であることは非常に多い。学習中に生成能力を改善する既存の指標が、データセット内の本物の元画像に比較的近い結果を優遇せざるを得ないからだ。
生成画像が元データと視覚的に近ければ、独創性よりも真正らしさで高い評価を得やすい。創意に乏しくても元画像には忠実だからである。
法的影響がまだ分からないほど若く未検証な分野では、これは 重要な法的問題になり得る。商用の合成画像が、しばしば著作権で保護された元資料と十分に異ならない場合だ。現在、こうした資料は 広く流入を許され、ウェブから収集された人気のデータセットを通じて研究に使われている。この種の将来の侵害請求の可能性は 比較的最近注目された。MicrosoftのGitHub Co-Pilot AIに関する問題である。
OpenAIの DALL-E 2、Googleの Imagen、中国の CogView、さらに低い仕様の DALL-E mini などの出力は一貫性と意味的な確かさを増している。しかし、生成画像の独創性を信頼できる形で検証する 事後的な 方法はほとんどない。
人気のある新しいDALL-E 2画像を検索しても、検索エンジンによっては同じ画像の別のコピーばかり見つかることが多い。

9枚のDALL-E 2出力をまとめてアップロードすると、格子構造が最も強い特徴になるため、別のDALL-E 2画像群しか出てこない。最初の1枚を分離してアップロードすると、これはWeird Dall-E Generationsアカウントが2022年6月8日に投稿した このTwitter投稿の画像だが、Googleはバスケットボールに固執し、画像検索を意味的な行き止まりに導く。同じ画像に対してYandexは、少なくとも実際の画素分析と特徴の照合を行っているように見える。
YandexはGoogle Searchよりも画像の実際の 特徴、つまり画像から導出または計算した 属性を利用する傾向が強い。必ずしも人の顔の特徴を指すわけではない。また、意味的特徴ではなく 視覚的 な特徴で似た画像を探す。しかし、すべての画像検索エンジンには 何らかの目的や手法があり、ウェブ検索による 元画像>生成画像 型の盗用の発見を難しくする可能性がある。
生成モデルの学習データがすべて公開されているとは限らず、生成画像の独創性についての検証はさらに難しくなる。
興味深いことに、Googleの Imagen専用サイトにある合成画像を画像検索しても、画像そのものを観察し公平に類似画像を探すという観点では、その題材に匹敵するものが全く見つからない。Google Imagesは相変わらず意味に固執し、追加の限定的な検索語imagen googleを付けなければ純粋な画像検索を許さない。

一方Yandexは、アマチュアの芸術家コミュニティから、似たもの、少なくとも視覚的に関連する現実の画像を多数見つける。

学習時点でネット上にあるすべての画像や、著作権資料を使っているかもしれない非公開データセットから特徴を抽出せずに、画像合成出力の新規性や独創性を測れれば、その方がよい。
この問題に関連して、韓国科学技術院のKim Jaechul Graduate School of AI(KAIST AI)の研究者は、世界的なICT・検索企業NAVER Corpと協力し、希少性スコア(Rarity Score)を開発した。画像合成システムのより独創的な作品を見分ける助けになり得る。

StyleGAN-FFHQで生成した画像。列は左から右へ悪い結果から良い結果へ並ぶ。Truncation trickとRealismにはそれぞれの目標があるが、上段の新しい希少性スコアは単に一貫した画像ではなく、一貫性と独創性を併せ持つ画像を探す。 記事の画像サイズには制限があるため、詳細と高解像度の結果は原論文を参照。 出典:https://arxiv.org/pdf/2206.08549.pdf
新しい 論文の題名は Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images(希少性スコア:合成画像の珍しさを評価する新しい指標)で、KAISTの研究者3人とNAVER Corpの研究者3人が執筆した。
安易な技巧を超えて
新論文が改善を目指す従来の指標には、英国Heriot-Watt UniversityとGoogle DeepMindが協力して 2019年に提案した Truncation trickがある。
この手法は、生成モデルの学習時に使うものとは異なる潜在分布をサンプリングに使う。
開発者は機能したことに驚いたが、原論文では生成結果の多様性が減ると認めている。それでも、データのあらゆる可能性を本当に取り込まず、望む以上に元データに似るかもしれない、真正らしい結果を得る安易な技巧として有効で人気がある。
新論文の著者は次のように述べる。
「この手法は学習データセットの希少な標本を生成するためではなく、典型的な画像をより安定して合成するためのものだ。生成器が希少標本を効果的に作るよう誘導できれば、既存の生成モデルは実際のデータ分布においてより豊かな標本を作れると仮定する。」
モデル学習中の進歩を測る従来指標への依存について、著者はさらに述べる*。Frechet Inception Distance(FID)は2021年12月に 強く批判されており、ほかにInception Score(IS)やKernel Inception Distance(KID)などが使われる。
「この学習方式は、独特で強い特徴を持つが実画像分布の割合は小さい希少標本を、生成器があまり合成しない方向へ導く。公開データセットの例は FFHQのさまざまな装飾品を身に付けた人、AFHQの白い動物、Metfacesの珍しい彫像だ。
「希少標本を作る能力は、生成モデルの限界能力に関係するだけでなく、仮想人間など創造的な応用では独自性が重要な役割を持つためにも重要だ。
「しかし最近の複数研究の定性的な結果には、こうした希少例がほとんどない。敵対的学習の性質が、生成画像の分布を学習データセットに近づけると考える。そのため明確な個性や希少性を持つ画像は、合成結果のごく一部にとどまる。」
手法
新しい希少性スコアは、以前の 研究にある考えを応用する。K近傍法(KNN)を使い、画像合成システムの実際の学習データと合成出力の配列を表現するのだ。
著者は新しい分析方法について次のように述べる。
「普通の標本同士は近く、独特で希少な標本は特徴空間にまばらに配置されると仮定する。」
上の結果図は、FFHQで学習したStyleGAN構造の最近傍距離(NND)を小さい順に示す。
「すべてのデータセットで最小NNDの標本は代表的で典型的な画像を示す。一方、最大NNDの標本は個性が強く、最小NNDの典型画像とは大きく異なる。」
理論上、この指標を識別器として使うか、より複雑な識別器構造に組み込めば、生成システムを単なる模倣からより創意あるアルゴリズムへ誘導できる。同時に、真正らしい画像生成に重要な概念の一貫性を保てる。たとえば 男性, 女性, 車, 教会 などだ。
比較と実験
研究者は希少性スコアをTruncation trickとNVIDIAの2019年の Realism Scoreに比較し、複数の構造とデータセットで独特な結果を識別できると分かった。
論文の結果はここにすべて載せられないほど多いが、研究者は生成過程の実際の元画像と生成画像の両方で希少性を見つける能力を示したようだ。
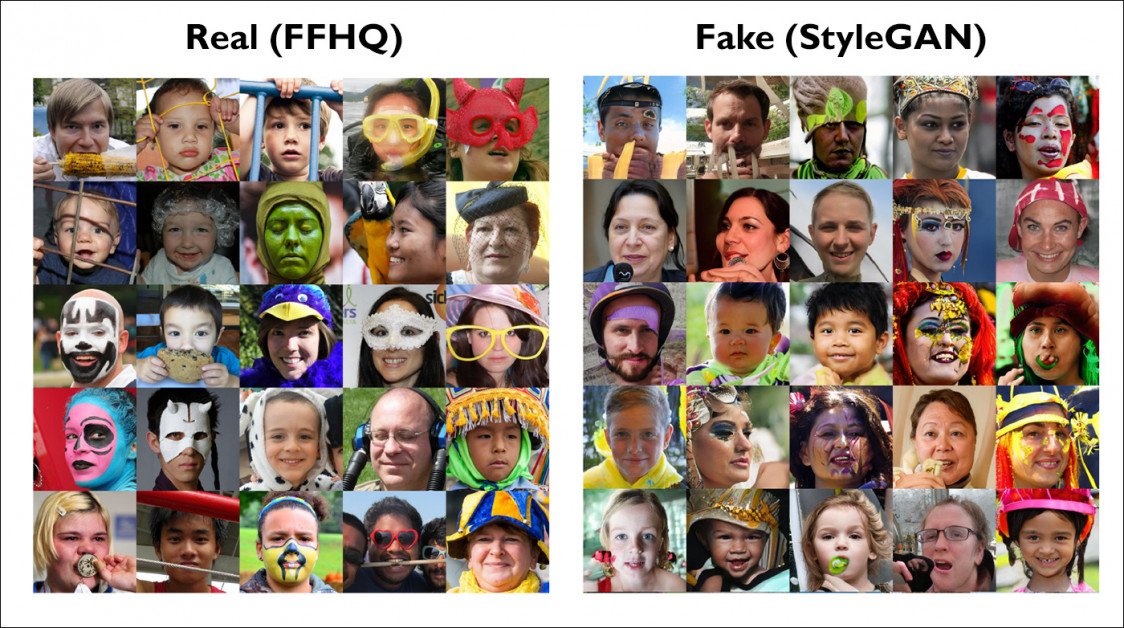
論文の多数の視覚的結果から選んだ例。詳細は上の出典を参照。左は元データセットに近い隣接標本が非常に少ない、新しく珍しいFFHQの実例。右は新指標が本当に新しいと判断したStyleGANの生成画像。記事の画像サイズには制限があるため、詳細と高解像度画像は原論文を参照。
著者によると新しい希少性スコアは、一つの構造で新しい出力を見分けるだけでなく、オートエンコーダー、VAE、GANなど異なる構造の生成モデルを比較できる。
論文は、独特で希少な画像を生み出す能力に注目する点で従来指標と異なるとする。従来指標は学習中の生成結果間の多様性を、より狭い視点で調べる。
限られた課題を超えて
実験は、人や猫の画像に特化した生成器とデータセットの組み合わせなど、限定領域で行われた。しかし学習データ由来の分布を使う結果を見分けたい任意の画像合成に応用できる可能性がある。外部の潜在分布を挟んで真正らしさを増し多様性を減らしたり、真正らしさのために新規性を犠牲にする近道を使ったりする代わりになる。
DALL-Eなどのシステムで、明らかな外れ値に見える結果、学習データ、似た指示や入力からの結果の距離を使い、本当に新しい出力を区別できるかもしれない。画像ベースの指示も含まれる。
実際にシステムが視覚的・意味的概念をどれだけ取り込んだかは明確でなく、学習データの知識の乏しさが判断を妨げる。それでも、十分な入力概念とデータが、過度な派生物や元データに近いものではなく真に創意あるものを生む、実際のひらめきの瞬間を見つける有効な方法かもしれない。
* 著者らの本文中の引用を筆者がハイパーリンクに変換した。
初出:2022年6月20日。