
AIの基礎
感情分析とは何か? 手法・活用例・限界

 Unite.AI を Google の優先ソースに追加
感情分析は、テキストや音声文字起こし、その他のコンテンツに含まれる評価的言語を推定します。システムは、肯定・否定・中立といった極性を分類したり、アスペクトレベルの意見を検出したり、強度を推定したり、特定の主張に対するスタンスを識別したりできます。
対象は慎重に定義する必要があります。感情は感情、意図、毒性、満足度、真実とは同じではありません。肯定的な文でも皮肉的に有害な出来事を述べることがあり、否定的な製品レビューでも全体的に製品を推奨することがあります。
主なポイント
- 例を収集する前に、単位、対象、ラベル、コンテキストを定義する。
- 辞書は透明なベースラインであり、教師ありモデルやトランスフォーマーモデルはより多くの文脈を捉えられるが、代表的なデータが必要である。
- 否定、皮肉、ドメイン固有語彙、多言語テキスト、アスペクトの境界は依然として難しい。
- クラス、サブグループ、ドメイン、期間ごとに評価し、重要な用途では人間によるレビューを含める。
レベルと対象
文書レベルの分析は、対象全体に対して1つのラベルを生成します。文レベルの分析は文を個別に扱い、アスペクトベースの分析は感情を特定のエンティティや属性に結び付けます。例えば、画像品質については肯定的だが、バッテリー寿命については否定的というように。
スタンスは話者が特定の命題を支持しているかどうかを問うもので、感情的トーンとは異なる場合があります。これらの区別は、テキスト分類手法を適用する前にアノテーションガイドで明確にしておくべきです。
辞書、従来モデル、トランスフォーマー
辞書は単語にスコアを割り当て、否定や強度に関するルールと組み合わせます。解釈しやすくコストも低いですが、文脈への対応が苦手です。従来の教師ありモデルは単語や n-gram 特徴を使用し、トランスフォーマーは文脈表現を学習し、ファインチューニングが可能です。
少数ショットプロンプトは便利な場合がありますが、出力は例や表現に依存します。すべての高度な手法はベースラインと比較し、few-shot 学習は保持されたバージョン管理された評価セットを用いる場合にのみ使用してください。
データと言語の課題
ラベルは客観的事実ではなく、アノテーターの視点を反映することがあります。ドメインシフトは深刻で、例えば『予測不能』は映画に対しては称賛でも、車に対しては批判になることがあります。コードスイッチ、方言、絵文字、引用された発話、皮肉はトークンレベルのシグナルを複雑にします。
クラスは意図的にバランスを取り、関連する著者・製品・会話が訓練データとテストデータにまたがらないようにします。ブランドや話者を記憶したモデルは、感情を学習せずに高精度に見えることがあります。
評価と責任ある利用
正確度だけでなく、適合率、再現率、F1、混同行列を報告してください。エラーはアスペクト、長さ、方言、時間別にレビューし、各ミスの運用コストに合わせて閾値を調整します。
集計されたトレンドは研究やトリアージに役立ちますが、個人の状態を推測したり、雇用・信用・健康・警察の判断に用いることはリスクが高まります。不確実性、情報源コンテキスト、プライバシー制御、人間によるレビューを提供すべきです。
アノテーションとデータセット構築
対象エンティティ、分析単位、ラベル定義、混合・中立の取り扱い、引用ルール、皮肉方針、ドメイン例を含むアノテーションガイドを作成します。複数のアノテーターでパイロットし、合意度を算出し、意見の相違を議論し、ラベルを拡大する前にタスクを修正します。
サンプリングはモデルが学習する内容を決定します。ソーシャルメディアのストリームは活動的なアカウントを過剰に代表し、サポートチケットは満足した顧客を除外し、星評価はレビュー本文と一致しないことがあります。ソースと時間のメタデータを保持し、プラットフォームの利用規約とプライバシーを尊重し、意思決定が行われる母集団からテストセットを作成してください。
ラベル漏洩は評価、収集システムが挿入した絵文字、テンプレート署名、感情と相関する製品名などから起こり得ます。ほぼ同一の投稿は重複除去し、会話や著者をグループ化して、分割の両側に同じ言語が出現しないようにします。
モデリングの選択とキャリブレーション
辞書ベースのシステムは単語スコアを合計し、否定語、強調語、句読点、絵文字で調整します。有用なサニティチェックを提供し、ドメイン用語で適応可能です。TF–IDF 特徴を用いた線形モデルは一部データセットで競争力があり、影響力のある n-gram を明らかにします。
コンテキストエンコーダは周囲のテキストに基づいて単語を表現し、極性やアスペクト向けにファインチューニングできます。長文は階層型モデル、文の集約、または関連スパンの取得が必要になることがあります。多言語アプローチは、単一の共有モデルを訓練する、ピボット言語に翻訳する、またはローカルモデルを維持する方法があり、いずれもカバレッジと文化的トレードオフがあります。
スコアがアクションを引き起こす場合、確率キャリブレーションが重要です。信頼性プロットと期待キャリブレーション誤差は、0.8 の信頼度が約 80% の正確性に相当するかを示します。閾値により人間レビュー用の保留帯を設定でき、エラーコストが異なる場合は別々の閾値を設けることが正当化されます—品質の不均衡を隠すためではありません。
応用例と一般的な誤解
集計された感情は、テーマの優先順位付け、キャンペーン反応の比較、緊急サービスメッセージの振り分けに役立ちます。アスペクト分析は、何が議論されているかを特定できるため、全体的な極性よりも実用的です。トレンド分析には、時間を通じた安定したサンプリングとラベル定義が必要です。
否定的な投稿の多さを人口の意見と同一視しないでください。投稿行動、ボット、モデレーション、プラットフォームの人口統計、キャンペーン、収集クエリがサンプルを形成します。感情モデルは沈黙している層を測定せず、表現の変化が態度の変化のように見えることがあります。
個人の意思決定において、誤ったラベルはスティグマ化し、争うのが困難です。感情を従業員エンゲージメント、メンタルヘルス、信用度、意図、欺瞞の代替指標として使用しないでください。人々に影響が及ぶ場合は、情報源のコンテキストを示し、訂正を許可し、実際の裁量を持つ人間の意思決定者を必須とします。
実例:顧客フィードバックに対する感情分析
サポートコメントを分析する企業は、文書感情、アスペクト感情、感情、緊急度、または課題分類のどれが必要かを定義すべきです。『配達は速かったが、製品は壊れた』という文は、単一の肯定・否定ラベルで正確に表現できません。対象、否定、皮肉、混合表現、引用発話、未知ケース向けのアノテーションガイドを作成し、ラベルを真実とみなす前に合意度を測定します。
辞書や線形ベースラインと、ファインチューニングしたエンコーダやプロンプト付き言語モデルを比較します。時間または顧客単位でデータを分割し、近似重複漏洩を防ぎ、クラス分布を保持します。適合率、再現率、F1、キャリブレーション、言語・チャネル・製品・デモグラフィックの代理指標別混同行列を、法的に許容されかつ正当化できる場合にのみ報告します。自動ルーティングで危険性が高いため、高信頼度エラーをレビューし、不確実な出力よりも注意します。
感情は集計や優先順位付けの一つのシグナルとして使用し、個人の状態を疑う余地のない指標としては使わないでください。語彙や製品のドリフトを監視し、レビュー済み例で再学習し、エージェントがラベルを修正できるようにします。検証されていない感情スコアから保護された属性を推測したり、従業員を処罰したりしないでください。経営層向けレポートでは、サンプルサイズ、不確実性、欠損データ、変化を促すトピックを示し、変動スコアが単純な結論ではなく調査につながるようにします。
多言語展開では、入力を翻訳すればトーン、否定、慣用表現、文化的慣習が保たれると想定しないでください。各対応言語と混合言語パターンはネイティブレビュアーで検証し、証拠が弱い場合は「不明」結果を提供します。ドメイン適応も重要で、日常会話で否定的に聞こえる語が技術的には中立的な説明になることがあります。運用上の根拠が追加の複雑性とガバナンス負担を正当化する場合にのみ、別個の閾値やモデルを維持してください。
実装チェックリスト
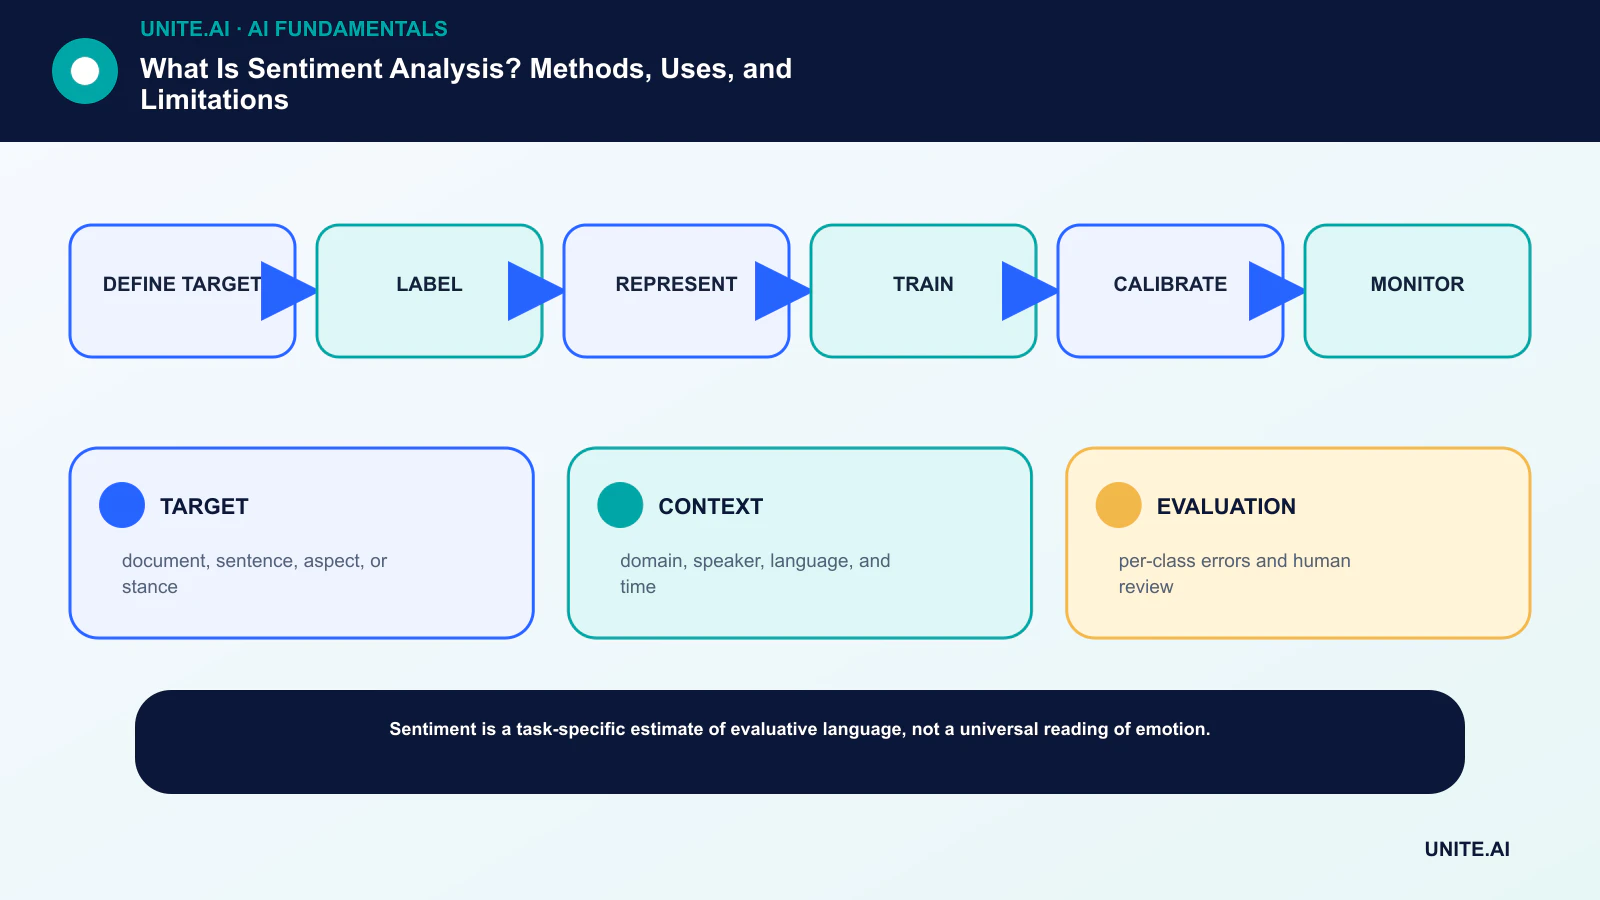
概念を限定的でテスト可能なワークフローに落とし込みます:対象 → ラベル → 表現 → 訓練 → キャリブレーション → 監視 を定義します。責任者を明示し、データと依存関係を文書化し、シンプルなベースラインを設定し、受入基準と停止基準を決め、代表的な失敗ケースをテストし、範囲拡大前に監視、ロールバック、レビューを定義します。バージョンと前提条件を記録し、他チームが結果を再現し変更点を把握できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存障害、誤用をテストし、証拠と未解決リスクを保存します。リリース承認、閾値変更、出力上書き、運用停止ができる人物を定義します。実データが入ったら判断を再検討してください。技術的に成功したパイロットが大規模での信頼性を保証するわけではありません。
- TARGET: 文書、文、アスペクト、またはスタンス。
- CONTEXT: ドメイン、話者、言語、時間。
- EVALUATION: クラス別エラーと人間レビュー。
よくある質問
感情分析は客観的ですか?
いいえ。感情分析はタスクとアノテーションプロセスで定義されたラベルを推定するもので、テキストによっては本当に曖昧で混合的、文脈依存であり、読者によって解釈が異なることがあります。
感情分析は皮肉を検出できますか?
モデルはある程度のパターンを学習できますが、皮肉は話者の履歴、共有知識、テキスト外のコンテキストに依存することが多く、依然として一般的な失敗要因です。
主要参考文献












