Grunderna i AI
Vad är maskininlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Maskininlärning (ML) är en gren av artificiell intelligens där ett system lär sig mönster från data så att det kan göra förutsägelser, klassificeringar, rekommendationer eller beslut utan att en utvecklare skriver en separat regel för varje möjligt fall. Resultatet är inte en maskin som “tänker” som en människa. Det är en statistisk modell som mappar indata till användbara utdata och kan utvärderas på data som den inte har sett under träning.
Maskininlärning ligger inom det bredare området AI, medan djupinlärning är en familj av maskininlärningsmetoder byggda kring flerskikts neurala nätverk. Denna distinktion är viktig: inte varje AI‑system använder ML, och inte varje ML‑problem kräver ett neuralt nätverk.
Viktiga slutsatser
- ML lär sig ett samband från exempel snarare än att enbart förlita sig på handskrivna regler.
- En användbar modell måste generalisera till ny data, inte bara memorera sin träningsuppsättning.
- Övervakat, oövervakat, semi‑övervakat, själv‑övervakat och förstärkningsinlärning löser olika typer av problem.
- Datakvalitet, utvärderingsdesign och övervakning är lika viktiga som algoritmen.
Hur maskininlärning fungerar
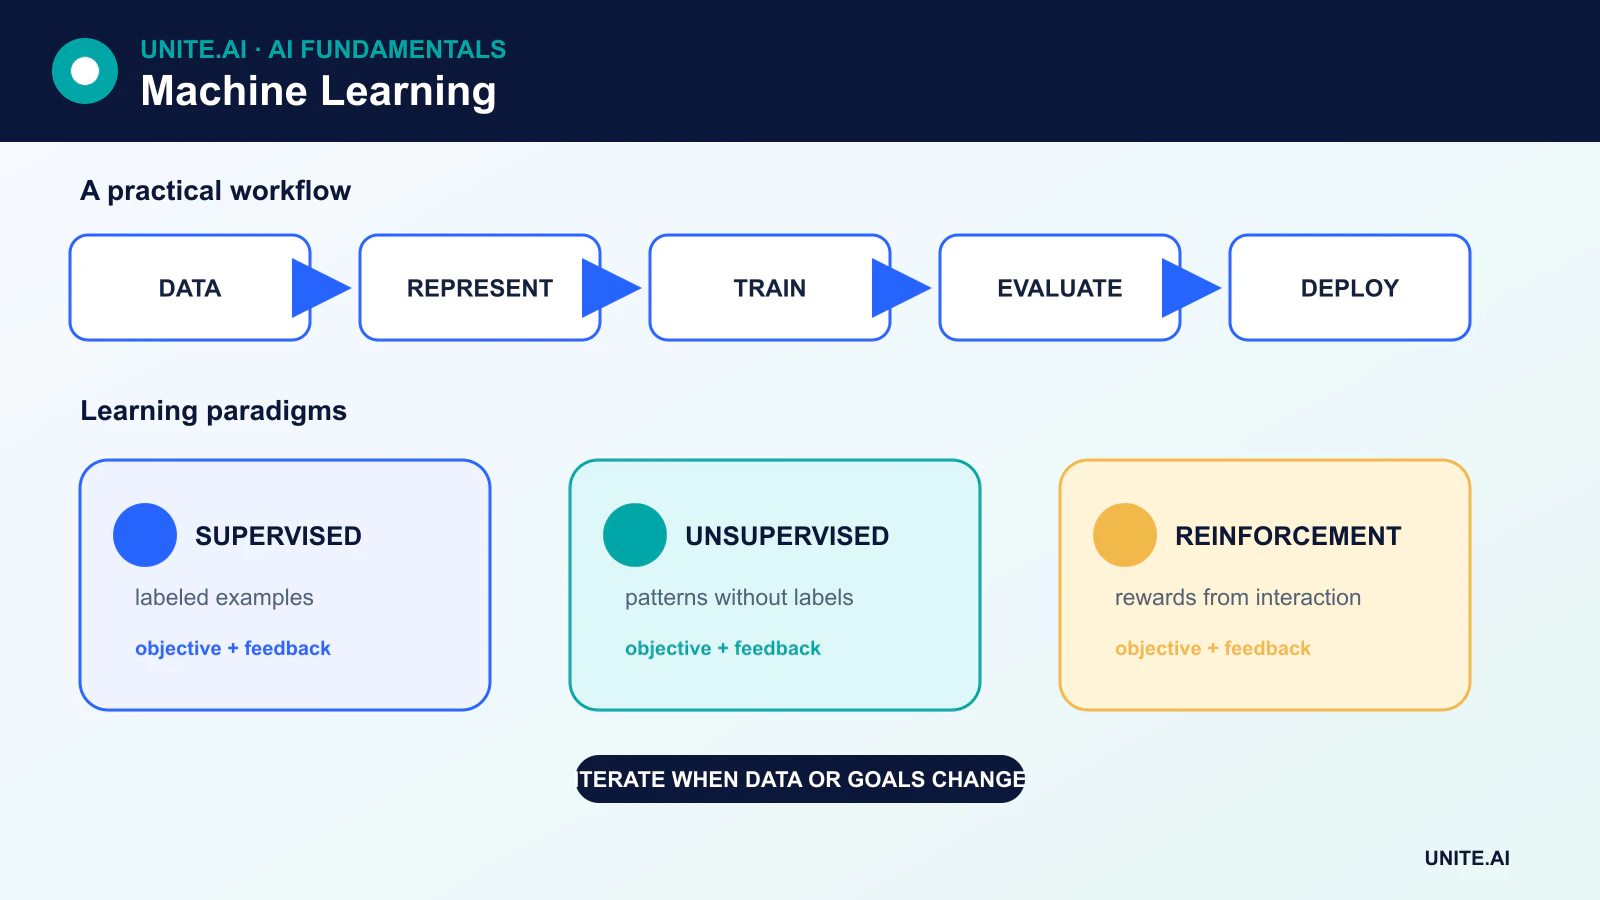
De flesta ML‑projekt kan förstås som en sekvens av sex steg:
- Definiera uppgiften. Bestäm vad systemet ska förutsäga eller upptäcka och vad framgång innebär i den verkliga tillämpningen.
- Samla in och förbered data. Rensa poster, hantera saknade värden, skapa användbara funktioner och dokumentera var datan kommer ifrån.
- Dela upp data. En träningsuppsättning används för att anpassa modellen, en valideringsuppsättning hjälper till att välja inställningar, och en testuppsättning ger en slutgiltig uppskattning på opåverkad data.
- Träna modellen. En algoritm justerar modellens parametrar för att minska en förlustfunktion eller uppfylla ett annat inlärningsmål.
- Utvärdera generalisering. Mätvärden måste spegla uppgiften, klassbalansen, felkostnader och den population som modellen kommer att verka på.
- Distribuera och övervaka. Verklig data kan förändras, så teamet övervakar för drift, prestandaförsämring, bias och operativa fel.
Variablerna som levereras till en modell kallas vanligtvis funktioner. I övervakad inlärning kallas det önskade svaret för etikett eller mål. Modellens inlärda parametrar kodar ett samband mellan funktionerna och utdata; de är inte en databas med explicita regler.
De viktigaste inlärningsparadigmerna
Övervakad inlärning
I övervakad inlärning innehåller exemplen både indata och kända mål. En klassificeringsmodell förutsäger kategorier, till exempel om en transaktion är bedräglig. En regressionsmodell förutsäger ett kontinuerligt värde, såsom förväntad energiefterfrågan.
Vanliga övervakade algoritmer inkluderar beslutsträd, stödvektormaskiner, K‑närmaste grannar, linjär och logistisk regression, gradientförstärkta träd samt neurala nätverk. Ett klassificeringströskelvärde som 0,5 är ett beslut som väljs efter att en modell har producerat ett poäng eller sannolikhet; det är inte en oföränderlig egenskap hos logistisk regression.
Oövervakad inlärning
Oövervakad inlärning arbetar med data som inte innehåller mål‑etiketter. Målet kan vara att hitta kluster, upptäcka ovanliga observationer, uppskatta en fördelning eller skapa en lägre‑dimensionell representation. Ett kluster är en grupp föreslagen av en likhetsregel; det är inte automatiskt en meningsfull verklig klass.
Exempel inkluderar K‑means‑klustring, huvudkomponentanalys, täthetsuppskattning och vissa former av autoenkodare. En autoenkodare lär sig att rekonstruera sin indata genom en komprimerad representation. Den skapar inte automatiskt sanningsetiketter.
Semi‑övervakad och själv‑övervakad inlärning
Semi‑övervakad inlärning kombinerar en liten märkt datamängd med en större omärkt datamängd. Själv‑övervakad inlärning skapar en träningssignal från datan själv—till exempel genom att förutsäga maskerade ord eller matcha två transformerade vyer av samma bild. Själv‑övervakning är central för många moderna transformer– och grundmodellspipelines eftersom den kan använda stora samlingar av text, bilder, ljud eller video utan att någon person märker varje exempel.
Förstärkningsinlärning
I förstärkningsinlärning tar en agent handlingar i en miljö och får belöningar eller kostnader. Målet är att lära sig en policy som maximerar förväntad kumulativ belöning. Detta skiljer sig från övervakad inlärning eftersom den korrekta handlingen inte tillhandahålls för varje tillstånd, och en handling kan påverka vilken data agenten möter härnäst.
Träning, validering och generalisering
En modell som presterar bra på sina träningsexempel kan fortfarande misslyckas på ny data. Detta misslyckande kallas overfitting. Team minskar det genom lämplig modellkapacitet, regularisering, korsvalidering, data‑augmentation, förebyggande av läckage och en genuint oberoende testuppsättning.
Det finns inget enskilt mått för varje ML‑uppgift. Klassificering kan kräva precision, återkallelse, F1, kalibrering eller ett kostnadsvägt mått istället för rå noggrannhet. Regression kan använda medelabsolutfel, rotmedelkvadratfel eller en domänspecifik förlust. Klustring kräver olika former av intern eller externt validerad utvärdering. Måttet bör spegla vad ett fel betyder för användaren eller organisationen.
Maskininlärningsalgoritmer är verktyg, inte garantier
En algoritm bär på antaganden. Linjära modeller antar en viss form av samband. K‑närmaste grannar antar att det valda avståndet representerar meningsfull likhet. Naïve Bayes antar att funktioner är villkorligt oberoende givet klassen. Beslutsträd partitionerar funktionsrummet med hjälp av inlärda delningsregler; deras blad innehåller förutsägelser baserade på grupper av träningsobservationer snarare än nödvändigtvis en observation per blad.
Modellval beror därför på datamängdens storlek, funktionstyper, latenskrav, behov av tolkbarhet och kostnaden för misstag. En enklare modell kan överträffa en större modell när data är begränsad eller de operativa begränsningarna gynnar hastighet och transparens.
Var maskininlärning används
ML stödjer sökrankning, rekommendationer, prognostisering, avvikelsedetektion, översättning, taligenkänning, datorseende, prediktivt underhåll, bedrägeridetektion och vetenskaplig analys. Samma tekniker kan också förstärka historisk bias, avslöja känslig information eller bete sig oförutsägbart vid fördelningsskift. Ansvarsfull distribution kräver dokumentation, mänsklig tillsyn där lämpligt, säkerhetstestning och kontinuerlig övervakning.
Från problemdefinition till ett giltigt maskininlärningsexperiment
Ett maskininlärningsprojekt bör inledas med ett beslut och ett mätbart resultat, inte en algoritm. Definiera förutsägelseenheten, målet, observationstiden, beslutstiden, tillgängliga funktioner och kostnaden för varje fel. För en churn‑modell, till exempel, skulle användning av händelser som registrerats efter avbokning läcka svaret. Fastställ en enkel regel eller statistisk baslinje, dela sedan data efter tid, kund, plats eller en annan gräns som speglar distribution. Slumpmässiga raddelningar kan placera nästan identiska observationer i tränings‑ och testuppsättningar och ge ett missvisande resultat.
Funktionsteknik omvandlar råa poster till representationer som modellen kan använda, men varje funktion behöver ursprung och en tillgänglighetsgaranti. Anpassa normalisering, vokabulär, imputation och dimensionsreduktion endast på träningsdata, och tillämpa sedan den inlärda transformationen på validerings- och testdata. Korsvalidering uppskattar variation över prover; en slutgiltig opåverkad testuppsättning stödjer release‑beslutet. Välj mått utifrån konsekvenser: precision och återkallelse för ojämna klassificeringsfel, kalibrering när sannolikheter styr handling, samt kostnads‑ eller nyttighetsvägda mått när misstag har olika operativa effekter.
Distribution, övervakning och ansvarsfull drift
Produktionsinferens upprepar hela tränings‑tids‑transformationen och returnerar en förutsägelse under latens‑, genomströmning‑ och tillgänglighetsbegränsningar. Paketera förbehandling med modellen, validera inmatningsscheman, versionera artefakter och jämför resultat mellan offline‑ och serverimplementationer. Välj ett tröskelvärde baserat på driftkapacitet och felavvägning snarare än att standardvärdet 0,5 används. Rulla ut via skuggutvärdering, en begränsad kohort eller ett experiment med skyddsmått. Behåll en deterministisk reserv och en återställningsväg för beroendefel eller oacceptabelt beteende.
Övervaka inmatningskvalitet, funktions‑drift, förutsägelsefördelning, kalibrering, delgruppsresultat, latens, kostnad och bekräftade etiketter när de så småningom anländer. Drift är en signal att undersöka, inte ett automatiskt bevis på att om‑träning hjälper. Om‑träning kräver granskade data, repeterbara tester, godkännande och jämförelse med den nuvarande favoriten. Dokumentera avsedda och ogiltiga användningar, datarättigheter, integritet, säkerhet, mänsklig överskrivning och överklagande där människor påverkas. Maskininlärning är ett underhållet beslutssystem; modellfilen är bara en ersättningsbar komponent.
Arbetsexempel: förutsäga utrustningsfel
En tillverkare definierar en förutsägelse per maskin‑dag: huruvida ett verifierat fel kommer att inträffa inom sju dagar med endast telemetri som är tillgänglig i början av den dagen. Den delar upp efter maskin och tid, jämför med ålder‑ och tröskelbaserade regler, anpassar förbehandling på träningsdata och utvärderar händelseåterkallelse, falska larm, varningsfördröjning, kalibrering och underhållskapacitet. Sensorbyte och planerade avstängningar modelleras som operativ kontext snarare än att behandlas som vanliga observationer.
Modellen körs först i skuggläge. Larm visar bidragande telemetri och osäkerhet, men underhållspersonal beslutar om inspektion. Resultat och bekräftade orsaker blir styrda etiketter; avsaknad av en arbetsorder antas inte betyda inget fel. En stegvis utrullning använder larmgränser och en manuell reserv, medan övervakning spårar sensors hälsa, indata‑drift, granskad precision, driftstopp och onödigt underhåll. Om‑träning sker endast efter att data‑ och tröskelgranskning visar på en sannolik förbättring jämfört med det nuvarande distribuerade systemet.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionshanterad utvärderingsuppsättning innan justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter distribution snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återhämtning, incident‑lärande, raderings‑ och behållningsprocedurer samt en tydlig punkt där det bör inaktiveras eller ersättas.
Primära referenser