
Grunderna i AI
Vad är Support Vector Machines?

 Lägg till Unite.AI bland dina föredragna källor på Google
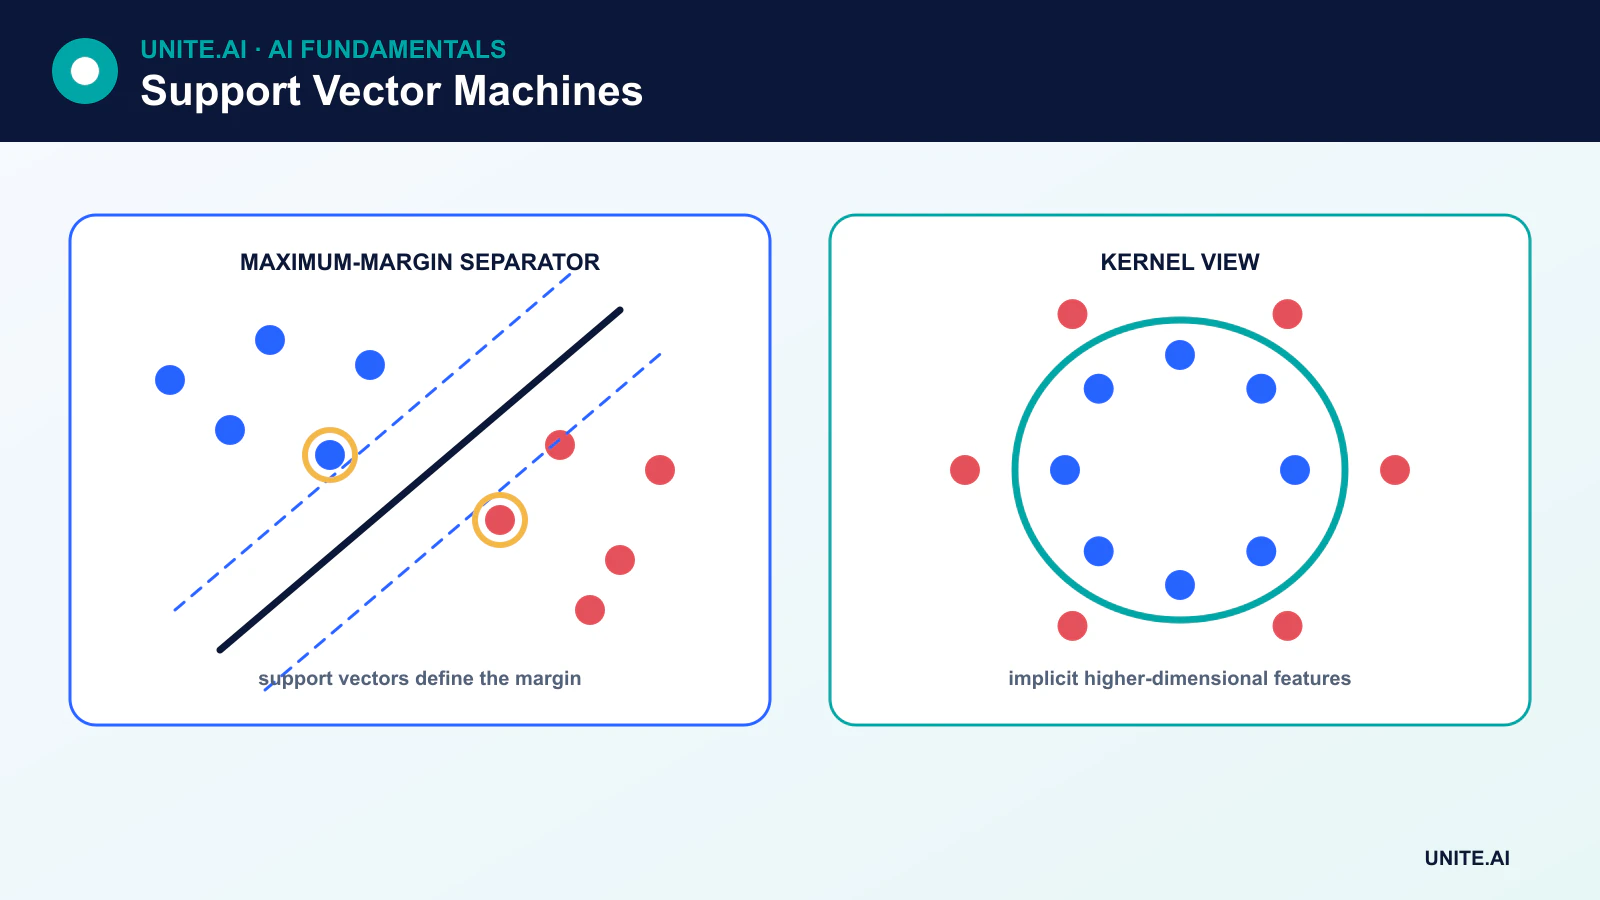
En supportvektormaskin (SVM) är en övervakad inlärningsmetod som hittar ett beslutsgränssnitt med den bredaste möjliga marginalen mellan klasserna. De träningsexempel som bestämmer den gränsen är supportvektorerna.
SVM:er kan utföra linjär eller icke‑linjär klassificering, regression och nyhetsdetektering. De är särskilt användbara för små till medelstora datamängder med informativa egenskaper, inklusive högdimensionell gles data, men deras träningskostnad kan bli opraktisk på mycket stora datamängder.
Viktiga slutsatser
- En SVM maximerar den minsta marginalen mellan gränsen och de närmaste träningspunkterna.
- Supportvektorer är datapunkter, inte ytterligare hyperplan.
- Parametern C balanserar marginalens bredd mot straff för överträdelser.
- Kärnor beräknar likhet i ett implicit funktionsrum utan att explicit materialisera varje transformerad egenskap.
Idén med maximal marginal
För en linjär binär klassificerare är beslutsgränsen ett hyperplan:
w · x + b = 0
Vektorn w bestämmer orienteringen och b förskjutningen. Många hyperplan kan separera träningsklasserna. SVM:n väljer det som maximerar avståndet till de närmaste exemplen på vardera sida. Dessa närmaste exempel är supportvektorerna och har störst påverkan på den anpassade gränsen.
Målet är inte att maximera avståndet från gränsen till varje punkt oberoende. Det maximerar den minsta marginalen samtidigt som det uppfyller eller straffar klassbegränsningar.
Hårda och mjuka marginaler
En hårdmarginal‑SVM kräver perfekt linjär separation och är känslig för outliers. Verkliga datamängder kräver vanligtvis en mjuk marginal, som introducerar slack‑variabler för observationer inom marginalen eller på fel sida av gränsen.
Hyperparametern C styr straffet för dessa överträdelser:
- Ett större C straffar överträdelser starkare och ger ofta en smalare marginal som följer träningsexemplen närmare.
- Ett mindre C tillåter fler överträdelser i utbyte mot en bredare, mer regulariserad marginal.
Antalet supportvektorer är ett resultat av data och lösning; en ökning av C garanterar inte ett specifikt antal supportvektorer.
Kärntricket
Vissa klasser kan inte separeras med ett rakt hyperplan i det ursprungliga funktionsrummet. En kärna beräknar en inre produkt som motsvarar ett annat funktionsrum. Detta låter SVM:n anpassa en icke‑linjär gräns utan att explicit beräkna varje transformerad koordinat.
Vanliga kärnor inkluderar:
- Linear: effektiva för högdimensionella glesa egenskaper såsom text.
- Polynomial: modellerar interaktioner upp till en vald grad.
- Radial basis function (RBF): skapar flexibla lokala gränser baserade på avstånd.
- Sigmoid: liknar en neuronal aktivering men är mindre vanligt som standardval.
För en RBF‑SVM styr gamma hur lokalt varje träningsexempel påverkar gränsen. Stor gamma kan skapa mycket detaljerade regioner och överanpassa; liten gamma ger en mjukare påverkan.
Multiklassklassificering
Det klassiska SVM‑målet är binärt. Bibliotek utökar det med strategier som one‑vs‑rest, som tränar en klassificerare per klass, eller one‑vs‑one, som tränar klassificerare för klasspar och kombinerar deras beslut. Multiklass‑SVM:er ritar inte bara en linje färre än antalet klasser.
Supportvektorregrering och one‑class‑SVM
Supportvektorregrering (SVR) anpassar en funktion medan fel inom ett epsilon‑brett rör ignoreras och större avvikelser straffas. En one‑class‑SVM uppskattar en gräns kring typisk data och kan stödja nyhetsdetektering. En ovanlig punkt är inte automatiskt bedrägeri eller fel; den är ovanlig under den anpassade representationen.
Praktiska krav
SVM:er är beroende av avstånd och inre produkter, så numeriska egenskaper behöver vanligtvis skalning. C, kärna, gamma och klassvikt bör väljas genom validering. Sannolikhetsestimat är inte inneboende i marginalen och kräver ofta kalibrering, vilket medför extra kostnad och bör utvärderas separat.
Träning av kernel‑SVM kan skala mellan kvadratisk och kubisk tid i förhållande till antalet prover, beroende på data och implementation. Linjära SVM‑varianter eller stokastiska linjära modeller är bättre lämpade för mycket stora datamängder. För råa bilder, ljud eller språk kan inlärda representationer från deep learning vara mer effektiva, medan en SVM fortfarande kan klassificera en fast inbäddning.
SVM:s styrkor och begränsningar
SVM:er kan fungera bra med många egenskaper, erbjuder ett tydligt regulariserat mål och är främst beroende av supportvektorer vid prediktion. Begränsningar inkluderar känslighet för skalning och hyperparametrar, potentiellt dyr träning, minskad tolkbarhet under icke‑linjära kärnor samt krav på sannolikhetskalibrering.
Marginaler, kärnor och optimeringsmålet
En supportvektormaskin söker ett separerande hyperplan med en stor marginal mellan klasserna. Endast supportvektorer på eller inom marginalen bestämmer gränsen. Soft‑margin‑SVM:er introducerar slack för överlappning och felmärkta punkter; parametern C byter en bredare marginal mot träningsöverträdelser. Inmatningar bör vanligtvis skalas eftersom avstånd och skalärprodukter driver lösningen. Klassvikt eller omprovtagning hjälper när felkostnader och förekomst är ojämna, men trösklar och sannolikheter kräver fortfarande oberoende validering.
Kärntricket utvärderar likhet som om indata mappades till ett högdimensionellt funktionsrum. Linjära, polynomiska, radial‑basis och specialiserade kärnor kodar olika antaganden. För en RBF‑kärna styr gamma hur lokalt varje punkt påverkar gränsen: hög gamma kan skapa invecklade regioner och överanpassa, medan låg gamma kan underanpassa. Kärmatriser växer kvadratiskt med antalet prover, vilket gör icke‑linjära SVM:er dyra på stora datamängder. Linjära lösare eller approximativa funktionskartor är ofta att föredra i skala.
Multiklassanvändning, kalibrering och operativa begränsningar
Binära SVM:er utökas till multiklass genom one‑vs‑rest, one‑vs‑one eller strukturerade formuleringar. Hyperparametrar måste justeras inom korsvalidering, med grupperade eller tidsmässiga delningar vid behov. Utvärdera klassspecifik precision och recall, marginalfördelningar, kalibrering och prestanda under förskjutning. Råa beslutsvärden är inte sannolikheter; Platt‑skalning eller isotonskalering använder separat data och kan försämras om förekomsten förändras. Jämför med logistisk regression, träd och moderna representationsbaserade metoder med motsvarande förbehandling och justeringsinsats.
Drift kräver exakt skalare, funktionsordning, kärnparametrar, supportvektorer och klassmappning. Prediktionskostnaden för en kernel‑SVM ökar med antalet supportvektorer, så mät latens och minne på realistiska batcher. Inmatningar som ligger långt från träningssupport kan fortfarande få säkra etiketter; lägg till out‑of‑distribution‑kontroller eller en avståendepolicy där det är lämpligt. Inspektera fel för känsliga proxyer och dataset‑artefakter. SVM:er förblir starka för medelstora, högdimensionella problem, men en maximal geometrisk marginal är ingen bevis på kausal struktur eller säkerhet.
Arbetsexempel: en SVM för sällsynt dokumentruttning
Ett juridiskt operativteam klassificerar korta inlagor i routningskategorier med TF‑IDF‑egenskaper och en linjär SVM. Det delar upp efter ärende och tid för att förhindra att mallar läcker, skalar klassvikter baserat på granskad felkostnad och justerar C inom inbäddad validering. Den linjära modellen jämförs med logistisk regression och en transformer. Precision, recall, kalibrering och granskarnas arbetsbelastning per klass är viktigare än den totala noggrannheten.
Beslutsvärden kalibreras på separat data, och dokument med låg marginal eller språk som inte stöds skickas till manuell mottagning. Driftsartefakten innehåller tokeniserare, vokabulär, viktning, modell, kalibrering och etikettkarta. Övervakning spårar nya termer, kategoriförekomst, marginaler och korrigerade rutter. Dokument och supportvektorer skyddas eftersom textegenskaper kan avslöja konfidentiell information. En icke‑linjär kärna avvisas när dess lilla kvalitetsförbättring inte kan motivera latens, minne och tolkbarhetskostnad.
Implementationsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för respons, och granska verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återhämtning, incident‑lärande, raderings‑ och behållningsrutiner samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Utför SVM:er endast klassificering?
Nej. Supportvektorregrering förutsäger kontinuerliga mål, medan en one‑class‑SVM kan uppskatta en nyhetsgräns. Varje variant har ett annat mål och en annan uppsättning hyperparametrar.
När är en linjär SVM ett starkt val?
Linjära SVM:er är ofta effektiva för högdimensionella glesa egenskaper, inklusive traditionella textrepresentationer, där en flexibel kärna skulle tillföra kostnad utan tydlig nytta.
Primära referenser












