
Grunderna i AI
Vad är ett beslutsträd?

 Lägg till Unite.AI bland dina föredragna källor på Google
Ett beslutsträd är en övervakad inlärningsmodell som gör en förutsägelse genom att tillämpa en sekvens av om‑så‑regler. Varje intern nod testar en egenskap, varje gren representerar ett utfall av den testen, och varje blad producerar en klassförutsägelse, sannolikhet eller numeriskt värde.
Beslutsträd används för klassificering och regression. Deras fördel är praktisk: de kan representera icke‑linjära interaktioner, kräver relativt lite förbehandling och producerar en väg som en person kan inspektera. Deras svaghet är instabilitet – små förändringar i träningsdata kan skapa ett annat träd.
Viktiga slutsatser
- Ett träd partitionerar rekursivt funktionsrymden; det behöver inte isolera varje träningsobservation.
- Klassificeringsdelningar använder vanligtvis Gini‑impuritet eller entropi, medan regressionsdelningar minskar förutsägelsefel eller varians.
- Djup, minsta bladstorlek och beskärning styr komplexitet och överanpassning.
- Random forests och gradientförstärkta träd förbättrar prediktiv styrka genom att kombinera många träd.
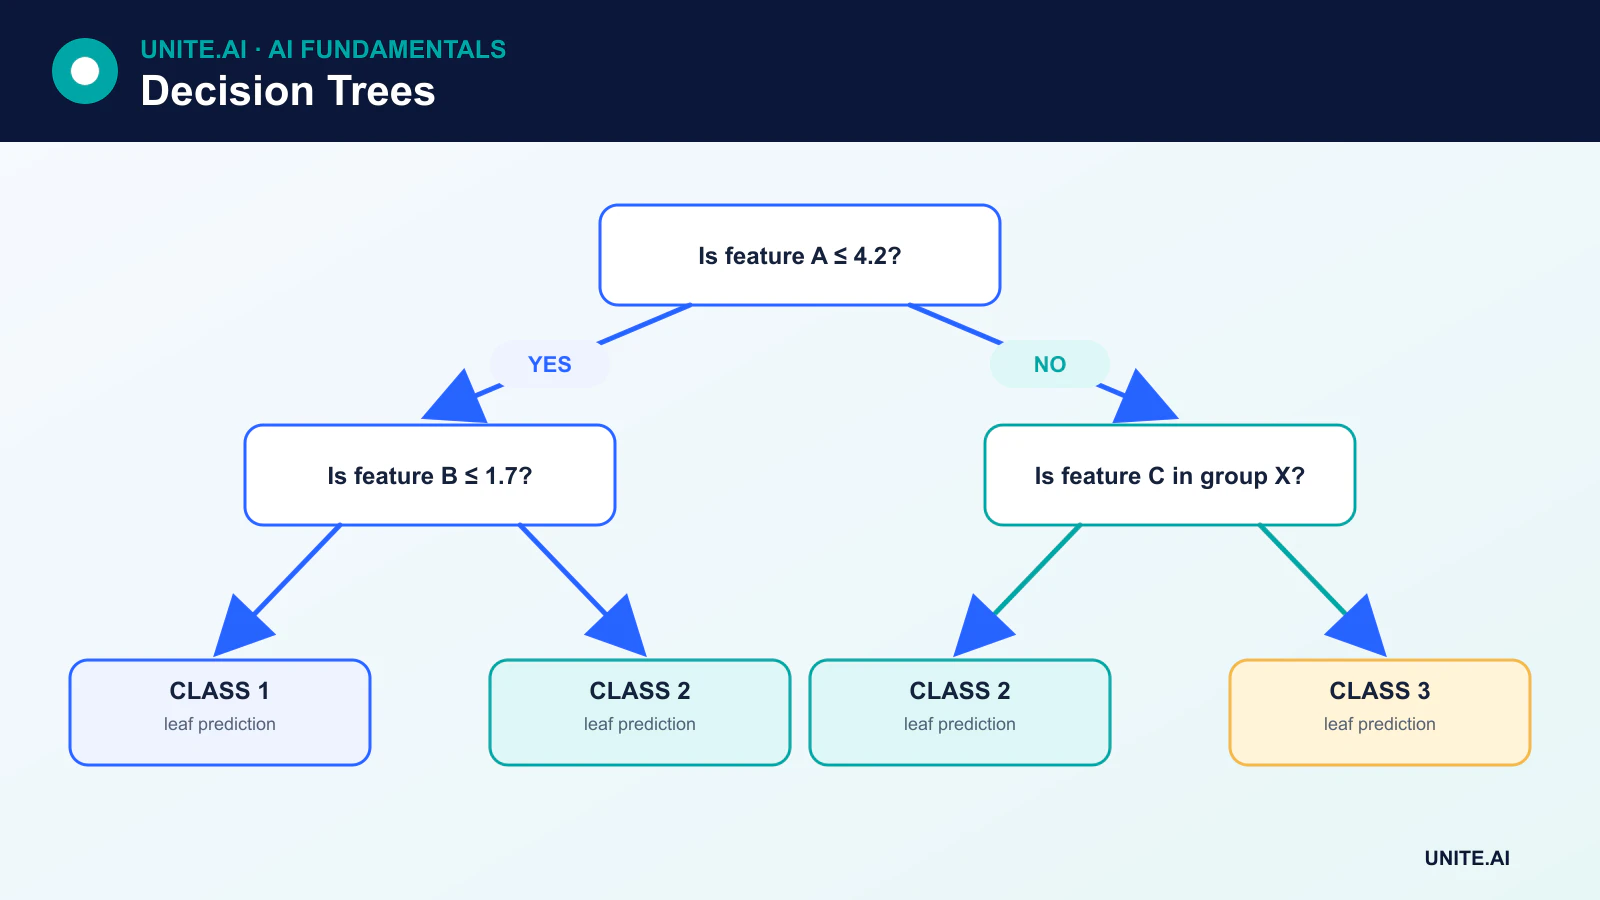
Hur ett beslutsträd gör en förutsägelse
Anta att en modell förutsäger om en maskin sannolikt kommer att gå sönder. Rotnoden kan fråga om vibrationerna överstiger ett inlärt tröskelvärde. En gren kan sedan testa driftstemperaturen. Observationen når ett blad som innehåller den uppskattade felprobabiliteten bland träningsexemplen som följde samma väg.
För regression kan bladet returnera medelvärdet av målvariabeln för observationerna i den regionen. För klassificering kan det returnera majoritetsklassen eller en fördelning av klassfrekvenser. Ett blad kan innehålla många observationer; att helt separera träningsdata är vanligtvis oönskat eftersom det kan leda till ett överanpassat träd.
Hur ett träd väljer en delning
Träning överväger kandidat‑egenskaper och tröskelvärden och väljer sedan den delning som förbättrar det definierade målet mest. Förbättringen måste viktas efter hur många observationer som går till varje barnnod.
Gini‑impuritet
För klassificering mäter Gini‑impuritet hur blandade klasserna är i en nod:
Gini = 1 - Σ p(k)²
En nod som bara innehåller en klass har impuritet noll. En kandidatdelning är användbar när den viktade impuriteten hos dess barn är lägre än förälderns impuritet.
Entropi och informationsvinst
Entropi är ett annat mått på klassosäkerhet:
Entropy = -Σ p(k) log₂ p(k)
Informationsvinst är föräldraentropin minus den viktade barnentropin. Gini och entropi ger ofta liknande träd, men inte alltid identiska.
Regressionsförlust
Regressionsträd väljer vanligtvis delningar som minskar kvadratiskt fel, absolutfel eller ett annat regressionskriterium. Varje blad förutsäger sedan ett värde baserat på träningsmålen i den regionen.
CART och andra trädalgoritmer
CART, eller Classification and Regression Trees, använder binära delningar och ligger till grund för vanliga implementationer såsom scikit-learn:s beslutsträd. Andra algoritmer inkluderar ID3, C4.5 och C5.0. Implementationer skiljer sig åt i vilka delningstyper de stödjer, hantering av saknade värden, beskärning och mål.
Kategoriska variabler kan kräva kodning, direkta delningar av delmängder eller implementationsspecifik hantering. Saknade värden kan imputeras eller hanteras via inlärda standardsriktningar eller surrogatdelningar. Det är viktigt att förstå beteendet hos det specifika biblioteket snarare än att anta att alla trädimplementationer fungerar på samma sätt.
Styrning av trädets komplexitet
Ett djupt träd kan memorera brus. Vanliga kontroller inkluderar:
- Maximalt djup: begränsar längden på en förutsägelseväg.
- Minsta antal prover per delning eller blad: förhindrar mycket små regioner.
- Minsta impuritetsminskning: kräver att en delning ger tillräcklig nytta.
- Maximalt antal blad: sätter en gräns för total komplexitet.
- Kostnads‑komplexitetsbeskärning: tar bort grenar vars förbättring inte motiverar den extra komplexiteten.
Beskärning är en strukturerad optimeringsprocess, inte slumpmässig borttagning. Hyperparametrar bör väljas med valideringsdata eller korsvalidering, medan det slutgiltiga testsetet förblir orört.
Styrkor och begränsningar
Beslutsträd kan modellera interaktioner och tröskeleffekter utan skalning av egenskaper. De accepterar numeriska och, beroende på implementationen, kategoriska indata. Förutsägelsen är snabb och ett litet träd är lätt att visualisera.
Dock kan ett enskilt träd ha hög varians, skapa plötsliga förändringar i förutsägelsen nära en delning och föredra egenskaper med många möjliga delningspunkter. Träd extrapolerar också dåligt i regression: utanför de observerade regionerna returnerar ett blad fortfarande ett värde som lärts från dess träningsprover. Ett stort träd kan vara lika svårt att förstå som en annan komplex modell.
Från ett träd till ensembler
Ensemble learning kombinerar flera modeller. En random forest tränar många träd på omsamplade observationer och delmängder av egenskaper, och medelvärdesberäknar sedan deras förutsägelser. Gradient boosting bygger träd sekventiellt så att varje nytt träd hanterar återstående fel. Dessa metoder överträffar vanligtvis ett enskilt träd, men de offrar en del av tolkbarheten och ökar den beräkningsmässiga kostnaden.
Funktionsvikt från ett träd eller en ensemble bör tolkas försiktigt. Impuritet‑baserad vikt kan vara partisk, och en funktions vikt bevisar inte orsakssamband. Permutationsvikt, verktyg för partiell beroende och domängranskning ger ytterligare kontext.
Hur ett träd lär sig delningar och förutsägelser
Ett beslutsträd partitionerar rekursivt funktionsrymden. Vid varje nod utvärderar ett träningsalgoritm kandidat‑egenskapströsklar eller kategoripartitioner och väljer den delning som mest minskar impuritet, såsom Gini‑impuritet eller entropi för klassificering och kvadratiskt fel för regression. Bladen lagrar en klassfördelning eller numerisk förutsägelse baserad på träningsobservationerna som når dem. Girig delning är beräkningsmässigt praktisk men garanterar inte det globala bästa trädet, och olika prov eller tiebreak‑strategier kan ge olika strukturer.
Kontinuerliga, ordnade, kategoriska och saknade egenskaper kräver explicit hantering. One‑hot‑kodning kan skapa många kandidatdelningar; inbyggda kategoriska metoder kan använda ordnade statistiker men kräver läckagesäker implementation. Träd kräver ingen skalning, men kan föredra variabler med hög kardinalitet och isolera små grupper. Djup, minsta bladstorlek, minsta impuritetsminskning och kostnads‑komplexitetsbeskärning styr varians. Välj dem med valideringsdata och utvärdera kalibrering, eftersom en bladprobabilitet baserad på få fall kan bli extrem och instabil.
Tolkning, felbeteenden och produktionsanvändning
En väg från rot till blad är en exakt regel för en modellförutsägelse, men den är inte automatiskt en kausal förklaring. Korrelerade variabler kan ersätta varandra, små datamängdsförändringar kan förändra övre delningar, och en enkel väg kan bero på partiska etiketter. Global funktionsvikt baserad på impuritet kan vara missvisande; permutationsvikt, partiell beroende och kontrafaktiska kontroller ger kontext men har också förutsättningar. Rapportera osäkerhet och testa om en påstådd regel håller på oberoende data och relevanta undergrupper.
Enstaka träd är användbara när transparens, låg latens och måttlig icke‑linjär struktur är viktiga, men ensembler ger oftast starkare prediktiv prestanda. Validera gränsbeteende, sällsynta kategorier, saknad data och indata utanför träningsintervallet. Exporterade regler måste exakt reproducera träningsförbehandling och numeriska jämförelser. Övervaka bladens beläggning, utskottsfördelning, fel och framväxande kategorier. Ett träd som dirigerar många nya fall till en liten eller tidigare tom region bör trigga granskning även om den totala drift är liten. Behåll en reservlösning för ogiltiga scheman och dokumentera varje beskärning eller tröskelbeslut.
Arbetsexempel: ett tolkningsbart lånetriage‑träd
En långivare använder ett träd enbart för att prioritera ofullständiga ansökningar för manuell granskning, inte för att bevilja eller avslå kredit. Målet är ett dokumenterat fullständighetsresultat, och de funktioner som finns tillgängliga vid intag exkluderar senare beslut. Grupperad tidsvalidering jämför ett grunt beskuret träd med regler och logistisk regression. Minsta bladstorlek förhindrar regler baserade på ett fåtal sökande, medan kalibrering och klassspecifika fel rapporteras över kanaler och relevanta skyddade grupper.
Granskarna ser den exakta vägen och källvärdena men kan korrigera felaktiga data och åsidosätta routingen. Organisationen testar korrelerade proxyer och kontrafaktiska förändringar, övervakar bladens beläggning och saknad data, och behandlar plötslig trafik till ett litet blad som ett datakvalitetsincident. Policyförändringar skapar en ny modellversion och validering, inte en odokumenterad delningsändring. Eftersom användningen påverkar åtkomst och börda får sökande en mänsklig kanal och trädet presenteras aldrig som en kausal förklaring av kreditvärdighet.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionerat evalueringsset innan finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reservlösning och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indatakvalitet, utdatabeteende, modell‑ eller regelversion, beroendehälsa, mänskliga åsidosättningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incident‑lärande, raderings‑ och lagringsrutiner samt en tydlig punkt där det bör inaktiveras eller ersättas.
Primära referenser












