Grunderna i AI
Övervakad vs oövervakad inlärning

 Lägg till Unite.AI bland dina föredragna källor på Google
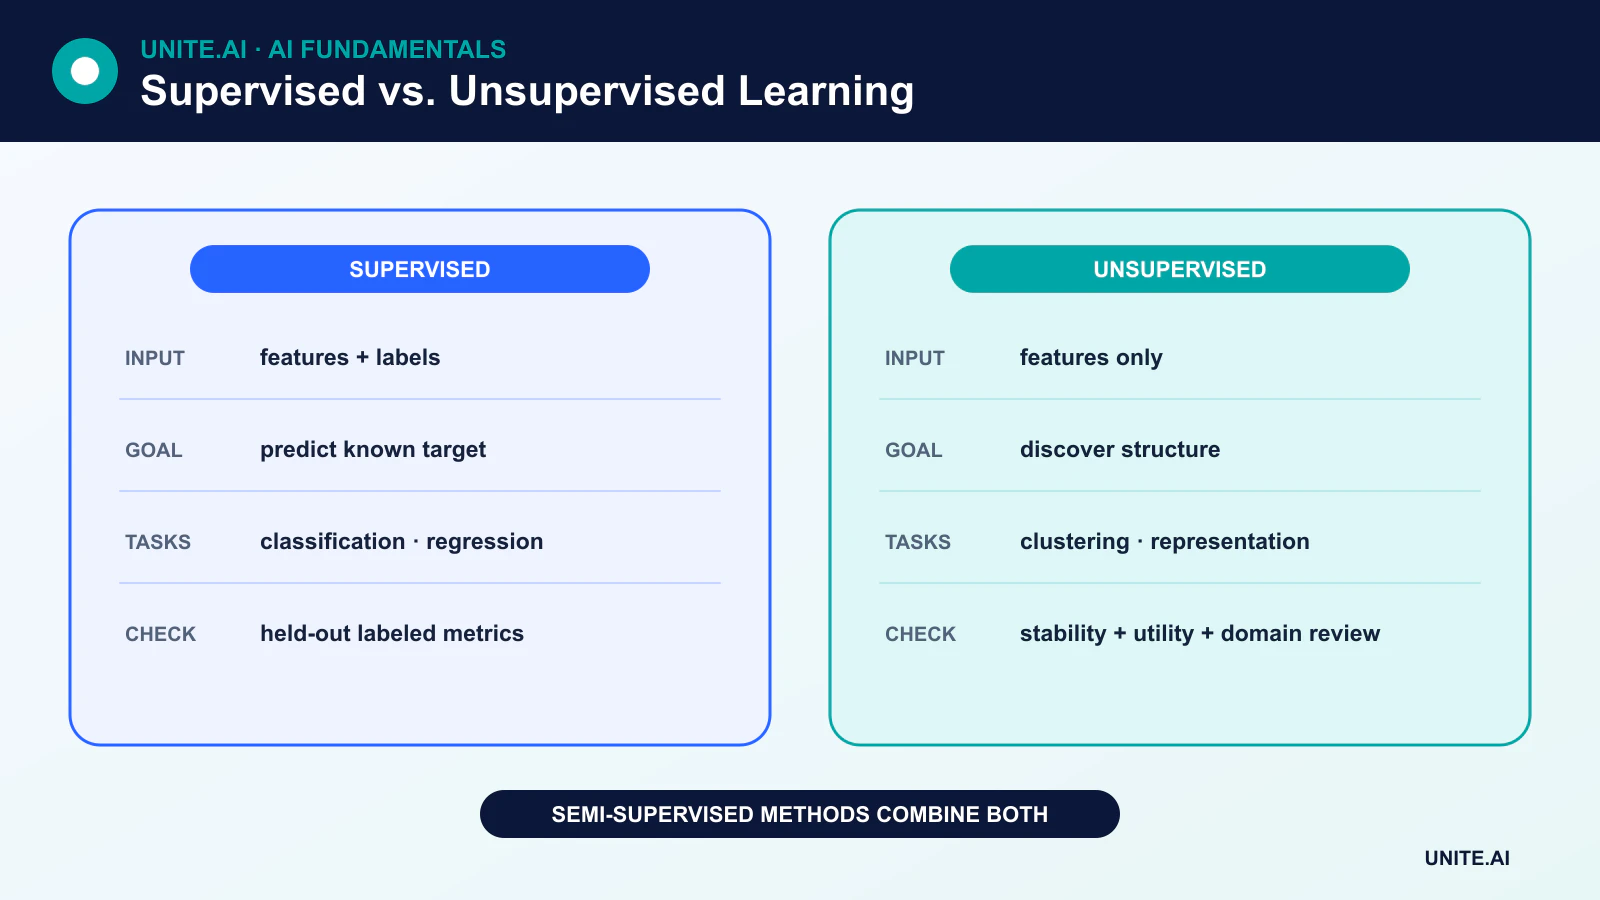
Övervakad inlärning lär sig från exempel som är parade med mål‑svar. Oövervakad inlärning söker efter struktur i data utan mål‑etiketter. Skillnaden handlar inte om vilken metod som är mer intelligent eller exakt; det handlar om vilken typ av inlärningssignal som finns tillgänglig och vilken fråga systemet är designat att besvara.
Detta är två stora paradigm inom maskininlärning, men moderna system använder också semi‑övervakad, själv‑övervakad och förstärkningsinlärning.
Viktiga slutsatser
- Övervakad inlärning förutsäger ett känt mål; oövervakad inlärning upptäcker mönster eller representationer.
- Klassificering och regression är övervakade uppgifter; klustring, densitetsuppskattning och många dimensionell‑reduktionsmetoder är oövervakade.
- Resultat från oövervakad inlärning blir inte automatiskt verkliga klasser och kan vara svårare att utvärdera.
- Beräkningskostnad och noggrannhet beror på algoritmen, data, uppgift och utvärdering – inte bara på paradigm.
Hur övervakad inlärning fungerar
Ett övervakat dataset innehåller funktioner X och ett mål y. Träning justerar en modell så att dess förutsägelser närmar sig målen. Utvärdering använder avsatta märkta exempel för att uppskatta hur väl den generaliserar.
Klassificering
Klassificering förutsäger en kategori: skräppost eller inte skräppost, ett dokumentämne bland flera, eller ett eller flera objekt i en bild. Relevanta mått inkluderar precision, recall, F1, kalibrering och kostnadskänsliga mått. Noggrannhet kan vara missvisande när en klass är sällsynt; en förvirringsmatris visar vilka klasser som förväxlas.
Regression
Regression förutsäger ett kontinuerligt värde, såsom efterfrågan, varaktighet eller temperatur. Linjär regression kan använda en eller många funktioner; den är inte begränsad till att beskriva ett förhållande mellan två variabler. Regressionsmått inkluderar medelabsolutfel, rotmedelkvadratfel och uppgiftsspecifika kostnader.
Vanliga övervakade algoritmer
Övervakade metoder inkluderar linjära och logistiska modeller, beslutsträd, slumpmässiga skogar, gradientförstärkning, stödvektormaskiner, K-närmaste grannar och neurala nätverk.
Logistisk regression ger ett poängvärde eller sannolikhet som kan omvandlas till en klass med en vald tröskel. Ett blad i ett beslutsträd innehåller en förutsägelse baserad på ett område i funktionsrummet, inte nödvändigtvis en enskild träningsobservation. KNN förutsäger utifrån närliggande märkta träningsexempel och kräver fortfarande en väl utformad tränings/validerings/testdesign.
Hur oövervakad inlärning fungerar
Oövervakad inlärning får funktioner utan en målkolumn. Dess mål definieras indirekt – till exempel att minimera avstånd inom kluster, rekonstruera en indata, uppskatta datadensitet eller behålla så mycket varians som möjligt i färre dimensioner.
Klustring
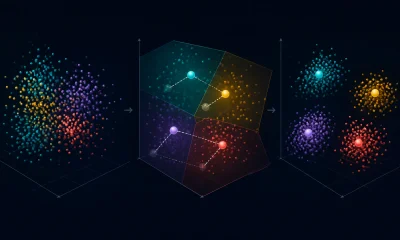
K-means tilldelar punkter till ett valt antal kluster och uppdaterar klustercenter för att minska den kvadratiska avståndet inom klustret. Algoritmen upptäcker geometriska grupperingar under en viss avstånds- och funktionsrepresentation. Dessa grupper motsvarar inte automatiskt meningsfulla kundtyper, diagnoser eller andra domänetiketter.
Dimensionell reduktion
Dimensionell reduktion representerar data med färre variabler. Principal component analysis (principalkomponentanalys) hittar ortogonala riktningar som behåller så mycket varians som möjligt under en linjär projektion. Andra metoder bevarar olika strukturbegrepp och kan producera mycket olika visualiseringar.
Avvikelse- och densitetsuppskattning
Oövervakade metoder kan uppskatta var data är tät och flagga ovanliga observationer. En avvikelsescore bevisar inte bedrägeri, fel eller skadligt beteende; den identifierar en avvikelse under den valda representationen och modellen.
Hur oövervakad inlärning utvärderas
Det finns ingen universell definition av oövervakad “noggrannhet”. En praktiker kan använda interna mått såsom silhuett‑score, jämföra stabilitet över prov, testa nytta i en efterföljande uppgift, eller fråga domänexperter om den upptäckta strukturen är meningsfull. Om sanningsgrundade etiketter finns för utvärdering kan externa klustringsmått användas utan att göra träningsprocessen till övervakad inlärning.
Bortom tvåvägsjämförelsen
Semi‑övervakad inlärning
Semi‑övervakad inlärning kombinerar en mindre märkt mängd med en större omärkt mängd. Pseudo‑etikettering, konsistens‑regularisering och graf‑baserade metoder är exempel. Den omärkta datan måste fortfarande likna mål‑distributionen tillräckligt för att vara till hjälp.
Själv‑övervakad inlärning
Själv‑övervakad inlärning härleder mål från själva indata, såsom att förutsäga maskerade token eller matcha transformerade vyer. Det är en grund för moderna språk-, bild- och multimodala modeller, inklusive transformers.
Förstärkningsinlärning
Förstärkningsinlärning optimerar beslut genom belöningar som genereras av interaktion. Den skiljer sig både från märkta förutsägelser och statisk mönsterupptäckt.
Välja rätt tillvägagångssätt
Börja med beslutet eller insikten som systemet måste leverera. Om pålitliga mål finns och förutsägelse är målet är övervakad inlärning naturlig. Om målet är utforskning, representation eller gruppering kan en oövervakad metod passa. När etiketter är knappa kan själv‑övervakad eller semi‑övervakad förträning följt av övervakad utvärdering vara mer effektiv.
I alla fall kan data‑läckage, snedvriden sampling, svaga proxy‑variabler och fördelningsskift dominera valet av algoritm. En tekniskt korrekt modell som tränas på fel mål kan ändå misslyckas.
Inlärningssignaler, mål och representativa metoder
Övervakad inlärning använder exempel parade med mål‑etiketter eller värden och optimerar prediktionsfel. Klassificering, regression, rankning och strukturerad förutsägelse skiljer sig åt i output och förlust. Oövervakad inlärning söker struktur utan mål‑etiketter genom klustring, densitetsuppskattning, dimensionell reduktion, representationsinlärning eller generativ modellering. Själv‑övervakad inlärning skapar förutsägelsemål från själva datan, medan semi‑övervakad inlärning kombinerar en liten märkt mängd med större omärkt data. Dessa kategorier beskriver inlärningssignalen; samma neurala arkitektur kan tränas under flera paradigm.
Etiketter gör ett mål explicit men medför annoteringskostnad, brus, policy‑antaganden och tidsfördröjning. Omärkt data är enklare att samla men berättar inte för en algoritm vilken upptäckt struktur som är användbar. Ett kluster kan spegla belysning, dokumentlängd eller insamlingskälla istället för en meningsfull kategori. Definiera utvärdering oberoende: övervakade modeller använder avsatta märkta resultat, medan oövervakade modeller behöver stabilitet, rekonstruktion, sannolikhet, återhämtning, efterföljande nytta eller expertvalidering. Visuell separation ensam är inte bevis på en giltig struktur.
Välja ett paradigm och förebygga vanliga fel
Använd övervakad inlärning när ett stabilt mål och representativa etiketter finns. Använd oövervakad utforskning för att sammanfatta, upptäcka nyheter, komprimera eller generera hypoteser, men behandla resultat som provisoriska. Själv‑övervakad förträning är värdefull när rådata är riklig och efterföljande uppgifter delar representationer. Semi‑övervakade metoder hjälper endast när antaganden om omärkt data och klassstruktur håller. Jämför med enkla baslinjer och beakta den totala kostnaden för insamling, märkning, granskning, beräkning och fel istället för att anta att omärkt automatiskt är billigt.
Förhindra läckage genom att separera relaterade enheter innan etiketter, augmentationer eller pseudo‑etiketter härleds. Övervaka klassbalans, annoteringsöverensstämmelse, klusterstabilitet, kollaps och drift. Pseudo‑etiketter kan förstärka tidiga misstag; klustring kan koda känsliga attribut; en förtränad representation kan överföra källbias. Mänsklig granskning bör fokusera på gränsfall och konsekvenser. I produktion, dokumentera hur inlärningssignalen skapades och när den blir föråldrad. Paradigmet bestämmer var övervakning införs i systemet, inte om mänskliga val och värderingar finns.
Praktiskt exempel: upptäcka och märka supportämnen
Ett företag använder först oövervakade inbäddningar och klustring för att utforska teman i avidentifierade supportmeddelanden. Analytiker granskar representativa och gränsfallsexempel och upptäcker att vissa kluster speglar meddelandelängd och kanal snarare än problem. De utvecklar en övervakad taxonomi med en okänd klass, annoteringsriktlinjer och uppmätt överensstämmelse. En klassificerare utvärderas sedan på senare tidsperioder, språk och produkter mot nyckelords‑ och närmaste‑granne‑baslinjer.
Oмärkta nya meddelanden möjliggör driftupptäckt men tränar inte klassificeraren automatiskt. Granskare märker utvalda osäkra och framväxande fall genom aktiv inlärning, med kvalitetskontroller och en sluten utvärderingsuppsättning. Övervakning spårar ämnesförekomst, förtroende, oenighet och routningsresultat. När en ny produkt lanseras uppdateras taxonomin och kapaciteten hos efterföljande team samtidigt. Arbetsflödet använder oövervakade metoder för hypotesgenerering och övervakade bevis för operativ routning.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ansvarig och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionshanterad utvärderingsuppsättning innan finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som mest sannolikt är underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indatakvalitet, utdatabeteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter driftsättning istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incident‑lärande, raderings‑ och bevarandepolicyer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Primära referenser