Grunderna i AI
Vad är K-means-klustring?

 Lägg till Unite.AI bland dina föredragna källor på Google
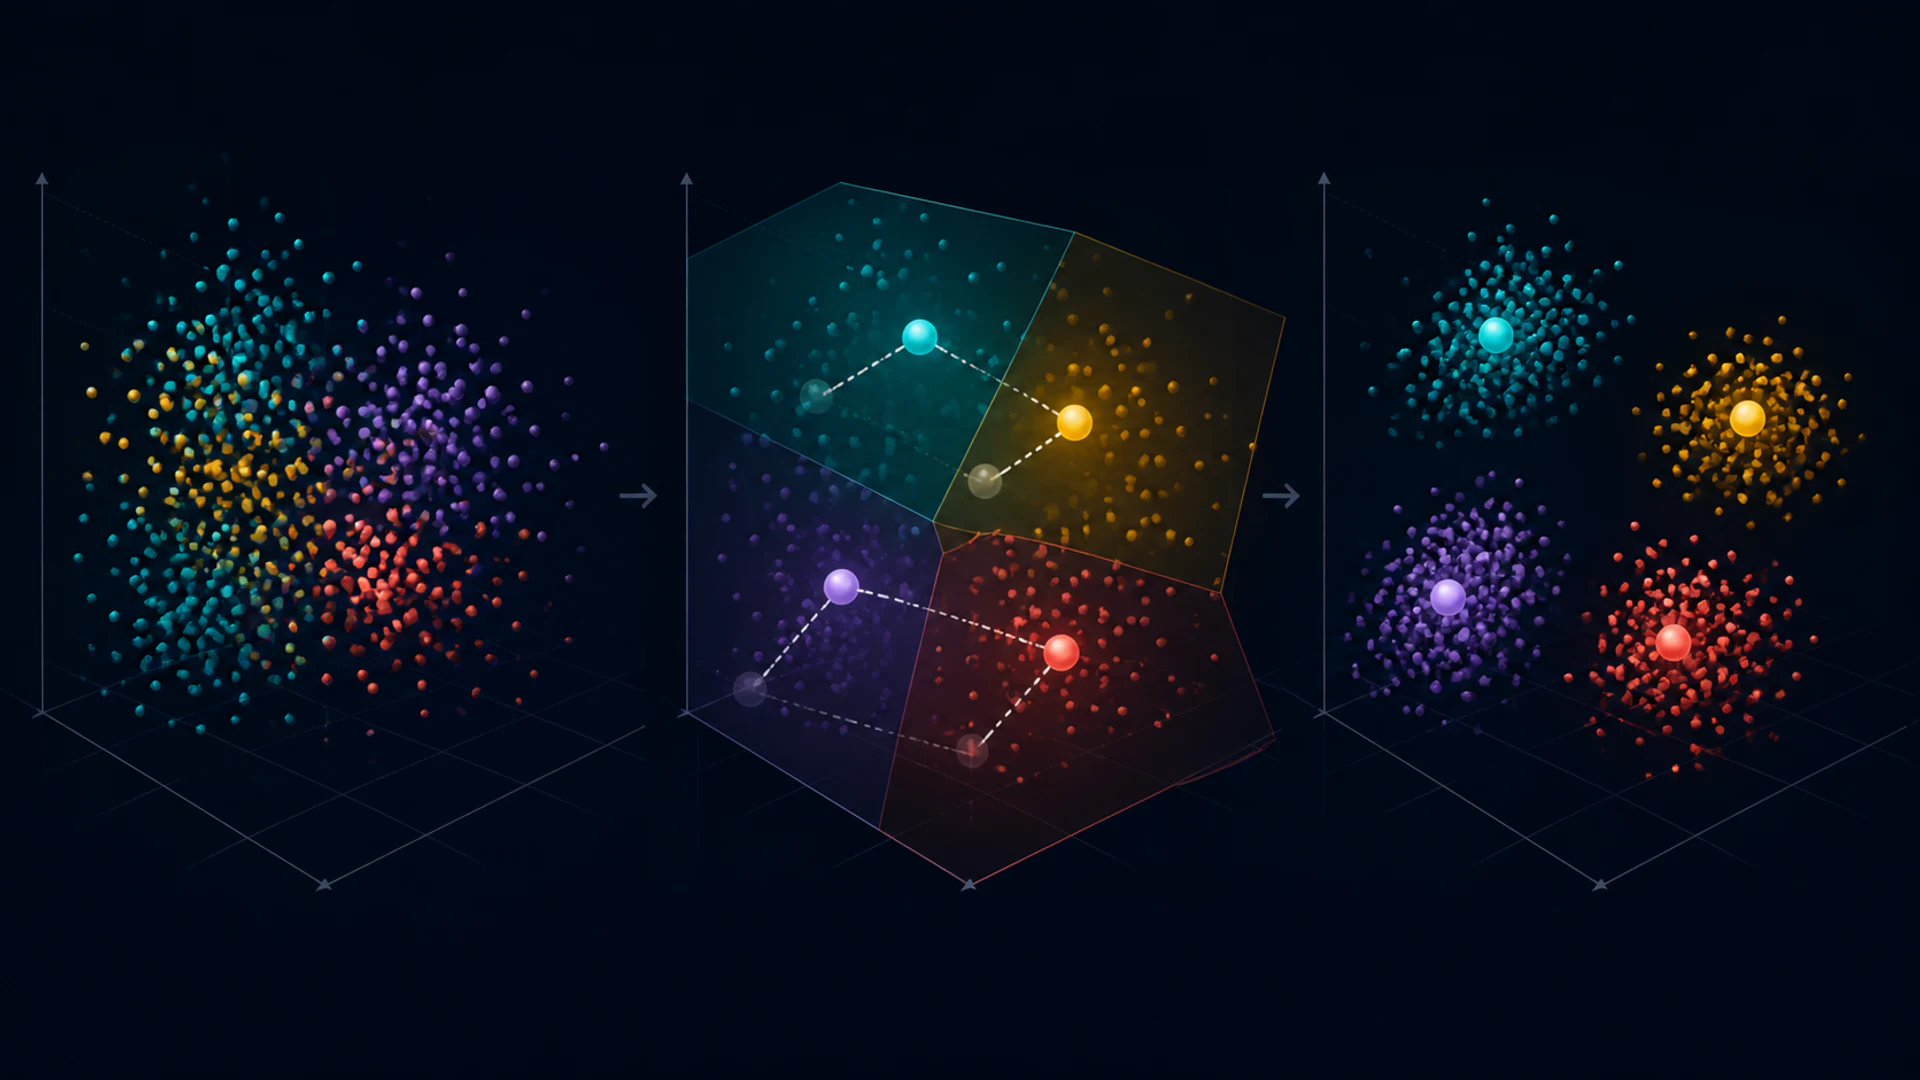
K-means är en oövervakad algoritm som delar in numeriska observationer i k kluster. Den växlar mellan att tilldela varje punkt till dess närmaste centroid och att omräkna varje centroid som medelvärdet av de tilldelade punkterna.
Algoritmen är snabb och användbar, men dess resultat påverkas av skalning, avstånd, initiering och det valda k. Ett kluster är en matematisk partition, inte automatiskt en verklig kategori.
Viktiga slutsatser
- K-means minimerar det kvadrerade euklidiska avståndet inom klustren till centroids.
- Initiering är viktig; k-means++ sprider start‑centroids och förbättrar vanligtvis resultaten.
- Standardisera funktioner när deras enheter eller skalor bör bidra jämförbart.
- K-means har problem med outliers, icke‑sfäriska kluster, ojämna densiteter och kategoriska data.
Målet och uppdateringsloopen
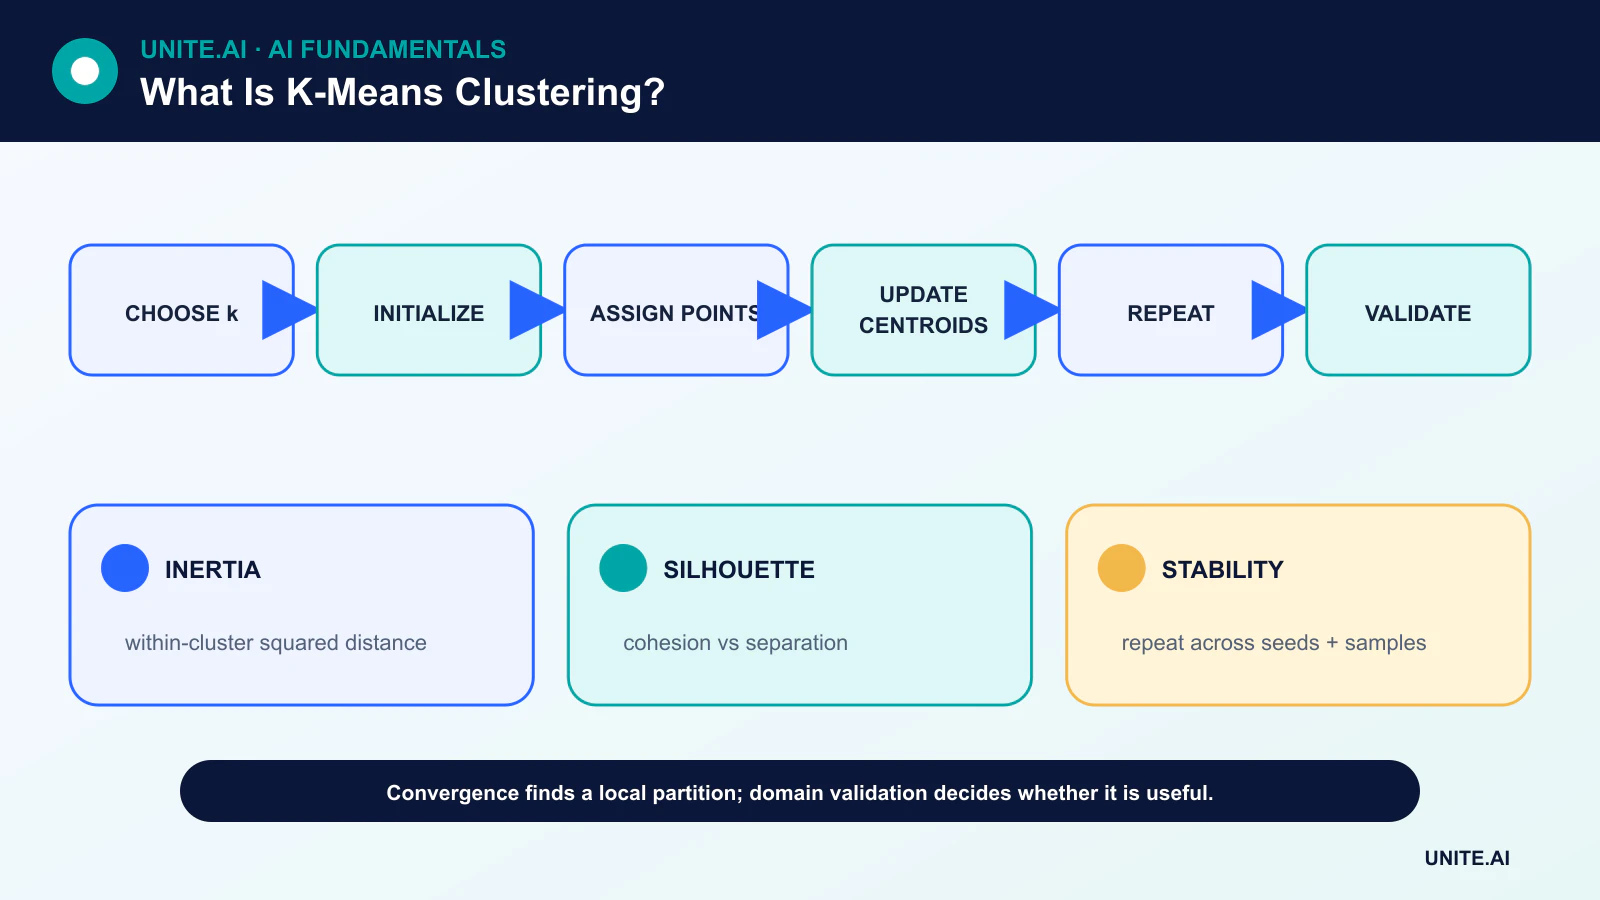
Givet k centroids skickar tilldelningssteget varje observation till den närmaste. Uppdateringssteget ersätter varje centroid med medelvärdet av dess tilldelade observationer. Summan av kvadrater inom klustret kan inte öka under dessa steg, så processen konvergerar till ett lokalt optimum.
Konvergens garanterar inte det globala optimumet. Olika initiala centroids kan leda till olika partitioner, vilket är anledningen till att implementationer kör flera initieringar och behåller lösningen med lägst inerti.
Initiering och k-means++
Att slumpmässigt välja alla start‑centroids från en tät region kan ge en dålig lösning eller långsam konvergens. K-means++ väljer frön med sannolikhet relaterad till avståndet från befintliga frön, vilket uppmuntrar täckning av datasetet.
Flera körningar är fortfarande användbara. Registrera den slumpmässiga fröet och antalet initieringar så att resultaten kan reproduceras.
Skalning och avstånd
Det kvadrerade euklidiska avståndet gör K-means känslig för enheter. En funktion som mäts i tusental kan dominera en annan som mäts mellan noll och ett. Standardisering är vanligt, men domänkunskap bör avgöra om lika standardiserad varians speglar lika viktig.
Outliers kan dra ett medelvärde långt från typiska punkter. Robust skalning, beskärning eller metoder baserade på medoid kan vara bättre. One‑hot‑kategoriska funktioner skapar en avståndsgeometri som kanske inte motsvarar kategoris likhet.
Val av k och validering av kluster
Inertin minskar när k ökar, så den kan inte ensam välja k. Elbow‑heuristiken letar efter avtagande förbättring. Silhouett‑analys jämför sammanhållning och separation. Stabilitet över prov och frön ger en ytterligare kontroll.
Den starkaste valideringen är nytta för den avsedda domänen. Jämför kluster med kända resultat, expertgranskning eller en efterföljande uppgift utan att låtsas att efterhandsetiketter upptäcktes objektivt.
Begränsningar och alternativ
K-means föredrar kompakta, ungefär sfäriska grupper av liknande skala. Gaussian mixture‑modeller representerar sannolikhetsbaserade ellipsoidala komponenter; DBSCAN‑liknande metoder identifierar täta regioner och brus; hierarkisk klustring producerar ett träd av sammanslagningar.
Dimensionalitetsreduktion kan förbättra hastigheten eller avlägsna brus från indata, men att anpassa den på hela datasetet kan förändra valideringsfrågan. Mini‑batch K-means minskar beräkningarna för stora dataset på bekostnad av en approximativ uppdatering.
Mål, initiering och konvergens
K-means partitionerar numeriska observationer i k kluster genom att minimera det kvadrerade euklidiska avståndet inom klustret till centroids. Lloyds algoritm växlar mellan att tilldela varje punkt till dess närmaste centroid och att omräkna centroids tills tilldelningarna eller målet stabiliseras. Den konvergerar till ett lokalt optimum, men inte nödvändigtvis det globala bästa. K-means++‑initiering sprider initiala centra och förbättrar vanligtvis resultaten, men flera frön förblir viktiga. Standardisera funktioner när enheter bör bidra jämförbart eftersom kvadrerat avstånd förstärker variabler med hög skala och outliers.
Metoden antar ungefär kompakta, sfäriska, likasinnade skalade kluster under euklidisk geometri. Den har problem med utdragna manifolder, ojämn densitet, kategoriska data, kraftiga outliers och nästlade strukturer. Tomma kluster och dubblettpunkter kräver definierad hantering. Mini‑batch k-means skalar till stora datamängder med en approximationsavvägning. För gles text kan kosinus‑orienterad sfärisk k-means bättre matcha riktning, medan blandningar, densitetsmetoder, hierarkisk klustring eller k‑medoids kodar andra antaganden.
Val av k och validering av betydelse
Elbow‑kurvor, silhouettpoäng, informationskriterier i relaterade modeller och stabilitet kan ge vägledning för k, men ingen upptäcker ett unikt korrekt antal. Affärsnytta och domäninterpretation är viktiga. Återanpassa över prov och frön, jämför centroidrörelser och tilldelningskonsistens, och validera kluster mot oberoende resultat som inte använts för att bilda dem. En tvådimensionell projektion kan förvränga separationen, så undersök avstånd och exempel i det ursprungliga eller validerade representationsutrymmet.
Kluster är beskrivande grupper skapade av de valda funktionerna och metrik; de är inte naturliga typer eller kausala segment. Profiler baserade på samma variabler som används för klustring kan bli cirkulära. Använd håll‑ut‑attribut och kvalitativ granskning, och undersök om klustren främst återger geografi, datakälla eller känsliga egenskaper. Små kluster kan vara avvikelser eller artefakter. Att namnge ett kluster gör inte att varje medlem passar etiketten.
Implementering och underhåll
Spara skalning, funktionsordning, centroids, avståndsdefinition och klusteretiketter tillsammans. För nya punkter, övervaka avståndet till tilldelad centroid och andelen som ligger långt utanför träningsstöd; ge ett okänt tillstånd istället för att tvinga varje fall in i ett kluster. Följ klustertstorlekar, centroids och resultatens relevans över tid. Omskolning förändrar klusteridentiteter, så mappa eller versionera nedströmsregler snarare än att tyst återanvända gamla namn. K-means är en användbar komprimerings‑ och segmenteringsbaslinje när dess geometri matchar frågan, men inte en universell upptäcktsmotor.
Arbetsexempel: kundsegmentering med k-means
Ett prenumerationsföretag standardiserar användningsfunktioner över ett fast fönster, tar bort kontoidenterare och testar k över olika frön. Stabilitet, silhouett och håll‑ut‑affärsresultat granskas, men produktteam inspekterar även representativa och gränskonton. De upptäcker att ett kluster helt enkelt är nya kunder med kortare observationsperiod, så anställningstid hanteras explicit. K-means jämförs med hierarkiska och densitetsbaserade alternativ snarare än att antas vara lämpligt. Övningen behandlas som unsupervised learning, inte etikettupptäckt.
Segmenten styr forskning och meddelandeexperiment, inte behörighet eller pris. Nya konton som ligger långt från alla centroids får en okänd tilldelning. Skalning, funktioner, centroids och namn versioneras, och omskolning mappar nya kluster till gamla endast med bevis. Övervakning följer klustertstorlek, avstånd och resultatens relevans. Känsliga attribut och proxyer granskas, och teamet undviker att beskriva kluster som naturliga personlighetstyper när de är matematiska partitioner av utvalda beteenden.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera de avsedda användarna, driftsmiljön, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och ett versionerat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, ändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incidentlärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är K-means övervakat eller oövervakat?
Den är oövervakad eftersom den får funktioner och ett valt antal kluster, inte mål‑etiketter.
Klassificerar K-means ny data?
Efter anpassning kan en ny punkt tilldelas sin närmaste centroid. Det är en klustertilldelning, inte nödvändigtvis en övervakad klassificering.
Primära referenser