Python-bibliotek
10 bästa Python-biblioteken för bearbetning av naturligt språk

 Lägg till Unite.AI bland dina föredragna källor på Google
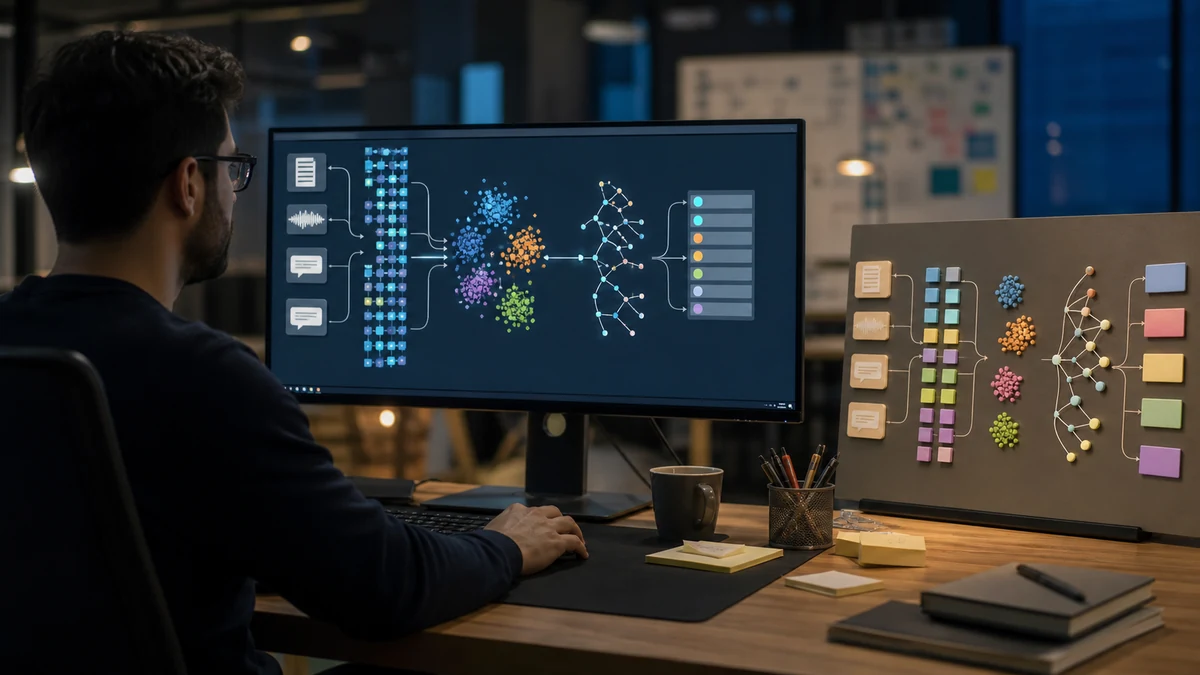
Det bästa Python-biblioteket för bearbetning av naturligt språk beror på vad du behöver göra. Att generera ett svar, hitta ett relevant dokument, extrahera ett organisationsnamn och klassificera ett supportärende är olika problem. En stor förtränad modell kan vara värdefull, men en mindre statistisk lösning kan vara snabbare, billigare och enklare att utvärdera för en tydligt avgränsad uppgift.
Vi utvärderade oberoende alla 10 bibliotek utifrån deras funktioner, dokumentation, praktiska begränsningar, passform i ekosystemet och lämplighet för arbetsflödena nedan. Transformers ligger i topp när det gäller tillgång till förtränade modeller, spaCy för språkliga produktionsflöden och Sentence Transformers för informationssökning. Rangordningen bygger på redaktionella bedömningar, inte på ett nytt jämförande test av hastighet eller träffsäkerhet.
Den här guiden omfattar både bibliotek för specifika uppgifter och stödjande infrastruktur: Tokenizers och Datasets hjälper till att bygga NLP-system, men ersätter inte en modell eller en komplett analyskedja. Kompatibilitet och underhåll kontrollerades mot officiell dokumentation och paketmetadata i oktober 2026.
Jämförelse av de bästa Python-biblioteken för NLP
| AI-verktyg | Bäst för | Funktioner |
|---|---|---|
| Transformers | Förtränade språkmodeller och textgenerering | PyTorch-modeller; inferens; finjustering; uppgiftsbaserade arbetsflöden |
| spaCy | Språkliga produktionsflöden | Tokenisering; entiteter; syntaktisk analys; regler; anpassade komponenter |
| Sentence Transformers | Inbäddningar, semantisk informationssökning och omrangordning | Täta och glesa kodare; korskodare; sökning med flera vektorer |
| scikit-learn | Effektiva baslinjer för textklassificering | TF-IDF; glesa egenskaper; klassificerare; arbetsflöden; utvärdering |
| Stanza | Flerspråkig språkanalys | Neural märkning; morfologi; beroendeanalys; entiteter |
| NLTK | Lära sig NLP och utforska textkorpusar | Tokenisering; stemming; textkorpusar; WordNet; klassiska algoritmer |
| Gensim | Ämnesmodeller och klassiska ordinbäddningar | LDA; LSI; Word2Vec; FastText; strömmade textkorpusar |
| Flair | Anpassad entitetsigenkänning och sekvensmärkning | Förtränade märkare; textklassificering; inbäddningar; anpassad träning |
| Tokenizers | Anpassad tokenisering av delord | Rust-baserad bearbetning; BPE; WordPiece; Unigram; justering |
| Datasets | Förberedelse av datauppsättningar och repeterbara NLP-experiment | Inläsning; Arrow-baserad lagring; transformationer; strömning; revisioner |
1. Transformers
Hugging Face Transformers är vårt förstahandsval när ett NLP-projekt bygger på en förtränad språkmodell. Biblioteket innehåller modellbeskrivningar, tokeniserare och processorer, verktyg för inferens och gränssnitt för träning av uppgifter som textgenerering, klassificering, frågebesvarande och extraktion. Bredden gör det till en användbar grund för team som vill jämföra olika modellarkitekturer i stället för att binda sig till en enda värdtjänst.
Riktlinjerna för kompatibilitet har ändrats: Transformers v5 fokuserar på PyTorch och avvecklar de tidigare TensorFlow- och Flax-bakändarna. Man bör inte utgå från att en äldre handledning som läser in en TensorFlow-modell fungerar oförändrad med en aktuell installation. Befintliga applikationer bör kontrollera modellklass, API för uppgifter och beroenden innan de uppgraderar; att paketet installeras utan problem är inget bevis på att ett äldre arbetsflöde fortfarande är kompatibelt.
Biblioteket gör inte alla kontrollpunkter lika träffsäkra, prisvärda eller lämpliga för kommersiell användning. Välj modell utifrån språk, uppgift, licens och tillgänglig hårdvarubudget och utvärdera sedan representativa indata. För en enkel klassificerare som dirigerar supportärenden kan en enklare statistisk baslinje vara lättare att driftsätta. Transformers förtjänar sin plats tack vare modellåtkomsten och flexibiliteten, men det slutliga driftsättningsbeslutet måste fortfarande fattas för varje enskild kontrollpunkt.
Fördelar och nackdelar
- Brett ekosystem av förtränade modeller
- Stöd för inferens och anpassning
- Gemensamma modellbeskrivningar för många verktyg
- Stora modeller kan kräva betydande beräkningsresurser
- Större versionsändringar kräver en genomgång av migreringen
Visa dokumentationen för Transformers
2. spaCy
spaCy är vårt förstahandsval som utgångspunkt för produktionspipelines som omvandlar text till strukturerad språklig information. Det kombinerar tokenisering, entitetsigenkänning, taggning, parsning och anpassade komponenter i en enhetlig dokumentrepresentation. Det är särskilt användbart när en applikation behöver tillförlitliga annoteringar och affärsregler i stället för ett fritt genererat svar som måste tolkas i efterhand.
Styrkan ligger i möjligheten att kombinera olika delar. Ett team kan kombinera en tränad entitetsigenkännare med uttryckliga matchningsregler, lägga till domänspecifik bearbetning och paketera resultatet som en återanvändbar pipeline. Exempelvis kan bearbetning av fakturor eller supportmeddelanden kräva både inlärda organisationsnamn och exakta produktidentifierare. När dessa operationer samlas i en pipeline blir det lättare att granska gränsdragningen mellan statistiska förutsägelser och deterministiska regler.
Språkpaketen varierar i storlek och täckning, och tränade pipelines måste vara kompatibla med den installerade versionen av spaCy. Det officiella valideringskommandot hjälper till att hitta inkompatibla paket efter uppgraderingar. Jämför prestandan hos de komponenter du faktiskt aktiverar, eftersom transformerbaserad bearbetning kan ha en annan resursprofil än en lättviktig pipeline. spaCy är mindre lämpat för öppet genererande uppgifter, men är fortfarande ett starkt val när kravet är strukturerad och repeterbar textbearbetning.
För- och nackdelar
- Kombinerar regler och inlärda komponenter
- Enhetliga API:er för dokument och pipelines
- Användbara verktyg för paketering och kompatibilitet
- Funktionerna varierar mellan språkpaketen
- Generativa arbetsflöden kräver ytterligare komponenter
3. Sentence Transformers
Sentence Transformers är det mest självklara valet för semantisk sökning, dokumentsimilaritet, dubblettidentifiering och informationssökningssystem. De uppgiftsinriktade gränssnitten gör det enklare att ta fram användbara representationer och relevanspoäng än att bygga motsvarande arbetsflöde med ett generellt modellbibliotek. Biblioteket är särskilt värdefullt när huvudutmaningen är att hitta rätt belägg innan en annan komponent genererar ett svar.
Det aktuella verktygspaketet omfattar mer än en vektor per mening. Dokumentationen beskriver täta inbäddningar, glesa kodare, omrankare baserade på korskodare och flervektormodeller, med stöd för multimodala data i vissa utvalda modellcheckpoints. Dessa metoder har olika kostnader: en sökkomponent kan begränsa en stor samling, medan en omrankare kräver mer beräkningskraft för att jämföra frågan med en mindre mängd kandidater. Den lämpliga kombinationen beror på kraven på relevans och svarstid.
Modellen och indexet måste stämma överens när det gäller representation, dimensioner, likhetspoängsättning och förbehandling. Om inbäddningsmodellen byts ut måste dokumentrepresentationerna vanligtvis byggas om; det räcker inte att bara byta modellnamn. Testa informationssökningen med realistiska frågor och svåra negativa exempel, däribland terminologi från din domän. Biblioteket är ett starkt modelleringslager, men lagring, åtkomstfilter, dokumentuppdateringar och drift av söktjänster kräver fortfarande en separat lösning.
För- och nackdelar
- Specialbyggda gränssnitt för informationssökning och likhetsberäkning
- Flera metoder för kodare och omrankare
- Stöd för träning och utvärdering
- Ändringar av representationen kan kräva omindexering
- Sökinfrastrukturen måste hanteras separat
Visa dokumentationen för Sentence Transformers
4. scikit-learn
scikit-learn förtjänar en plats på en lista över moderna NLP-bibliotek, eftersom många användbara textapplikationer inte kräver en stor språkmodell. Biblioteket erbjuder textvektorisering, klassiska klassificerare, klustringsmetoder och utvärderingsverktyg i ett moget gränssnitt för maskininlärning. För spamidentifiering, ärenderouting eller dokumentkategorisering är det ofta det tydligaste sättet att ta fram en användbar baslinje innan man lägger till neurala nätverkslösningar.
Ett typiskt arbetsflöde kombinerar ord- eller teckenbaserade egenskaper med en linjär klassificerare. TF-IDF-vikter kan minska inflytandet från vanliga termer, medan teckenbaserade n-gram kan hjälpa till att fånga stavningsvarianter eller textfragment. En pipeline håller ihop egenskapsutvinningen och skattaren. Anpassa hela pipelinen enbart på träningsdata inom varje utvärderingsdelning, så att beslut om ordförråd och viktning inte läcker information från de undanhållna exemplen.
Dessa representationer har begränsningar: de fångar inte kontextuell betydelse på samma sätt som en förtränad kodare, och okända ord kan försämra prestandan. Samtidigt är snabb CPU-inferens och enkel felgranskning värdefulla driftsfördelar. Vi tar med scikit-learn före flera specialistbibliotek eftersom läsarna bör ta reda på om en liten, mätbar klassificerare redan löser problemet innan de väljer en betydligt mer kostsam lösning för modellservering.
För- och nackdelar
- Starka baslinjearbetsflöden som fungerar bra på CPU
- Integrerat modellval och utvärdering
- Glesa textegenskaper kan vara enkla att granska
- Begränsad kontextuell språkförståelse
- Kräver representativa, etiketterade data för övervakade uppgifter
Visa dokumentationen för scikit-learn
5. Stanza
Stanza är ett utmärkt val när språklig struktur i flera språk är det främsta kravet. Stanfords Python-verktyg kan segmentera text, ta fram grundformer och morfologiska annoteringar, klassificera ord efter ordklass, analysera syntaktiska beroenden och identifiera entiteter. Verktygets värde märks särskilt tydligt i forsknings- och analysprojekt där man behöver jämförbara språkliga annoteringar, snarare än enbart meningsinbäddningar eller genererade sammanfattningar.
Den inbyggda pipeline-lösningen använder PyTorch och nedladdningsbara språkresurser. Tillgången till processorer varierar, så att ett språk finns med i katalogen betyder inte att alla annoteringsuppgifter stöds lika väl. För en flerspråkig textsamling bör du välja processorer och modeller för varje språk och utvärdera svåra fall, till exempel kodväxling, informell stavning eller text som ligger långt utanför modellernas träningsdomän.
Stanza tillhandahåller också ett Python-gränssnitt till Stanford CoreNLP, men den Java-baserade tjänsten är fristående från den inbyggda pipelinen och krävs inte för vanlig användning av Stanza. Den här skillnaden är viktig när du planerar beroenden och driftsättning. Vi rekommenderar Stanza när språktäckning är viktigare än en minimal körningsmiljö. Jämför svarstid och minnesanvändning med en lämplig spaCy-pipeline när båda verktygen kan tillhandahålla de annoteringar du behöver.
För- och nackdelar
- Starkt fokus på flerspråkig språkbehandling
- Omfattande grammatiska annoteringar
- Inbyggd Python-pipeline och separat CoreNLP-klient
- Uppgiftstäckningen varierar mellan olika språk
- Neurala pipelines kan öka resurskraven
Visa dokumentationen för Stanza
6. NLTK
Natural Language Toolkit är fortfarande ett av de bästa verktygen för att förstå vad en NLP-pipeline gör. Det samlar tokenisering, stemming, ordklassmärkning, parsning, lexikala resurser och tillgång till korpusar i ett format som lämpar sig för undervisning och experiment. Dess placering i rankningen speglar det pedagogiska djupet och den analytiska flexibiliteten, inte ett påstående om att det är standardmotorn för alla produktionslösningar.
För studenter och forskare är möjligheten att granska mellanliggande representationer värdefull. Du kan jämföra olika val för tokenisering, utforska lexikala samband eller undersöka hur en klassisk klassificerare reagerar på olika egenskaper utan att först behöva köra en stor modell. Sådana experiment hjälper också yrkesverksamma att förstå varför val av förbehandling kan påverka resultaten i senare led avsevärt, särskilt när det gäller negationer, namn och domänspecifikt ordförråd.
Många resurser måste laddas ner separat, så driftsättningen bör omfatta identifiering och paketering av de data som behövs, i stället för att förlita sig på en interaktiv nedladdning vid körning. Resursernas licenser och språkstöd behöver granskas separat. I ett program med hög volym bör du använda NLTK där en viss resurs eller algoritm tillför värde och sedan jämföra hela arbetsflödet med mer specialiserade bibliotek. Dess främsta styrka är att göra språkbehandlingskoncept begripliga och möjliga att granska.
För- och nackdelar
- Utmärkt undervisningsmaterial och tillgång till korpusar
- Brett utbud av klassiska NLP-funktioner
- Transparenta mellanliggande bearbetningssteg
- Resurserna måste hanteras separat
- Inte en komplett, färdig lösning för modern neural modellservering
7. Gensim
Gensim är ett specialiserat bibliotek för ämnesmodellering, klassiska ordrepresentationer och likhetsanalys av textsamlingar. Det är fortfarande användbart när ett projekt behöver tolkningsbara teman eller lokalt tränade inbäddningar i stället för en generativ modells funktioner. Den specialiserade inriktningen är en fördel för analytiker som vill ha en tydlig koppling mellan en korpus och den statistiska struktur som extraheras ur den.
Med strömmande arbetsflöden kan korpusar bearbetas utan att alla dokument måste finnas i minnet samtidigt. Modeller som LDA och LSI kan hjälpa till att utforska textsamlingar, medan Word2Vec och FastText används för att lära sig ordrepresentationer. Dessa metoder besvarar andra frågor än en modern meningskodare: en ämnesfördelning kan stödja analys av en textsamling, men bör inte automatiskt betraktas som den bästa representationen för att besvara sökfrågor på naturligt språk.
Förbehandlingen är en del av modellutformningen och omfattar bland annat filtrering av ordförrådet, hantering av fraser och avgränsning av dokument. Bedöm ämnenas stabilitet och användbarhet i stället för att enbart förlita dig på tilltalande ämnesetiketter. Kontrollera att biblioteket är kompatibelt med den installerade vetenskapliga Python-miljön innan du uppgraderar en befintlig miljö. Gensim förtjänar sin plats tack vare etablerade statistiska arbetsflöden. Den som bygger kontextuell informationshämtning bör jämföra det med Sentence Transformers i stället för att utgå från att de två är utbytbara.
För- och nackdelar
- Specialiserade verktyg för ämnesmodellering och inbäddningar
- Stöd för strömmande korpusarbetsflöden
- Användbar för tolkbar analys av textsamlingar
- Klassiska representationer har begränsningar när det gäller kontext
- Resultaten är starkt beroende av hur textkorpusen förbereds
8. Flair
Flair är ett praktiskt alternativ för team som arbetar med igenkänning av namngivna entiteter, sekvensmärkning och närliggande textklassificeringsuppgifter. Biblioteket erbjuder lättillgängliga gränssnitt till förtränade modeller och verktyg för att träna uppgiftsspecifika system. En fördel är att vägen från annoterade meningar till en modell som kan identifiera de textavsnitt eller etiketter som projektet faktiskt behöver är förhållandevis direkt.
Den inbäddningsorienterade utformningen gör det möjligt att experimentera med representationer och samtidigt behålla ett enhetligt tillvägagångssätt för prediktion och träning. I ett projekt för informationsutvinning inom ett visst ämnesområde kan detta hjälpa till att jämföra om bättre egenskaper eller bättre annoteringar ger störst förbättring. Utvärdera hela textavsnitt, inte bara enskilda token, eftersom ett system som identifierar en del av ett organisationsnamn ändå kan misslyckas med den efterföljande tillämpningen.
Flair har ett smalare ekosystem för driftsättning än de bredaste biblioteken för allmänna ändamål, så det är viktigt att kontrollera att beroendena är kompatibla. Kontrollera vilka versioner av Python och ramverk för djupinlärning som stöds i den aktuella utgåvan innan du kombinerar den med en nyare modellstack. Vi rekommenderar Flair när anpassad märkning är den centrala tekniska utmaningen och teamet har lämpliga träningsdata. För affärsprocesser med många regelstyrda moment eller breda generativa tillämpningar är andra alternativ en naturligare utgångspunkt.
Fördelar och nackdelar
- Lättillgängliga arbetsflöden för märkning med förtränade modeller
- Stöd för anpassade modeller för sekvensmärkning
- Användbart för experiment med representationer
- Kombinationer av beroenden behöver kontrolleras
- Kvaliteten beror på ämnesspecifika annoteringar och modellval
Visa dokumentationen för Flair
9. Tokenizers
Hugging Face Tokenizers är en infrastruktur för att omvandla text till de enheter som en modell använder. Biblioteket erbjuder snabba implementationer av tokenisering av delord samt tillhörande steg för normalisering, förtokenisering, efterbearbetning och avkodning. Det finns med på listan eftersom tokeniseringens kvalitet och genomströmning kan bli viktiga flaskhalsar när man tränar modeller eller bearbetar stora textsamlingar.
En tokenizer är mer än en vokabulärfil. Normalisering och regler för ordgränser påverkar hur text kopplas till tokenidentifierare, medan justeringsinformation kopplar token tillbaka till den ursprungliga indata. Det är viktigt för extraktionsuppgifter där de predicerade textavsnitten måste motsvara rätt tecken. När du tränar en anpassad vokabulär bör du undersöka representativa språk, interpunktion, ovanliga identifierare och ämnesspecifik terminologi, i stället för att bara optimera ett genomsnittligt komprimeringsmått.
Använd den tokenizer som förväntas av en befintlig förtränad modell, såvida du inte medvetet ändrar modellen och tränar om de berörda komponenterna. Godtyckliga byten av tokenizer kan göra tokenens betydelser ogiltiga och försämra resultatet. De flesta applikationsutvecklare kan använda tokenizern via Transformers utan att konfigurera det här lågnivåbiblioteket direkt. Välj Tokenizers när det specifika problemet du behöver kontrollera gäller vokabulärträning, justeringsbeteende eller förbehandlingens prestanda.
Fördelar och nackdelar
- Snabb tokenisering med stöd för Python
- Anpassningsbara bearbetningssteg
- Justeringsinformation möjliggör uppgifter som bygger på textavsnitt
- Utför inte semantisk analys på egen hand
- Ändringar av tokenizer kan bryta mot antaganden i förtränade modeller
Visa dokumentationen för Tokenizers
10. Datasets
Hugging Face Datasets tillhandahåller datalagret för NLP-experiment och träningsflöden. Det hjälper till att läsa in offentliga eller privata samlingar, tillämpa omvandlingar, hantera uppdelningar och arbeta med datamängder som är större än vad som smidigt ryms i ett Python-objekt i minnet. Det är varken en språkmodell eller en parser; biblioteket finns med eftersom NLP-resultatens tillförlitlighet i så hög grad beror på indatakedjans kvalitet och reproducerbarhet.
Arrow-baserade datamängder och strömning erbjuder olika sätt att hantera stora samlingar. En mappad datamängd är användbar för repeterbar förbehandling och indexerad åtkomst, medan strömning kan minska behovet av att ladda ned en hel textkorpus innan arbetet börjar. Välj åtkomstmönster med omsorg, eftersom strömning förändrar förutsättningarna för slumpmässig åtkomst, blandning och upprepade genomläsningar av data.
Lås fast versionerna av datamängderna och dokumentera omvandlingarna tillsammans med versionerna av modeller och tokenizers. Granska licenser, dubbletter, etikettkvalitet och överlappning mellan tränings- och testdata innan du tolkar ett utvärderingsresultat. Biblioteket gör datahanteringen smidigare, men garanterar inte att en datamängd från communityn passar din uppgift. Vi rekommenderar det som en stödkomponent när utmaningen är att säkerställa reproducerbar inläsning och förbehandling, särskilt tillsammans med Transformers eller Sentence Transformers.
Fördelar och nackdelar
- Enhetliga API:er för inläsning och omvandling
- Stöd för stora samlingar och strömning
- Användbar grund för reproducerbara experiment
- Datakvalitet och licensiering är fortfarande ditt ansvar
- Strömning kräver andra antaganden om åtkomstmönster
Visa dokumentationen för Datasets
Kompatibilitet och underhåll: vad du bör kontrollera
Transformers v5: Hugging Face har styrt biblioteket mot PyTorch och avslutat stödet för TensorFlow/Flax-backend. Granska migreringskraven innan du använder äldre exempel. Kompatibiliteten mellan biblioteken spelar också roll: den senaste versionen av varje beroende fungerar inte nödvändigtvis tillsammans med de andra.
Python-krav: Vid den här genomgången angav PyPI att Transformers 5.19.0 och Datasets 5.1.0 kräver Python 3.10 eller senare, medan scikit-learn 1.9.1 kräver Python 3.11 eller senare. Kontrollera aktuell paketmetadata för Transformers, Datasets och scikit-learn när du sätter upp en miljö. Det här är minimikraven för paketen, inte en garanti för att varje GPU-beroende eller tillägg fungerar med alla senare versioner av tolken.
Varför fastText inte längre är bland de tio främsta: Det officiella kodarkivet arkiverades i mars 2024. Befintliga modeller och etablerade driftsättningar kan fortfarande vara användbara, men att uppströmsprojektet har arkiverats är en viktig faktor för ny programvara. Vi rekommenderar scikit-learn som ersättning för den breda rollen som baslinje för textklassificering; det ersätter inte alla fastText-funktioner, särskilt inte de förtränade resurserna för språkidentifiering.
Välj ett arbetsflöde innan du väljer ett bibliotek
- Klassificera meddelanden: Skapa en baslinje med TF-IDF och en linjär klassificerare och jämför sedan med en förtränad kodare om felen motiverar den extra komplexiteten.
- Extrahera fält: Avgör vilka fält som kräver exakta regler och vilka som kräver inlärd entitetsigenkänning. Utvärdera hela textspann och de obligatoriska utdataformaten.
- Bygga semantisk sökning: Mät om informationssökaren hittar relevant underlag innan du bedömer generatorns svar. Lägg till omrankning endast när den förbättrade relevansen motiverar den ökade svarstiden.
- Analysera flerspråkig text: Kontrollera vilka språk, processorer och modeller som faktiskt stöds. Testa dialekter, informellt språk och indata med flera språk.
- Träna eller anpassa modeller: Håll reda på datamängdernas versioner, tokenizerkonfigurationen, modellernas kontrollpunkter och beroendeversionerna tillsammans.
Dela upp utvärderingsdata på ett sätt som återspeglar hur systemet ska användas. Dokument från samma kund, konversation eller duplicerade källa får inte läcka mellan tränings- och testmängderna. Mät uppgiftens kvalitet, svarstid och minnesanvändning tillsammans och granska felen utifrån språk och dokumenttyp. Håll isär bibliotekets licens från licenserna och begränsningarna som gäller för förtränade vikter och datamängder.
Om projektet behöver generera text kan vår guide till LLM:er med öppen källkod och öppna vikter hjälpa dig att välja modell. Jämförelsen av databaser för AI-tillämpningar tar upp lagringsalternativ som kan komplettera ett bibliotek för informationssökning.
Vilket Python-bibliotek för NLP ska du välja?
Börja med Transformers för förtränade språkmodeller, spaCy för strukturerade produktionsflöden eller Sentence Transformers för inbäddningar och relevansrankning. För en avgränsad klassificeringsuppgift bör scikit-learn vara med i den första jämförelsen, inte bara övervägas i efterhand.
Välj Stanza för flerspråkiga språkliga annoteringar, NLTK för inlärning och korpusutforskning, Gensim för ämnesmodeller och klassiska inbäddningar och Flair för anpassad sekvensmärkning. Deras styrka ligger i att de passar specifika uppgifter, så en lägre placering här betyder inte att de är sämre på sina specialområden.
Använd Tokenizers när du behöver kontroll över tokeniseringen och Datasets när dataförberedelsen är den största utmaningen. De flesta användbara NLP-system kombinerar några av de här verktygen. Börja med den minsta pipeline som uppfyller dina krav och öka komplexiteten när uppmätta fel visar varför det behövs.