Grunderna i AI
Vad är djupinlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Deep learning är en familj av maskininlärningsmetoder som använder neurala nätverk med flera bearbetningslager för att lära sig användbara representationer av data. Dessa modeller driver många moderna system för språk, bilder, ljud, rekommendationer, vetenskapliga prognoser och generativ AI.
Ordet deep avser antalet transformationer mellan indata och utdata, inte att en maskin har djupare förståelse. En djup modell lär sig numeriska relationer som är användbara för dess träningsmål, och dess prestanda måste fortfarande testas på ny data.
Viktiga slutsatser
- Deep learning är en delmängd av maskininlärning.
- Lager transformerar tensorer med hjälp av inlärda parametrar, icke‑linjära aktiveringsfunktioner, normalisering och andra operationer.
- Bakåtspridning beräknar gradienter; en optimerare använder dessa gradienter för att uppdatera träningsbara parametrar, inklusive vikter och bias.
- CNN‑nätverk, återkommande nätverk, transformatorer, autoenkodare och diffusionsmodeller har olika strukturer och styrkor.
Hur ett djupt neuralt nätverk lär sig
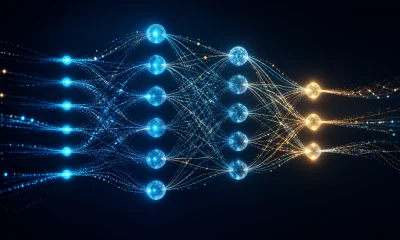
Ett neuralt nätverk tar emot data som tensorer, eller flerdimensionella talmatriser. En bildtensor kan koda pixelkanaler, medan en språkmodell använder vektorer som representerar token. Varje lager utför en differentierbar transformation och vidarebefordrar resultatet till nästa lager.
I ett grundläggande tätt lager beräknar modellen en viktad summa av sina indata, lägger till ett träningsbart bias och tillämpar sedan en aktiveringsfunktion:
output = activation(Wx + b)
Aktiveringsfunktionen introducerar icke‑linjäritet. Utan den skulle stapling av vanliga linjära lager fortfarande bara representera en linjär transformation. ReLU och dess varianter är vanliga i dolda lager, medan utgångsaktiveringar beror på uppgiften.
Träning följer vanligtvis fyra steg:
- Ett framåtriktat pass genererar förutsägelser.
- En förlustfunktion mäter hur förutsägelserna skiljer sig från målet.
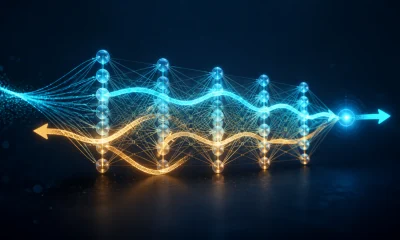
- Bakåtspridning tillämpar kedjeregeln för att beräkna gradienten av förlusten med avseende på varje träningsbar parameter.
- En optimerare såsom stokastisk gradientnedstigning eller AdamW uppdaterar parametrarna.
Att upprepa dessa steg över många batcher kan förbättra modellen, men lägre träningsförlust garanterar inte pålitligt beteende i verkligheten. Validering, regularisering, representativ data och övervakning förblir väsentliga.
Stora djupinlärningsarkitekturer
Flerlagers perceptroner
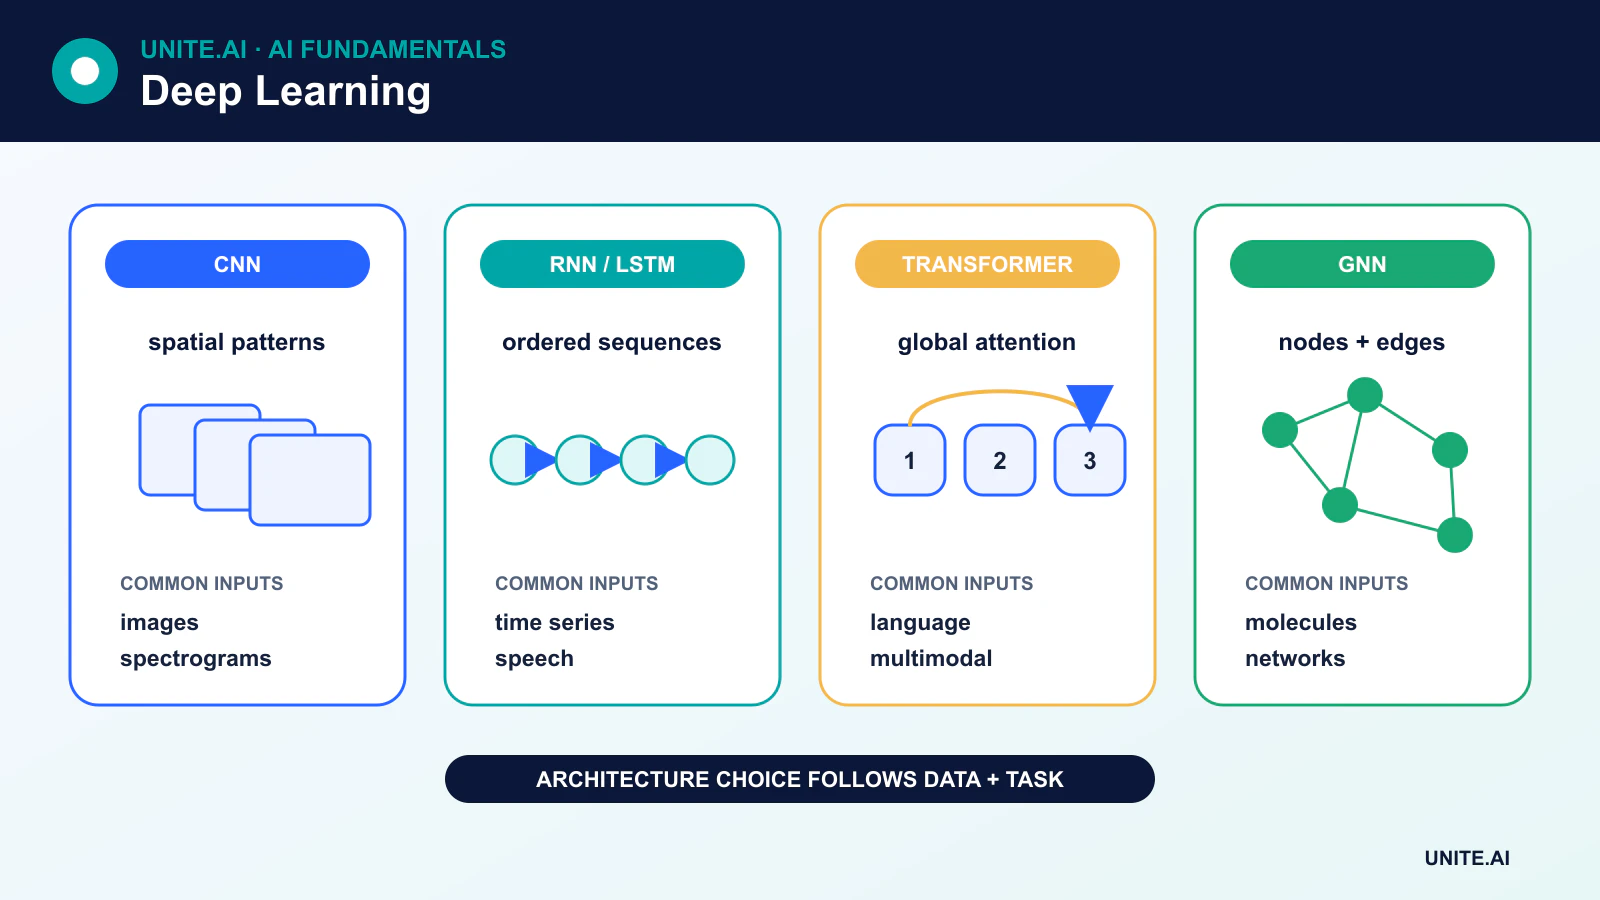
En flerlagers perceptron (MLP) använder fullt anslutna lager där varje utgångsenhet beror på alla indata från föregående lager. MLP:er är användbara för tabellbaserade funktioner och som komponenter i större system, men de bygger inte in antaganden om bildlokalitet eller sekvensordning.
Konvolutionella neurala nätverk
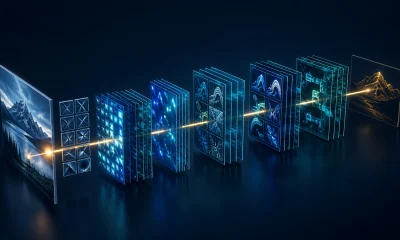
Konvolutionella neurala nätverk (CNN) tillämpar inlärda filter över lokala regioner. Viktdelning gör dem effektiva för rutnät som bilder och spektrogram. CNN:er förblir viktiga för bildigenkänning och edge‑distribution, även om vision‑transformers och hybridmodeller också används i stor utsträckning.
Återkommande nätverk, LSTM:er och GRU:er
Återkommande neurala nätverk (RNN) uppdaterar ett dolt tillstånd när en sekvens bearbetas. LSTM:er och gated recurrent units hjälper till att bevara information och minska problemet med försvinnande gradienter som gör grundläggande RNN:er svåra med långa beroenden. De eliminerar inte alla begränsningar för långa kontexter, men de är fortfarande användbara för strömmande signaler, tidsseriedata och kompakta sekventiella modeller.
Transformers
Transformers använder attention för att modellera relationer mellan element i en sekvens eller mängd. Deras förmåga att bearbeta många positioner parallellt hjälpte dem att ersätta återkommande strukturer i de flesta storskaliga språkssystem, och transformer‑varianter bearbetar nu bilder, ljud, video, proteiner och multimodala data.
Autoenkodare och generativa modeller
En autoenkodare komprimerar en indata till en representation och rekonstruerar indata från den. Detta skapar ett självövervakat rekonstruktionsmål; det omvandlar inte automatiskt oetiketterad data till märkta exempel.
Generativa adversariella nätverk tränar en generator och en diskriminator i konkurrens. Diffusionsmodeller lär sig att vända en gradvis brusningsprocess. Autoregressiva transformers genererar en token eller enhet åt gången. Dessa tillvägagångssätt har olika träningsdynamik, kontrollerbarhet och beräkningskrav.
Varför djup hjälper – och varför arkitektur spelar roll
Flera lager låter en modell kombinera enklare transformationer till mer komplexa. Inom bildigenkänning kan vissa inlärda funktioner gå från lokala texturer till uppgiftsspecifika mönster. Inom språk bygger attention‑lager kontextberoende tokenrepresentationer. Dessa beskrivningar är användbara intuitioner, inte fasta regler för vad varje lager måste lära sig.
Moderna nätverk förlitar sig också på residualanslutningar, normalisering, noggrann initiering, regularisering och optimerad hårdvara. Att bara lägga till lager eller parametrar kan göra en modell svårare att träna, långsammare eller mer benägen att överanpassa. Modellens skala hjälper bara när data, mål, optimering och driftsättningsmiljö stödjer det.
Träning kontra inferens
Träning justerar parametrar och är vanligtvis den beräkningsintensiva fasen. Inferens kör den tränade modellen för att producera ett resultat. Inferens kan fortfarande vara dyrt för stora modeller, vilket är anledningen till att team använder kvantisering, destillering, batchning, cachning, sparsitet och specialiserad hårdvara såsom neural processing units.
Begränsningar och ansvarsfull användning
Djupa modeller kan ärva bias, memorera känslig information, misslyckas vid fördelningsskift och producera övertygande men felaktiga resultat. De kan också vara svåra att tolka och dyra att träna. Utvärdering bör omfatta mer än ett genomsnittligt benchmark‑värde: team behöver prestanda på klass‑ eller subgruppsnivå, robusthet, kalibrering, säkerhet, latens, energianvändning och konsekvenserna av fel.
Representationer, optimering och arkitektursval
Djupa nätverk lär sig successiva representationer genom parametriserade lager. Linjära transformationer blandar indata; icke‑linjära aktiveringar gör det möjligt för nätverket att approximera komplexa funktioner; normalisering och residualanslutningar underlättar optimering; attention, konvolution, återkommande eller state‑space‑operationer kodar olika strukturella antaganden. Djup ökar antalet transformationer, men garanterar inte intelligens. Arkitekturen bör spegla modaliteten, datavolymen, latensen, minnet och invarianserna i uppgiften. En mindre konvolutionell modell kan överträffa en transformer när data är begränsad och lokal rumslig struktur dominerar.
Träning beräknar en förlust, differentierar den med bakåtspridning och uppdaterar parametrar med en optimerare såsom stokastisk gradientnedstigning eller Adam. Batch‑storlek, inlärningshastighet, schema, initiering, regularisering och numerisk precision samverkar. Kurvor för tränings‑ och valideringsförlust hjälper att särskilja under‑ och överanpassning, instabilitet och läckage, men de etablerar inte nytta i verkligheten. Använd oberoende utvärderingsdata, upprepade körningar där varians är viktig, ablationer och jämförelse med enklare baslinjer. Stora parameterantal ökar även behovet av datastyrning, beräkningsplanering och reproducerbar konfiguration.
Distribuera djupa modeller säkert och effektivt
Distribution kan använda en hostad endpoint, dedikerad accelerator, webbläsare, telefon eller inbäddad enhet. Export och kompilering kan förena operatorer, kvantisera vikter och aktiveringar eller ändra numeriskt beteende, så validera den distribuerade artefakten snarare än bara träningskontrollen. Mät kallstart, stabil latens, genomströmning, minne, ström och kvalitet vid realistiska batch‑ och sekvensstorlekar. Komprimeringsmetoder – beskärning, destillering, kvantisering och låg‑rankad anpassning – avväger storlek eller hastighet mot noggrannhet och ingenjörskomplexitet och måste utvärderas på känsliga klasser och kantfall.
Djupa modeller kan misslyckas självsäkert under fördelningsskift, adversariell indata, falsk korrelation och dåligt representerade grupper. Övervaka in‑ och utdatafördelningar, uppgiftsresultat, kalibrering, resursanvändning och beroendeversioner. Använd åtkomstkontroll, signerade artefakter, skyddad träningsdata, red‑teamning och hastighetsbegränsningar som passar hotmodellen. Förklaringar såsom saliencymappar eller attention‑vyer är diagnostiska bevis, inte bevis på kausalitet. Kombinera dem med beteendetester, kontrafaktiska analyser, mänsklig granskning, incidentrespons och explicita begränsningar för automatiserade beslut.
Arbetsexempel: träning av en bilddefektdetektor
En fabrik samlar produktbilder från olika kameror, skift, material och kända defekttyper, och delar sedan upp dem efter produktionsbatch så att nästan identiska objekt inte kan korsa partitionerna. En liten konvolutionell baslinje jämförs med ett förtränat djupt nätverk. Augmentering reproducerar validerad belysning och synvinkelvariation utan att radera defekter. Utvärderingen rapporterar återkallelse per defekt, falsk avvisningsgrad, kalibrering, inferenslatens och robusthet mot suddighet, bländning, kamerabyte och sällsynta materialfärger.
Den exporterade modellen och exakt kod för storleksändring, färg och normalisering testas på linjens hårdvara för hållbar genomströmning och termiskt beteende. Lågt förtroendefall skickas till inspektörer; en oberoende regel stoppar linjen vid säkerhetskritisk sensorfel. Bilder behålls endast enligt tillåtelse och modellartefakter signeras. Övervakning kopplar förutsägelser till senare inspektionsresultat och produktionslotter. En ny kamera eller material utlöser en kontrollerad omvärdering snarare än tyst online‑inlärning från ogranskade etiketter.
Bevis på implementering och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, ändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter distribution snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och behållningsrutiner samt en tydlig punkt då det ska inaktiveras eller ersättas.
Primära referenser