
Grunderna i AI
Vad är få‑exempel‑inlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Few-shot learning studerar hur en modell kan anpassa sig till en ny uppgift eller klass med endast ett litet antal märkta exempel. I klassiska benchmark‑tester tillhandahåller ett avsnitt en stöduppsättning — till exempel fem klasser med ett eller fem exempel per klass — och ber modellen att klassificera osedda frågor.
Termen används också för in‑kontext‑inlärning, där en förtränad språkmodell får några demonstrationer i sin prompt utan att uppdatera parametrar. Dessa inställningar delar målet att lära med få exempel men använder olika anpassningsmekanismer och kräver olika utvärderingsdesigner.
Viktiga slutsatser
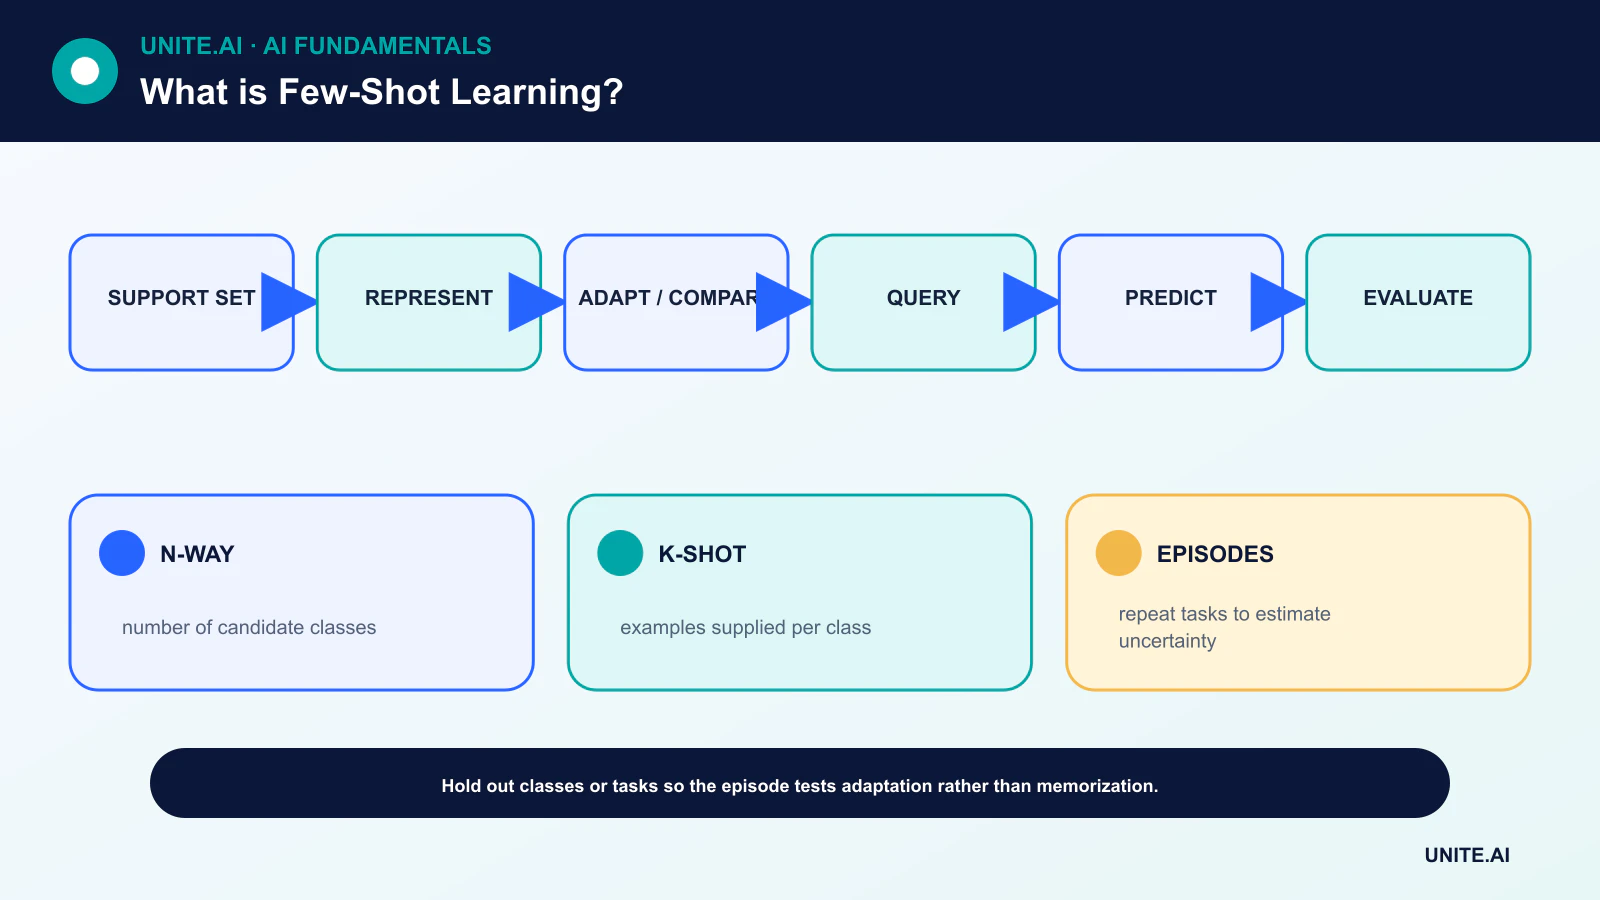
- N‑way K‑shot beskriver N klasser och K märkta stödexempel per klass.
- Metric‑learning‑metoder jämför frågor med inlärda representationer av stödexempel.
- Meta‑learning optimerar över många uppgifter så att en ny uppgift kan läras snabbt.
- Få exempel förstorar fel i etiketter, läckage, klassambiguitet och osäkerhet, så referensmetoder och rapportering av förtroende är viktiga.
Avsnitt, stöduppsättningar och frågesätt
Ett få‑exempel‑avsnitt separerar en liten märkt stöduppsättning från en frågesättning som används för utvärdering. Under meta‑träning ser modellen många sådana avsnitt. En robust utvärdering utesluter hela klasser, uppgifter eller domäner så att testavsnittet mäter anpassning snarare än memorering.
Rapportera fördelningar av noggrannhet över många avsnitt snarare än ett enda bekvämt urval. Jämför med enkla närmaste‑granne‑ och linjära referensmetoder; en sofistikerad metod som inte kan slå en vältränad representation plus en grundläggande klassificerare kanske inte motiverar sin komplexitet.
Metric‑inlärning och prototyper
Matching‑nätverk och relaterade metoder inbäddar stöd‑ och frågeexempel i ett rum där närliggande vektorer bör ha samma etikett. Prototypiska nätverk medelvärdesberäknar stöd‑inbäddningarna för varje klass och klassificerar en fråga utifrån avståndet till dessa klassprototyper.
Detta kopplar få‑exempel‑inlärning till representationskvalitet. En förtränad djupinlärning-modell kan redan organisera relevanta funktioner väl, medan en felaktig representation kan göra varje avstånd missvisande.
Optimeringsbaserad meta‑inlärning
Model‑Agnostic Meta‑Learning söker efter parametrar som kan anpassas med ett litet antal gradientsteg. Andra metoder lär sig en optimerare, en initiering eller en regel för parameteruppdatering. Den yttre loopen utvärderar prestanda efter anpassning över uppgifter.
Meta‑learning förutsätter att användbar struktur delas mellan tränings‑ och måluppgifter. När mål‑distributionen skiljer sig kraftigt kan snabb anpassning misslyckas. Validering bör variera antal exempel, klasser, domäner och uppgiftssvårighet istället för att behandla ett benchmark som universellt.
Transferinlärning och datanivåstrategier
Transferinlärning är ofta den starkaste praktiska utgångspunkten: frys en förtränad kodare, träna ett litet huvud, och finjustera selektivt om tillräckligt med data finns. Data‑augmentation kan introducera invarians, men orealistiska syntetiska exempel kan förstärka bias eller skapa genvägar.
Aktiv inlärning kan prioritera vilka exempel som ska märkas, medan semi‑supervised inlärning kan använda ytterligare omärkta data. Dessa är komplementära strategier, inte synonymer till få‑exempel‑inlärning.
Få‑exempel‑promptning är annorlunda
En transformer kan härleda ett mönster från demonstrationer placerade i dess kontext. Ingen bestående parameteruppdatering krävs. Ordning, formulering och etikettbalans kan väsentligt förändra resultatet, och exempel kan ta upp en stor del av kontextfönstret.
Använd en representativ utvärderingsuppsättning, versionera varje prompt och demonstration, och testa noll‑shot, få‑exempel‑ och finjusterade alternativ. En liten stöduppsättning stödjer inte starka påståenden för hela populationen, särskilt för sällsynta eller säkerhetskritiska fall.
Få‑exempel‑inlärningsparadigm och uppgiftskonstruktion
Få‑exempel‑inlärning syftar till att utföra en uppgift med mycket få märkta exempel. I metric‑baserade metoder mappar en kodare exempel till ett rum där närmaste prototyper eller grannar representerar klasser. Optimeringsbaserad meta‑inlärning tränar en initiering eller uppdateringsregel för snabb anpassning. Transferinlärning finjusterar en förtränad modell på en liten måluppsättning. In‑kontext‑inlärning tillhandahåller exempel i en prompt utan att uppdatera vikter. Dessa mekanismer skiljer sig, så påståenden bör specificera om parametrar förändras, vilken tidigare träning som skett och hur exempel väljs.
Utvärdering bör separera tränings‑ och testklasser, uppgifter, subjekt eller domäner enligt den påstådda generaliseringen. Ett N‑way K‑shot‑avsnitt innehåller N klasser och K stödexempel per klass, samt frågeexempel för poängsättning. Upprepade avsnitt uppskattar varians från stödval. För promptning kan exempelordning, etikettformulering, format och demonstrationslikhet väsentligt förändra resultat. Jämför med noll‑shot, närmaste‑granne, linjär‑probe och vanliga finjusteringsbaslinjer med samma representation och databudget.
Datakvalitet, osäkerhet och negativ transfer
Med få exempel har felmärkta eller atypiska fall en oproportionerligt stor påverkan. Definiera annoteringsregler, granska varje stödobjekt och bevara ett okänt eller avstå‑resultat. Data‑augmentation och syntetiska exempel kan bara hjälpa när de bevarar uppgiften och tillför realistisk variation. En förtränad modell kan överföra genvägar eller bias från sin käll‑domän. Testa fall utanför domänen, sällsynta grupper och känsligheten för att ta bort ett stödexempel. Rapportera konfidensintervall över uppgifter och slumpmässiga frön, inte en enda fördelaktig prompt.
Aktiv inlärning kan begära etiketter för informativa fall, medan semi‑supervised metoder använder omärkta data under ytterligare antaganden. Hämtning kan dynamiskt välja relevanta demonstrationer men måste undvika läckage av test‑etiketter. Anpassning kan överanpassa snabbt, så begränsa uppdateringar, använd regularisering och validera på separata exempel. För uppgifter med hög insats är några etiketter sällan tillräckliga för autonoma beslut; använd modellen för att prioritera eller assistera granskning tills tillräcklig bevisning för resultat finns.
Produktionsdrift
Versionera basmodellen, inbäddning eller prompt‑mall, demonstrationer, etikettschema och anpassningsparametrar. Skydda exempel eftersom prompts eller gradienter kan avslöja känsliga poster. Övervaka prestanda när klasser och språk förändras, och uppdatera stödexempel genom styrd granskning snarare än automatisk självmärkning. Få‑exempel‑inlärning minskar kravet på märkta mål genom att utnyttja tidigare struktur; den eliminerar inte behovet av representativ utvärdering, noggrann uppgiftsdefinition, domänexpertis eller en säker reserv när den nya uppgiften ligger utanför den tidigare kunskapen.
Arbetsexempel: få‑exempel‑klassificering för en ny produkt
Ett supportteam behöver routningsetiketter för en produkt med endast fem granskade exempel per ärende. Det jämför närmaste prototyper i en förtränad inbäddning, ett linjärt huvud, parameter‑effektiv finjustering och in‑kontext‑promptning. Produktfamiljer, kunder och senare meddelanden hålls utanför meta‑träning och modellval. Upprepad sampling av stödset rapporterar klass‑återkallelse, kalibrering, varians och känslighet för en felmärkt demonstration.
Meddelanden med låg förtroendegrad och utan stöd dirigeras till generell support, och granskare korrigerar etiketter via en styrd kö. Exempel avidentifieras, versioneras och väljs aldrig från det slutgiltiga testsetet. Övervakning spårar nytt vokabular, klass‑frekvenser, korrigeringar och meningsskiljaktigheter. När tillräckligt många etiketter samlats jämförs få‑exempel‑systemet med vanlig övervakad träning. Snabb uppsättning är användbar, men den rättfärdigar inte automatisering om prestanda förblir instabil eller om den nya produkten avviker väsentligt från tidigare uppgiftsfamiljer.
Bevis för implementering och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar referens och ett versionerat utvärderingsset innan justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och bevarandeprocesser samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är one‑shot‑inlärning samma som få‑exempel‑inlärning?
One‑shot‑inlärning är det speciella fallet med ett märkt stödexempel per klass eller uppgift. Zero‑shot‑inlärning använder inga märkta mål‑exempel.
Eliminerar få‑exempel‑inlärning behovet av data?
Nej. Det förflyttar beroendet mot förträningsdata, relaterade uppgifter, representationer och antaganden. Målet har få etiketter; den totala inlärningshistoriken är vanligtvis stor.
Primära referenser












