Grunderna i AI
Vad är stora språkmodeller (LLM:er)?

 Lägg till Unite.AI bland dina föredragna källor på Google
En stor språkmodell (LLM) är ett neuralt nätverk som tränas på stora samlingar av sekvenser för att förutsäga token eller relaterade språkuppgifter. De flesta nuvarande LLM:er använder transformerarkitekturer och kan generera, klassificera, sammanfatta, översätta, hämta och transformera språk via ett gemensamt gränssnitt.
En LLM är inte en databas eller en garanterad resonemangsmotor. Dess output är en villkorlig förutsägelse som formas av träningsdata, efterträning, kontext, verktyg och avkodning. Flyt kan samexistera med faktiska fel, osäkerhet, bias eller osäkert beteende.
Viktiga slutsatser
- Tokenisering omvandlar text till diskreta enheter; inbäddningar och uppmärksamhet bygger kontextuella representationer.
- Förträning lär sig breda mönster, medan finjustering och preferensmetoder formar uppgiftsbeteende.
- Hämtning och verktyg kan lägga till aktuell bevisning eller handlingar, men kräver separata behörigheter och validering.
- Utvärdera det implementerade systemet för kvalitet, förankring, säkerhet, svarstid, kostnad och drift.
Token, transformatorer och förträning
Text delas upp i token. En transformator mappar dem till vektorer, blandar information genom uppmärksamhets- och framåtriktade lager, och producerar en sannolikhetsfördelning över nästa eller saknade token.
Självövervakade mål skapar träningssignaler från råa sekvenser. Skala i parametrar, data och beräkningskraft kan förbättra förlusten förutsägbart över intervall, men datasetkvalitet, arkitektur, optimering och utvärdering avgör vilka förmågor som faktiskt framträder.
Efterträning och inferens
Instruktionsjustering använder demonstrationer; preferensoptimering kan få output att bättre matcha mänskliga bedömningar eller en policy. Vid inferens definierar en prompt och konversationshistorik kontext, medan temperatur- och samplingsinställningar påverkar variation.
RLHF och liknande metoder formar beteende snarare än att installera en komplett faktakontroll. Modellen kan fortfarande generera ett trovärdigt men ounderbyggt svar.
Hämtning, verktyg och agenter
Hämtning‑förstärkt generering levererar passager som valts från en extern samling. Verktygsanrop låter applikationskod fråga databaser, beräkna, söka eller agera. Dessa mönster separerar viss kunskap och exekvering från modellens vikter.
Applikationen måste validera verktygsargument, upprätthålla behörigheter, bevara citeringar och behandla hämtat innehåll som opålitlig indata. Vektorsimilaritetssökning underlättar hämtning men bevisar inte att ett utdrag stödjer svaret.
Begränsningar och utvärdering
LLM:er kan hallucinationer, avslöja memoriserat innehåll, följa skadliga instruktioner, reproducera bias och misslyckas med uppgifter som verkar likna träningsexempel. Lång kontext garanterar inte att varje faktum används eller avvägs korrekt.
Utvärdera på representativa privata uppgifter med dokumenterade prompts och versioner. Mät stöd från källor, avslag, kalibrering, säkerhet, subgruppsresultat, mänsklig arbetsbelastning, svarstid och kostnad. Övervaka efter lansering eftersom modeller, data och användarbeteende förändras.
Träningsdata och modellutveckling
Förträningskorpusar kombinerar webbplatser, böcker, kod, akademiskt material, konversationer samt licensierade eller kuraterade källor. Pipelines upptäcker språk, tar bort dubbletter, filtrerar kvalitet och osäkert innehåll, hanterar personuppgifter och väljer blandningsvikter. Dessa val formar kunskap, språkomfattning, stil, bias och memorering.
Optimeringsprocesser batchar tokensekvenser och minimerar förutsägelseförlust med gradientnedstigning. Distribuerad träning delar upp data, modelltensorer, pipeline‑steg eller experter över acceleratorer. Kontrollpunkter, numerisk stabilitet, nätverkskommunikation och felåterhämtning blir stora ingenjörsutmaningar i stor skala.
Utvärdering under träning spårar förlust och förmågesviter, men benchmark‑kontamination kan blåsa upp resultaten. Avsätt tidsperioder och proprietära uppgifter, sök efter överlapp och rapportera exakta prompts, avkodning, verktyg och poängsättning. En modell kan förbättra genomsnittlig förlust medan regressioner uppstår i säkerhet eller för ett språk med låg resurs.
Kontextfönster, avkodning och inferens
Vid inferens lagrar nyckel‑värde‑cachen uppmärksamhetsprojektioner för tidigare token så att de inte behöver beräknas om vid varje steg. Cache‑minnet växer med lager, sekvens, batch och representation. Kvantisering och paging minskar belastningen men kan förändra kvalitet eller svarstid.
Girig avkodning väljer token med högst sannolikhet; temperatur omskalar sannolikheter; top‑k och top‑p begränsar kandidatmängden; beam‑search spårar flera sekvenser. Den bästa strategin beror på om uppgiften värdesätter determinism, mångfald, strukturerad output eller sekvenssannolikhet. Validera alltid schema efter generering.
Lång kontext ökar mängden tillgänglig information, men garanterar inte återkallelse eller resonemang. Position, distraktorer, motsägelser och promptstruktur påverkar användning. Hämtning kan välja en mindre evidensuppsättning, medan sammanfattning komprimerar historiken med risk för detaljförlust. Mät prestanda över kontextlängd och placering.
Anpassning, distribution och ekonomi
Full finjustering uppdaterar alla parametrar; parameter‑effektiva metoder uppdaterar adaptrar eller låg‑rankade matriser; fortsatt förträning anpassar domänfördelning; instruktion‑ och preferensjustering formar svar. Hämtning är ofta bättre för ofta förändrade fakta, medan justering är bättre för beteende och uppgiftsformat. Metoderna kan kombineras.
Distributionsalternativ inkluderar hostade API:er, hanterade slutpunkter, självhostade öppna vikter, modeller på enheten och hybrider. Jämför databehandling, versionskontroll, svarstid, genomströmning, regioner, tillgänglighet, modellportabilitet, support och total kostnad. Självhosting överför ansvar för säkerhet, skalning, uppdateringar och missbruksmätning.
Kostnad per token är ofullständig. En svag modell kan kräva omförsök, längre prompts, mer granskning eller dyra fel. Mät kostnad per framgångsrikt slutförd uppgift på en erforderlig kvalitet och risknivå. Använd caching, batchning, mindre dirigerade modeller och deterministisk kod där de förbättrar hela arbetsflödet.
Arbetsexempel: förankra en LLM i företagsdokument
En dokumentassistent bör börja med ett behörighetsmedvetet korpus, stabila dokumentidentifierare, version- och ikraftträdandedatum, parsbar struktur och en utvärderingsuppsättning av besvarbara, obesvarbara, tvetydiga och motstridiga frågor. Hämtning indexerar segment och metadata, men segmentstorlek och överlappning måste matcha dokumentstrukturen. Sökkvalitet mäts oberoende före generering så att en flytande modell inte kan dölja saknad evidens.
Vid körning autentiseras användaren, hämtning filtreras efter åtkomst, evidens hämtas och omrankas, en begränsad prompt konstrueras, ett citerat svar genereras och obligatorisk output valideras. Modellen bör ange när källor är i konflikt eller inte stödjer ett svar. Verktygsanvändning och externa åtgärder kräver separat auktorisation. Skydda mot instruktioner inbäddade i hämtade dokument genom att behandla innehållet som data snarare än som högre prioriterad systempolicy.
Utvärdera återkallelse av hämtning, citeringsprecision, svarskorrekthet, förankring, avslag, svarstid och kostnad över roller och dokumenttyper. Spåra modell-, prompt-, index-, parser- och korpusversioner för varje test. I produktion loggas evidens‑ID:n och feedback utan att exponera privat text, övervaka nya obesvarbara frågor efter innehållsändringar och upprätthåll en säker reserv. Ett LLM‑gränssnitt ersätter inte arkivhantering, åtkomstkontroll eller ansvarig ämnesgranskning.
Kapacitetsplanering bör modellera fördelning av prompt‑ och output‑längder, samtidiga användare, cache‑beteende, verktygs‑latens och omförsöks‑frekvens. Streaming förbättrar upplevd svarstid men komplicerar moderering och avbrytning eftersom osäkert eller felaktigt innehåll kan nå användaren innan hela svaret kontrolleras. Sätt token‑ och verktygsbudgetar, isolera hyresgäster, skydda leverantörs‑uppgifter och öva failover mellan modellversioner utan att tyst förändra det beteende som användarna förlitar sig på.
Praktisk implementeringschecklista
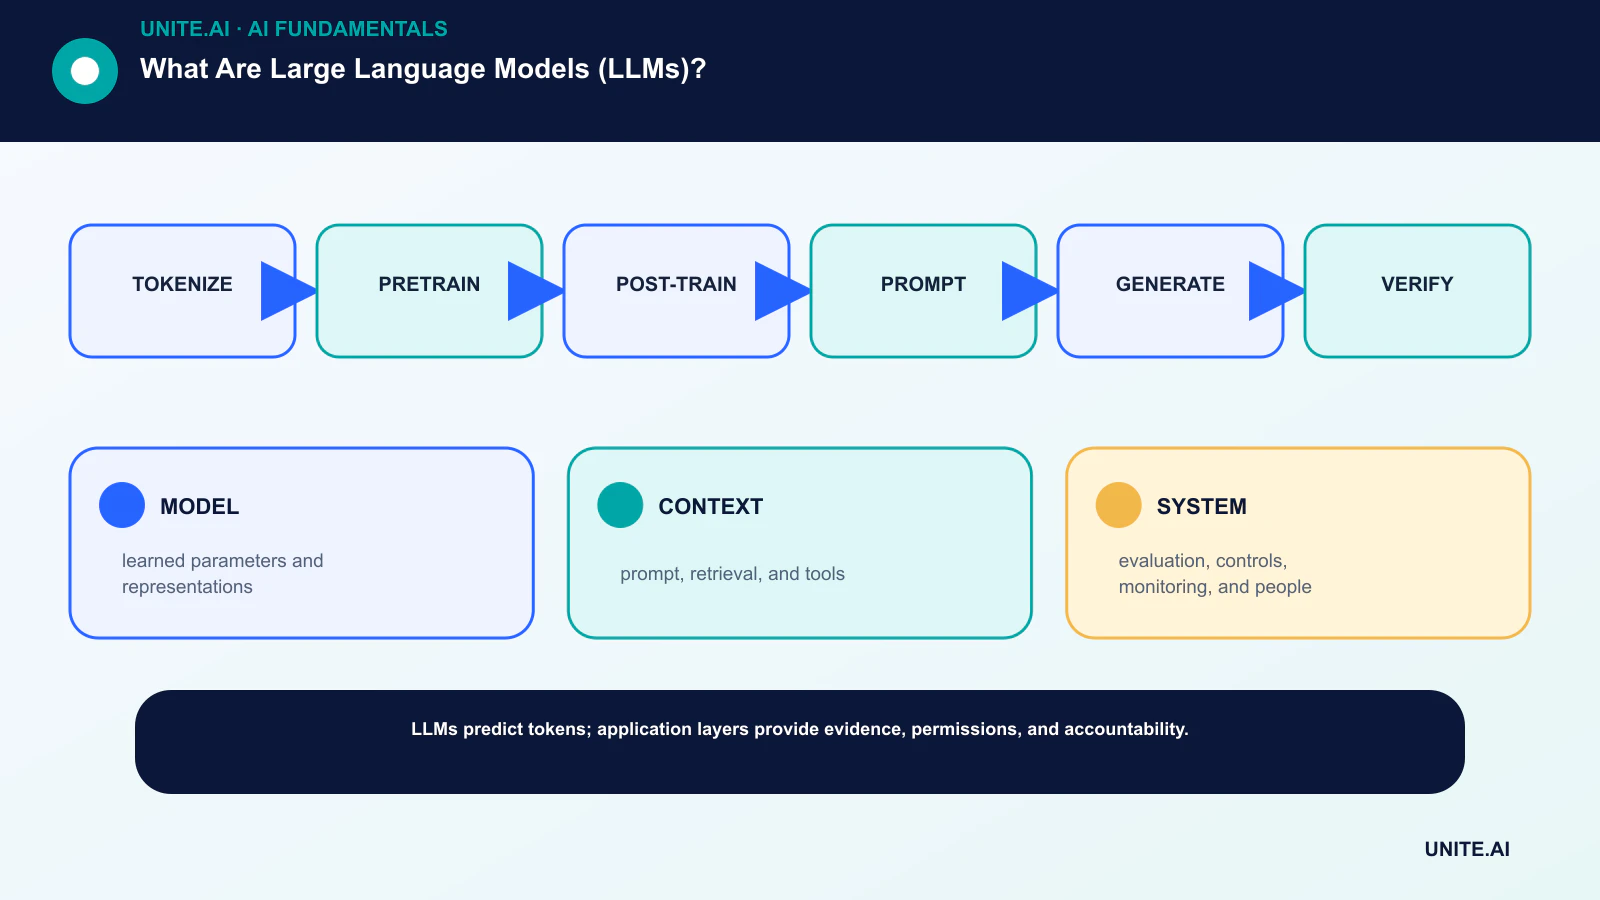
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: tokenisera → förträna → efterträna → prompta → generera → verifiera. Namnge en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering kör en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara evidensen och olösta risker. Definiera vem som kan godkänna release, ändra en tröskel, åsidosätta ett output eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- MODEL: inlärda parametrar och representationer.
- CONTEXT: prompt, hämtning och verktyg.
- SYSTEM: utvärdering, kontroller, övervakning och personer.
Vanliga frågor
Varför kallas LLM:er stora?
Det finns ingen universell parametertröskel. ‘Stora’ avser skala i förhållande till tidigare språkmodeller, inklusive parametrar, träningsdata, beräkningskraft och bredden av användning.
Förstår LLM:er språk?
De bygger användbara interna representationer och visar komplext beteende, men ordet ‘förstå’ har flera betydelser. Prestanda bör demonstreras uppgift för uppgift snarare än att härledas från flyt.
Primära referenser