
Grunderna i AI
Vad är meta‑inlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Meta‑inlärning tränar ett system över en fördelning av uppgifter så att det kan anpassa sig till en ny, relaterad uppgift med begränsade data eller beräkning. Det sammanfattas ofta som ”att lära sig att lära”, men det tekniska målet är mer precist: optimera inläraren så att erfarenhet från tidigare uppgifter förbättrar anpassningen till en senare.
Meta‑inlärning överlappar med few-shot learning och transfer learning, men termerna är inte utbytbara. Few-shot beskriver mängden mål‑data; transfer beskriver återanvändning; meta‑inlärning gör explicit att anpassning över uppgifter är en del av träningen.
Viktiga slutsatser
- Meta‑träning använder många uppgifter, inte bara många oberoende exempel.
- Ett N‑way K‑shot‑avsnitt innehåller N klasser och K märkta stödexempel per klass.
- Gradient‑baserade, metriks‑baserade, minnes‑baserade och inlärda optimeringsmetoder anpassar sig på olika sätt.
- Prestanda beror starkt på om meta‑träningsuppgifterna liknar måluppgiften.
Uppgifter, stödset och frågeset
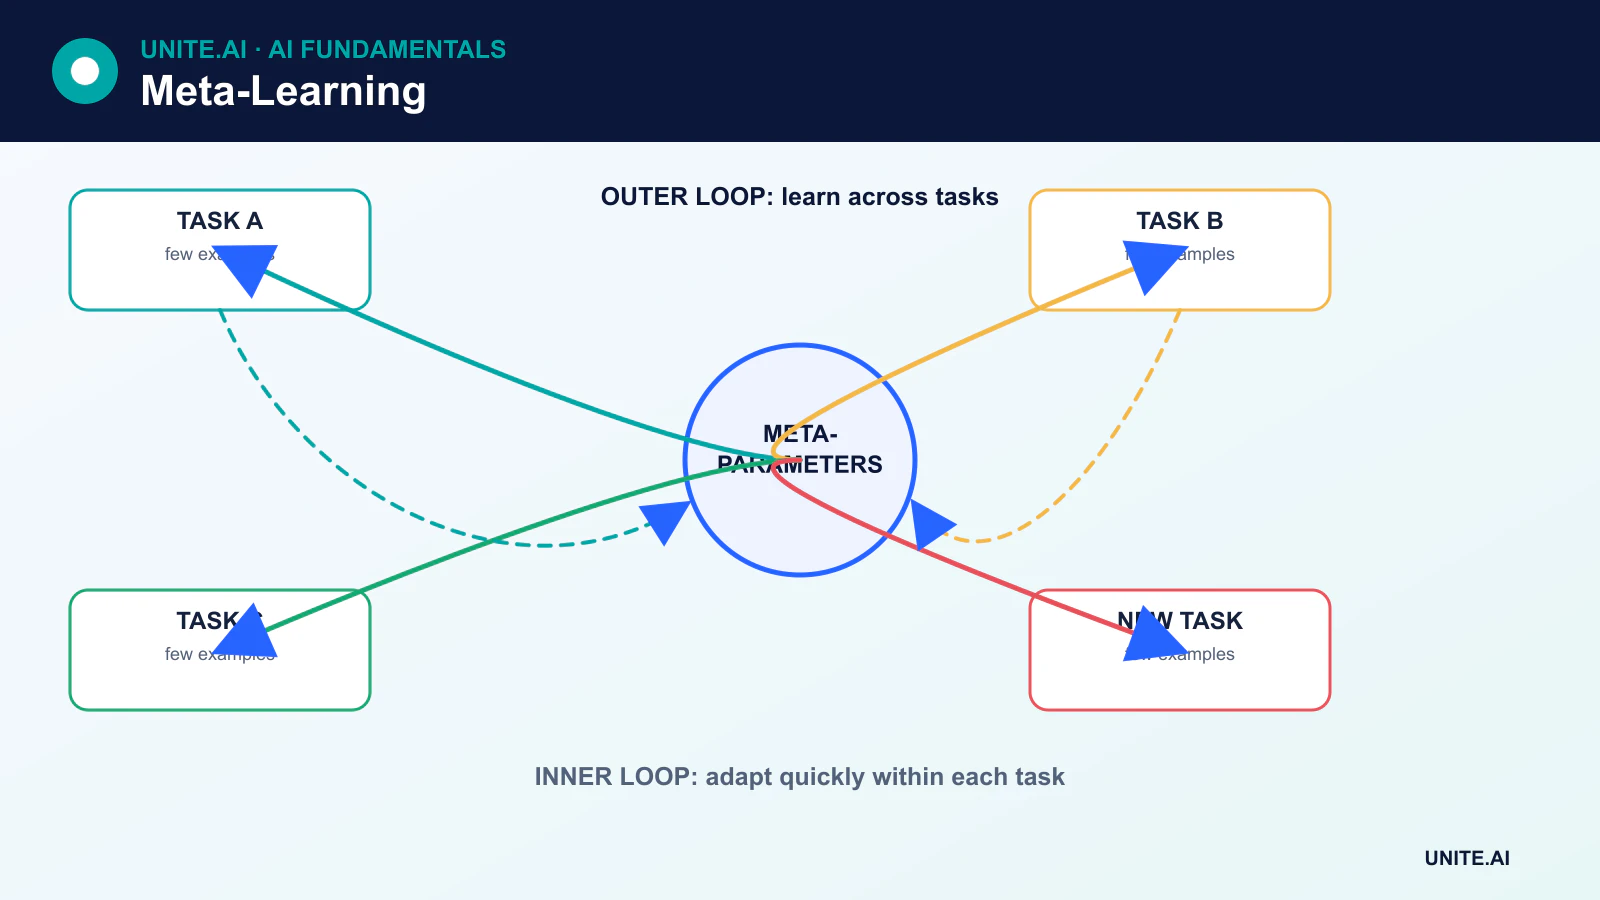
Ett meta‑inlärningsdatamaterial organiseras som uppgifter. Vid few‑shot‑klassificering kan ett avsnitt vara 5‑way 1‑shot: fem klasser, ett märkt stödexempel per klass, och ytterligare frågeexempel som används för att utvärdera anpassning. En 5‑way 5‑shot‑uppgift har fem stödexempel för var och en av fem klasser – inte fem exempel totalt.
Under meta‑träning anpassar sig inläraren upprepade gånger på ett stödset och utvärderas på ett frågeset. Det yttre målet förbättrar framtida frågeprestanda över uppgifter. Meta‑validering finjusterar val på separata uppgifter, och meta‑testning utvärderar verkligt osedda uppgifter eller klasser.
Gradient‑baserad meta‑inlärning
Model‑Agnostic Meta‑Learning (MAML) lär sig en initiering från vilken ett litet antal gradient-steg ger god prestanda på en ny uppgift. Den inre loopen anpassar modellparametrar med stöddata. Den yttre loopen uppdaterar den delade initieringen med hjälp av frågeförlusten över urvalda uppgifter.
MAML är inte begränsat till klassificering; det kan tillämpas på regression och reinforcement learning när modellen och uppgiften är differentiabla. Reptile erbjuder ett enklare förstagradstillvägagångssätt som förflyttar parametrar mot uppgifts‑anpassade lösningar utan att beräkna hela MAML‑meta‑gradienten.
Metriks‑baserad meta‑inlärning
Metriks‑baserade metoder lär sig en inbäddning där exempel från samma klass är nära varandra och olika klasser är separerade. Ett prototypiskt nätverk medelvärdesberäknar stöd‑inbäddningar för att bilda en prototyp per klass och klassificerar sedan frågor efter avståndet till dessa prototyper.
Matching‑ och Siamese‑liknande nätverk använder relaterade likhetsmekanismer. Dessa metoder kontrollerar inte bara om en modell “träffar ett mål‑metrik”; det inlärda avståndet eller representationen är själva en del av förutsägelseproceduren.
Minnes‑baserade metoder och inlärda optimerare
Minnes‑baserade system använder återkommande eller uppmärksamhets‑baserat tillstånd för att lagra information om den aktuella uppgiften. Inlärda optimerare tar gradienter eller träningssignaler som indata och lär sig hur de ska uppdatera en annan modell. Dessa metoder kan upptäcka anpassningsregler, men de tillför parametrar, beräkningskostnad och en ytterligare nivå av potentiell överanpassning.
Meta‑inlärning och in‑kontext‑inlärning
Stora transformers kan anpassa sitt output från exempel som ges i en prompt utan att uppdatera vikter. Detta kallas in‑kontext‑inlärning. Det liknar meta‑inlärningsbeteende, och träningsdata kan uppmuntra uppgiftsinferens, men en in‑kontext‑inlärare tränas inte automatiskt med ett klassiskt episodiskt meta‑inlärningsmål.
När meta‑inlärning är användbar
Potentiella tillämpningar inkluderar personalisering, robotik, igenkänning med begränsade resurser, vetenskapliga uppgifter med få mätningar och snabb anpassning till nya miljöer. Meta‑inlärning är mest attraktiv när många relaterade källuppgifter finns men data för måluppgiften är knapp.
Begränsningar
Meta‑inlärning kan vara beräkningsmässigt dyrt eftersom träning kapslar in anpassning i optimeringen. Resultaten är känsliga för uppgiftskonstruktion, stöd‑/frågeleakage, arkitektur och domänskifte. En modell som tränats på smala, homogena uppgifter kan anpassa sig dåligt utanför den fördelningen.
Jämförelser bör inkludera vanlig transfer‑learning och multitask‑baselines. En stark förtränad representation följt av standard‑finetuning kan vara enklare och mer effektiv än en dedikerad meta‑inlärningsalgoritm.
Uppgifter, anpassning och den inre–yttre optimeringsstrukturen
Meta‑inlärning tränas över en fördelning av uppgifter så att en inlärare kan anpassa sig till en ny uppgift med begränsade data eller uppdateringar. Varje avsnitt samplar en uppgift, delar exempel i ett stödset som används för anpassning och ett frågeset som används för utvärdering, och uppdaterar delad kunskap över avsnitten. Metriks‑baserade metoder lär sig en inbäddning och jämförelseregel; optimerings‑baserade metoder lär sig initiering eller uppdateringsbeteende; minnes‑ och modell‑baserade metoder förutsätter uppgiftsexempel. Uppgiftsfördelningen är den verkliga träningsdatan och måste likna framtida anpassningsproblem.
I modell‑agnostisk meta‑inlärning anpassar en inre loop parametrar på stödexempel och en yttre loop optimerar prestanda på frågeexempel efter anpassning. Högre ordningens gradienter kan vara dyra; förstagradss approximationer byter noggrannhet mot kostnad. Prototypiska nätverk representerar varje klass med ett centroid för stödsetet och klassificerar efter avstånd. Dessa metoder förutsätter att klassgeometri, anpassningssteg och avsnittskonstruktion speglar driftsättning. En metod kan verka lära snabbt samtidigt som den utnyttjar fasta etiketter, insamlingsartefakter eller överlappning bland källdatamängder.
Utvärdering, baselines och verkliga begränsningar
Separata tränings-, validerings- och testuppgifter – inte bara exempel – behövs för att mäta anpassning till verkligt osedda uppgifter. Rapportera noggrannhet eller förlust som funktion av antal shots och anpassningssteg, konfidensintervall över uppgifter, beräkning, minne och känslighet för stödset‑sammansättning. Jämför med transfer‑learning, finjustering av en förtränad modell, närmaste grannar och en modell som tränas gemensamt på all källdata. Många uppenbara meta‑inlärningsvinster minskar när baselines får motsvarande backbone, augmentation och finjustering.
Verkliga implementationer behöver ett sätt att känna igen när en ny uppgift ligger utanför meta‑träningsfördelningen. Dåliga eller felmärkta stödexempel kan orsaka snabba, självsäkra fel. Begränsa uppdateringsstorlek, validera anpassade modeller, bevara en reservlösning och skydda anpassningsdata mot förgiftning. Spåra basmodell, uppgiftssamplare, avsnittssådd och anpassningskod. Meta‑inlärning är användbar för återkommande familjer av små‑dataproblem, men den skapar inte generell inlärningsförmåga från godtyckliga exempel och eliminerar inte behovet av domänspecifik utvärdering.
Arbetsexempel: few‑shot‑anpassning över maskiner
En tillverkare behandlar varje maskintyp som en uppgift och meta‑tränar en avvikelse‑representation över många maskiner med verifierade underhållsresultat. Testmaskiner utesluts helt från uppgiftsträning. För en ny maskin täcker ett litet stödset normala driftlägen snarare än godtyckliga minuter av data. Meta‑inlärning jämförs med en förtränad fryst kodare, närmaste grannar och vanlig finetuning med samma stödexempel och beräkningsresurser.
Utvärderingen upprepar många stödval och rapporterar händelse‑återkallelse, falska larm, anpassningstid och varians. Systemet avstår när den nya maskinens sensorsats eller dynamik ligger utanför uppgiftsfördelningen. Anpassningsuppdateringar är begränsade och granskas innan de påverkar underhållet. Stödetiketter och maskinidentitet skyddas mot förgiftning, och varje anpassad modell behåller sin basversion och exempel. Snabb anpassning accepteras endast om den konsekvent slår enklare transfer under realistisk uppgiftsskift.
Bevis på implementering och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionsstyrd utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reservlösning och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för respons, och granska verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och bevarande‑procedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är few-shot‑promptning meta‑inlärning?
Few-shot‑promptning är en in‑kontext‑anpassningsteknik. Den kan visa beteende som är förknippat med inlärning över uppgifter, men den tränas inte automatiskt med stöd‑/fråge‑avsnitt eller en explicit meta‑optimeringsloop.
Vad är den största risken med meta‑inlärning?
En missmatchning mellan meta‑träningsuppgifter och måluppgiften kan göra att snabb anpassning ser stark ut i ett benchmark men misslyckas i drift. Uppgiftsdelningar och källursprung måste granskas lika noggrant som vanliga tränings‑/test‑delningar.
Primära referenser











