
Grunderna i AI
Vad är transferinlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Transfer learning återanvänder kunskap som lärts för ett problem för att förbättra inlärning på ett relaterat problem. Istället för att initiera varje parameter slumpmässigt, börjar en praktiker med en förtränad modell eller representation och anpassar den till en måluppgift.
Denna metod är särskilt användbar när mål‑datamängden är liten, märkning är dyr, eller förträning kräver mer beräkningskraft än vad målteamet kan motivera. Att träna en modell från grunden är alternativet till transferinlärning – inte en typ av transferinlärning.
Viktiga slutsatser
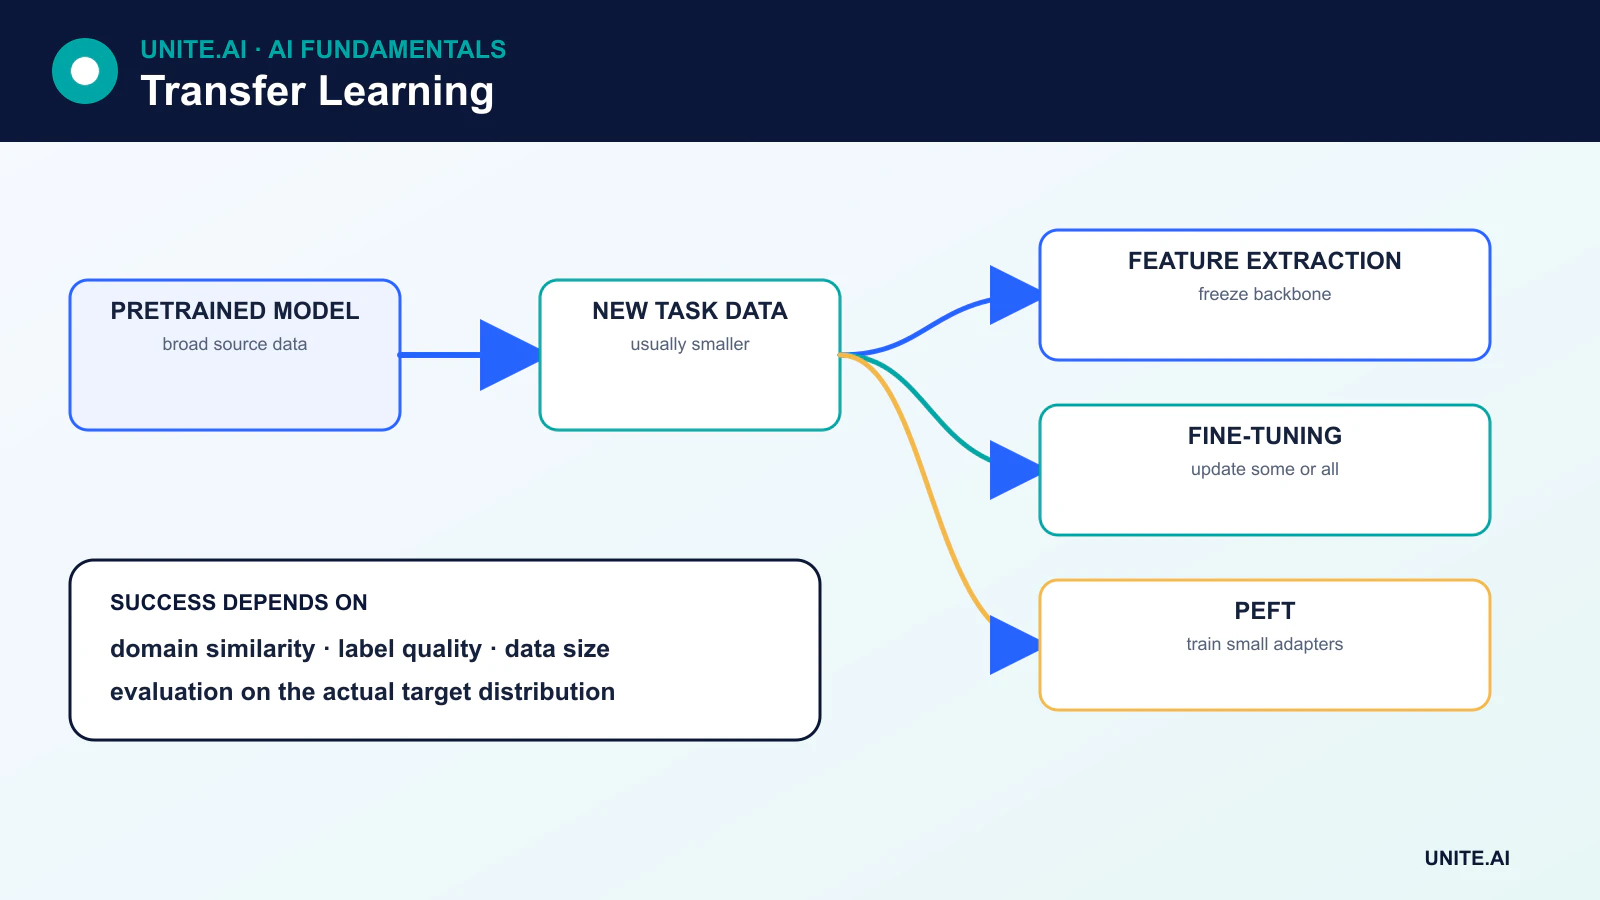
- Feature extraction behåller en förtränad bas fryst och tränar ett nytt uppgifts‑specifikt huvud.
- Fine‑tuning uppdaterar vissa eller alla förtränade parametrar med data från mål‑domänen.
- Parameter‑effektiva metoder såsom adapters och LoRA uppdaterar en liten del av modellen.
- Transfer kan misslyckas när käll‑ och mål‑domäner skiljer sig, licenser är i konflikt, eller källmodellen innehåller olämplig bias.
Varför transferinlärning fungerar
Modeller lär sig ofta representationer som är användbara bortom den exakta data de tränades på. Tidiga lager i en bildmodell kan fånga återanvändbara lokala mönster; en språkmodell kan lära sig syntax, semantik och breda associationer genom själv‑supervised prediktion. En måluppgift kan bygga på dessa representationer istället för att lära om allt från begränsade exempel.
Fördelen beror på likheten mellan käll‑ och måluppgifter, skalan och kvaliteten på förträningen samt hur modellen anpassas. Återanvändning är inte garanterad: överförda funktioner kan vara irrelevanta eller aktivt skadliga.
Funktionsextraktion
Vid funktionsextraktion är den förtränade basen fryst så att dess parametrar inte förändras. Dess utdata blir inmatning till en ny klassificerare, regressormodell eller annat uppgifts‑specifikt huvud. Endast det nya huvudet tränas.
Detta är snabbt och data‑effektivt, och minskar risken att förstöra användbara förtränade representationer. Det kan också leda till underanpassning när mål‑domänen skiljer sig avsevärt från förträningen. Lager såsom batch‑normalisering kräver särskild omsorg eftersom deras lagrade statistik och träningsbeteende kan påverka anpassningen även när de flesta vikter är frysta.
Finjustering
Finjustering uppdaterar förtränade parametrar på mål‑data. Ett vanligt arbetsflöde är:
- Läs in den förtränade modellen och ersätt eller lägg till utdata‑huvudet.
- Frys basen och träna det nya huvudet.
- Upptina valda lager – eller hela modellen – och fortsätt med en lägre inlärningshastighet.
- Validera för överanpassning, glömska och mål‑domänens prestanda.
Det finns ingen universell regel att endast de sista lagren ska justeras. Det bästa valet beror på arkitektur, storlek på mål‑data, domänlikhet, normaliseringslager, minne och beräkningskapacitet. Full finjustering kan ge mer kapacitet men kräver mer resurser och kan leda till katastrofal glömska.
Parameter‑effektiv finjustering
Stora transformers gör full finjustering dyrt. Parameter‑effektiv finjustering (PEFT) modifierar eller lägger till en liten uppsättning parametrar medan majoriteten av basmodellen förblir fryst.
- Adapters infogar små träningsbara moduler i nätverket.
- LoRA representerar viktuppdateringar med låg‑rankade matriser, vilket minskar träningsbara parametrar och optimerarminne.
- Prompt‑ och prefix‑justering lär sig kontinuerliga uppgifts‑specifika inmatningar eller interna prefix.
PEFT kan lagra många uppgifts‑anpassningar kring en basmodell, även om inferens‑tjänst, adapter‑kompatibilitet och hantering av sammanslagna vikter fortfarande kräver noggrann ingenjörskonst.
Transferinlärning över datatyper
Bildklassificerare börjar ofta med modeller som är förtränade på stora bilddatamängder. Språksystem startar från en grundmodell och anpassar den genom övervakad finjustering, preferensoptimering, återvinning eller verktygsanvändning. Tal-, ljud‑, protein‑ och multimodala modeller följer liknande mönster.
Transfer kan också ske utan att ändra den ursprungliga modellen. En fryst modell kan producera inbäddningar för en efterföljande klassificerare, ett vektorsimilaritetssök‑system eller en återvinningspipeline.
Domänskifte och negativ transfer
Domänskifte uppstår när mål‑indata skiljer sig från källdata. En medicinsk bildmodell kan exempelvis möta utrustning, populationer eller acquisitionsprotokoll som saknas i förträningen. Negativ transfer betyder att återanvändning gör målprestandan sämre än en lämplig från‑grunden‑baslinje.
Team bör jämföra anpassningsstrategier, utvärdera meningsfulla undergrupper och behålla ett testset för mål‑domänen. Om källuppgiften är dåligt matchad kan en mindre domänspecifik modell överträffa en större generell modell.
Licensiering, proveniens och säkerhet
En nedladdningsbar modell är inte automatiskt säker att distribuera. Granska licensen, tillåtna användningar, avslöjanden om träningsdata, begränsningar i modell‑kortet och beroendekedjan. Modeller kan reproducera bias, memorera känslig data eller innehålla skadlig serialiserad kod. Använd betrodda format, skanna artefakter och ladda opålitliga vikter i en isolerad miljö.
När man bör använda transferinlärning
Transferinlärning är ett starkt standardval när en relevant förtränad modell finns och mål‑data är begränsad. Träning från grunden kan vara att föredra när domänen är starkt specialiserad, licensiering är inkompatibel, modellstorleken överskrider distributionsgränser, eller en enkel uppgift inte drar nytta av en stor förtränad representation. Beslutet bör valideras empiriskt snarare än antas utifrån modellens skala.
Vad som överförs och hur man anpassar det
Transferinlärning återanvänder representationer som lärts på en källuppgift eller dataset för en måluppgift. Inom vision fångar tidiga funktioner ofta kanter och texturer; inom språk kodar förtränade modeller statistiska mönster över token och kontexter. Transfer fungerar när källrepresentationerna innehåller information som är relevant för målet, men domän-, etikett‑, modalitets‑ och acquisitionsskillnader kan ge negativ transfer. Börja med en förtränad baslinje, granska dess träningslicens och dokumentation, och jämför med att träna en liten mål‑specifik modell från grunden.
Feature extraction fryser ryggraden och tränar ett nytt huvud; partiell finjustering upptinar valda lager; full finjustering uppdaterar hela modellen. Parameter‑effektiva metoder lägger till adapters eller låg‑rankade uppdateringar, vilket minskar träningsbara parametrar men inte nödvändigtvis inferensminnet. Använd en lägre inlärningshastighet för förtränade vikter, bevara normaliseringsbeteendet, och undvik katastrofal glömska med scheman, regularisering, repetition eller begränsade uppdateringar där det behövs. Välj kontrollpunkter på mål‑valideringsdata och testa flera frön eftersom små mål‑datamängder ger hög varians.
Data, utvärdering och distributionsavvägningar
Mål‑data bör representera distributionsförhållanden och viktiga undergrupper, inte bara vara ett bekvämt märkt urval. Dela upp efter ämne, källa, tid eller plats för att förhindra att relaterade exempel korsar partitioner. Testa både i‑domän och skiftade förhållanden. Jämför frysta, delvis justerade och fullt justerade varianter med avseende på kvalitet, kalibrering, träningskostnad, latens och robusthet. En förbättring i genomsnittligt resultat kan dölja en förlust på sällsynta klasser som ärvs från källbias. Granska felexempel för källspecifika genvägar, vokabulärgap eller sensorskillnader.
Spåra basmodellen, vikter, tokenizer eller förbehandling, adapter, data och licens som ett beroendegraf. Hostade basmodeller kan ändra beteende; öppna vikter kan introducera leverantörskedje‑ och patchningsansvar. Validera den sammanslagna eller exporterade artefakten och skanna modellfiler från opålitliga källor. I produktion, övervaka mål‑drift och prestanda, och behåll möjligheten att återgå både anpassning och basversion. Transfer minskar den nödvändiga mål‑datamängden; det eliminerar inte märkning, utvärdering, integritet eller domänexpertis.
Arbetsexempel: anpassa en vision‑modell till en ny klinik
En klinik anpassar en förtränad bildkodare för att klassificera bildkvalitet före diagnostisk granskning. Den verifierar källmodellens licens och avsedda modalitet, samlar in lokala enheter och acquisitionsförhållanden, och delar upp efter patient. Frysta‑funktioner, adapter, partiell och full finjustering jämförs med en liten lokal baslinje. Mätvärden inkluderar klass‑återkallelse, kalibrering, undergruppsbeteende, beräkningskostnad och känslighet för enhet, plats och sällsynta artefakter.
Den anpassade modellen kan inte ställa en diagnos och dirigerar låg‑konfidens‑ eller ej stödda bilder till tekniker. Exportvalidering bekräftar lokal förbehandling och numerisk ekvivalens. Modell, adapter, enhet och dataset‑versioner länkas i registret. Övervakning upptäcker nya skannrar, protokolländringar och resultat‑drift, medan periodiska granskade prover uppskattar verklig prestanda. En uppgradering av källmodellen behandlas som ett nytt beroende som kräver validering; transferinlärning rättfärdigar inte automatiskt återanvändning av gammal evidens.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset före justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, distributionsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och särskilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för utgivning, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör visa indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter distribution snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Primära referenser











