
Grunderna i AI
Vad är generativ AI?

 Lägg till Unite.AI bland dina föredragna källor på Google
Generativ AI avser modeller som lär sig mönster i data och producerar ny text, bilder, ljud, video, kod eller andra representationer när de styrs av instruktioner eller exempel. Utdata syntetiseras från en sannolikhetsmodell; de hämtas inte intakta från en databas, även om återhämtningsverktyg kan tillhandahålla extern bevisning.
Olika modellfamiljer genererar på olika sätt. Autoregressiva transformatorer förutsäger en sekvens en token i taget, diffusionsmodeller avlägsnar iterativt brus från ett prov, och generativa adversariella nätverk lär sig genom en tävling mellan en generator och en diskriminator.
Viktiga punkter
- Generering är villkorlig sampling från en inlärd fördelning, inte garanterad faktuell återkallelse.
- Transformatorer, diffusionsmodeller, GAN:er och variational autoencoders gör olika avvägningar.
- Återhämtning och verktyg kan förankra ett system, men deras utdata och behörigheter kräver fortfarande validering.
- Riskhantering omfattar data, modell, gränssnitt, distribution, övervakning och innehållsproveniens.
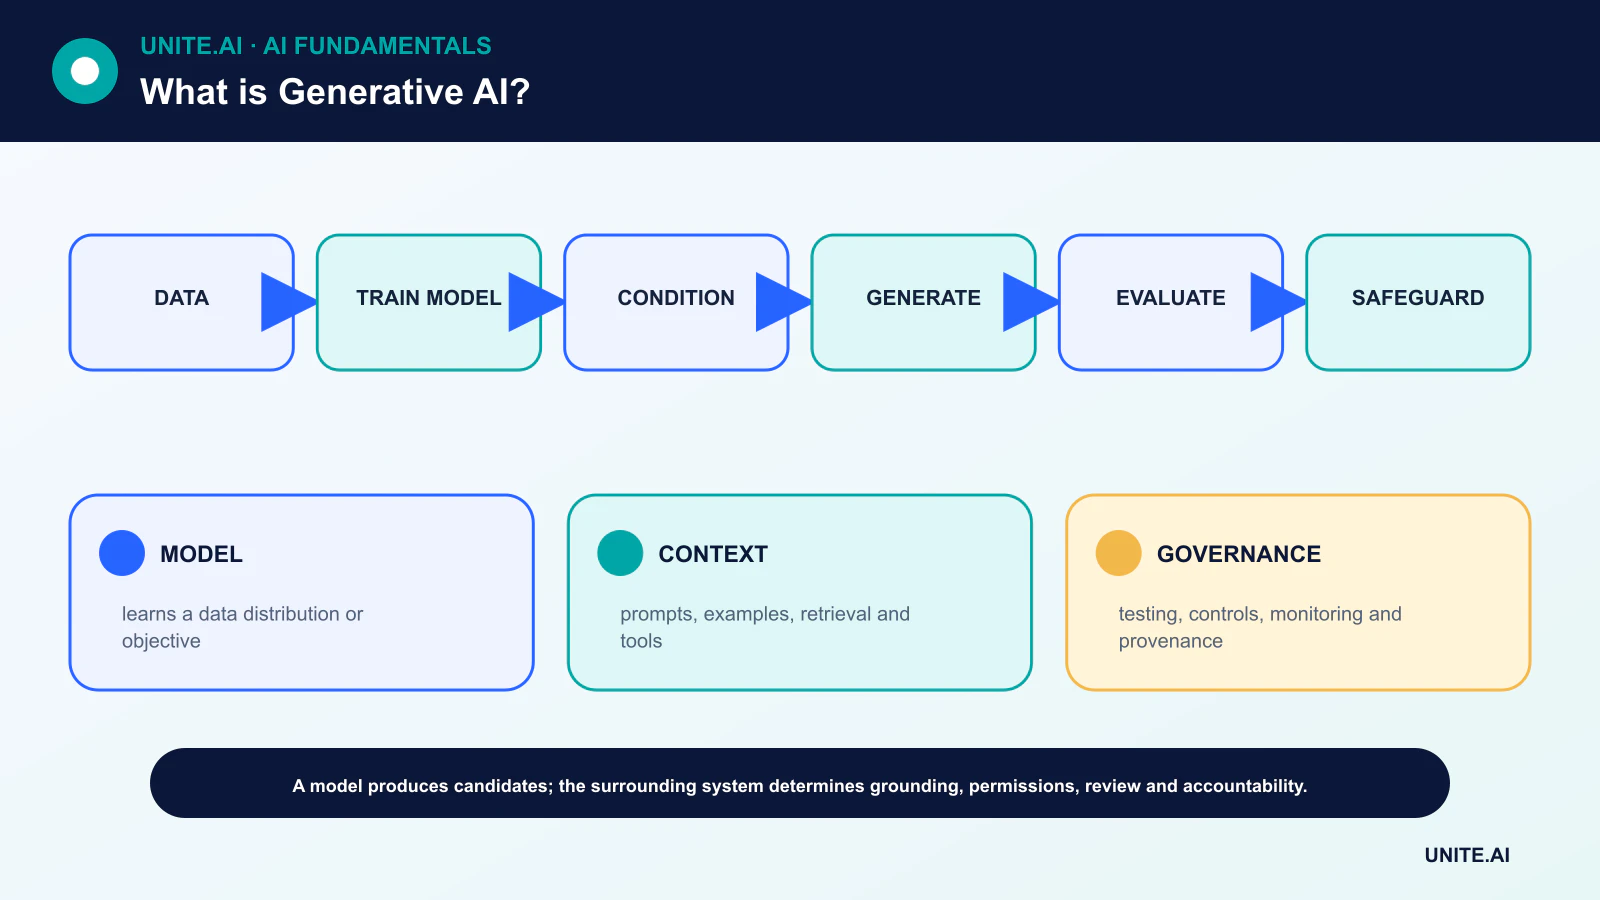
Hur generativa modeller lär sig
Träningsmål belönar en modell för att förutsäga eller rekonstruera mönster i exempel. En språkmodell uppskattar nästa token; en diffusionsmodell lär sig att vända en brusprocess; en variational autoencoder lär sig en strukturerad latent fördelning och avkodare.
Denna träning skapar statistisk generalisering, men den kan också reproducera bias, memorera ovanliga sekvenser eller misslyckas utanför datadistributionen. Dokumentation av dataset, deduplicering, sekretesskontroller och håll‑ut‑evaluering är därför viktiga innan distribution.
Större arkitekturfamiljer
Autoregressiva transformers dominerar text och stödjer multimodala sekvenser. Diffusionsmodeller används i stor utsträckning för högupplöst bild‑ och ljudgenerering. GAN:er kan skapa skarpa prover och styrbara bildsystem men kan vara svåra att träna.
Variational autoencoders erbjuder latentvariabelmodellering och effektiva representationer, ibland som en del av större generativa pipelines. Verkliga produkter kombinerar ofta flera modeller med återhämtning, filter, verktyg och deterministisk kod.
Konditionering, sampling och kontroll
En prompt, klassetikett, bild, ljudklipp eller strukturerad post kan konditionera generering. Samplingsparametrar förändrar mångfald och determinism. Lägre temperatur kan koncentrera token‑sannolikheter, men det gör inte ett felaktigt svar sant.
Kontrollen förbättras när systemet använder explicita scheman, begränsad avkodning, referensmaterial och validering. Prompt‑engineering ändrar kontext; finjustering ändrar parametrar; återhämtning tillhandahåller extern information. Var och en adresserar ett annat felmode.
Utvärdering är applikationsspecifik
Textsystem kan behöva faktualitet, uppgiftsutförande, citeringsstöd, toxicitet och kalibreringstester. Bild‑ eller ljudsystem kan behöva trohet, semantisk anpassning, mångfald, identitetssäkerhet och perceptuell granskning. Kombinera automatiska mått med representativ mänsklig utvärdering.
Bygg en versionerad utvärderingsuppsättning som inkluderar vanliga, sällsynta, adversariella och policyrelevanta fall. Spåra latens, kostnad och avvisningsbeteende samt utdatakvalitet. En demo som valts av sin skapare är inte bevis på pålitlighet på befolkningsnivå.
Risker, skyddsåtgärder och proveniens
Viktiga risker inkluderar hallucination, prompt‑injektion, skadligt innehåll, personifiering, osäker verktygsanvändning, sekretessläckage, upphovsrättstvister, automationsbias och otransparenta leveranskedjor. NIST:s Generative AI Profile organiserar åtgärder över styrning, innehållsproveniens, förhands‑testning och incidentrapportering.
Använd verktyg med minsta privilegium, in‑/utdata‑kontroller, mänsklig granskning för avgörande beslut, loggning, återgång och användarrapportering. Vattenmärken eller innehålls‑certifikat kan lägga till signaler, men ingen enskild detektor eller etikett fastställer sanningen. Det bredare synthetic‑media-arbetsflödet måste bevara kontext och ansvarstagande.
Modellfamiljer och generationsmekanismer
Generativa AI‑modeller uppskattar eller lär sig en process som kan producera ny text, bilder, ljud, video, kod eller strukturerad data. Autoregressiva modeller förutsäger nästa token eller element; diffusionsmodeller lär sig att vända en brusprocess; variational autoencoders lär sig sannolika latenta variabler; GAN:er tränar en generator mot en diskriminator. Multimodala system kopplar representationer över medier. Utdata samplas från inlärd statistisk struktur konditionerad på prompts, kontext, verktyg eller andra indata – de hämtas inte som en garanterad fakta.
Fundamentala modeller är förtränade på bred data och anpassas via prompting, återhämtning, finjustering, preferensoptimering, kontrollnätverk eller uppgiftsspecifika huvuden. Tokenizers, encoders, decoders, latenta utrymmen och samlingsinställningar formar resultaten. Temperatur och kandidat‑filtrering avväger determinism och mångfald. Längre prompts ger kontext men kan vara i konflikt, distrahera eller innehålla skadliga instruktioner. Återhämtning kan förankra förändrande kunskap, medan deterministisk kod bör hantera exakta beräkningar och regler.
Utvärdering, proveniens och rättigheter
Utvärdera efter uppgift: faktuell korrekthet och citering för svar, exekvering och säkerhet för kod, trohet och mångfald för media samt mänskligt resultat för kreativ assistans. Inkludera avvisning, kalibrering, latens, kostnad, språk, tillgänglighet och adversariella tester. En flytande eller fotorealistisk utdata kan vara felaktig. Bevara modell, prompt, seed, källbevis, verktygsanrop och efterbehandling för reproducerbarhet. Separera återhämtningskvalitet från generering så att ett polerat svar inte kan dölja saknade bevis.
Träning och utdata väcker frågor om upphovsrätt, licens, samtycke, sekretess, offentlighet och konfidentialitet. Etablera proveniens och tillåten användning för indata; förhindra att användare avslöjar hemligheter; testa memorering; och tillhandahåll rapporterings‑ och borttagningsprocesser. Syntetisk media bör bära hållbar proveniens eller avslöjande där det är möjligt, särskilt när den kan misstas för bevis. Använd inte likhet, röst eller stil på sätt som bryter mot rättigheter eller vilseleder.
Distributionskontroller
Behandla modellens utdata som opålitlig indata. Validera scheman, sanera kod och filer, isolera exekvering, auktorisera varje verktyg externt, begränsa kostnad och hastighet, och kräva bekräftelse för avgörande åtgärder. Övervaka fel, missbruk, drift och användarkorrigeringar, med återgång och en icke‑generativ reserv. Dokumentera avsedd och förbjuden användning. Generativ AI utvidgar gränssnittet för att skapa och omvandla information, men pålitlighet och ansvarstagande kommer från den omgivande datan, utvärderingen, säkerheten, proveniens och den mänskliga beslutsprocessen.
Arbetsexempel: en generativ produktbeskrivningsassistent
En återförsäljare låter redaktörer generera utkast till beskrivningar endast från godkända produktattribut och varumärkesriktlinjer. Prompten innehåller strukturerade fakta, medan återhämtning tillhandahåller aktuell policy. Utdata måste följa ett schema och valideras mot källvärden; ej stödda dimensioner, säkerhetsanspråk eller certifieringar leder till avslag. Utvärderingen omfattar faktuell noggrannhet, stil, duplicering, flerspråkig kvalitet, tillgänglighet, latens och redaktörskorrigering, jämfört med mallar och manuell skrivning.
Redaktörer godkänner varje publicering och kan se källfält. Modellen har ingen möjlighet att ändra pris, lager eller publicera direkt. Prompter och produktdata skyddas mot injektion, och konfidentiella leverantörsanteckningar exkluderas. Övervakning spårar ej stödda påståenden, redigeringar, klagomål, kostnad och leverantörsversioner. Genererad text lagras med proveniens. Systemet sparar tid för utkast endast om korrigeringar och granskning inte raderar fördelen och produktens sanning förblir styrd av auktoritativ data.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera de avsedda användarna, driftmiljön, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar grundlinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, sekretess och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, ändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indatakvalitet, utdatabeteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter distribution snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återhämtning, incident‑lärande, raderings‑ och behållningsprocedurer, samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är generativ AI detsamma som en stor språkmodell?
Nej. LLM:er är en klass av generativ modell. Generativ AI omfattar också bild-, ljud-, video‑ och strukturerade datasystem som byggs med flera arkitekturer.
Kopierar en modell sin träningsdata?
Den syntetiserar vanligtvis från inlärda mönster, men memorering och närapå‑duplication kan förekomma. Sekretess‑ och proveniensrisker måste utvärderas snarare än antas försvinna.
Primära referenser












