
Grunderna i AI
Vad är datavetenskap?

 Lägg till Unite.AI bland dina föredragna källor på Google
Data science är praktiken att omvandla data till försvarbar kunskap, förutsägelser eller beslut. Den kombinerar domänexpertis, statistik, databehandling, data‑engineering, visualisering och kommunikation. En modell kan vara en del av arbetet, men disciplinen börjar före modellering och fortsätter efter driftsättning.
Den viktigaste frågan är inte ”Vilken algoritm ska vi använda?” utan ”Vilket beslut stödjer vi, vilken evidens skulle besvara det, och hur vet vi att resultatet förblir användbart?”
Viktiga slutsatser
- Data science är ett end‑to‑end‑arbetsflöde för evidens, inte ett synonym för maskininlärning.
- Problembeskrivning, mätning och datastyrning avgör ofta framgång mer än modellens komplexitet.
- Prediktiva och kausala frågor kräver olika antaganden och utvärderingsdesigner.
- En driftsatt analys kräver övervakning, dokumentation och kommunikation som är lämplig för dess användare.
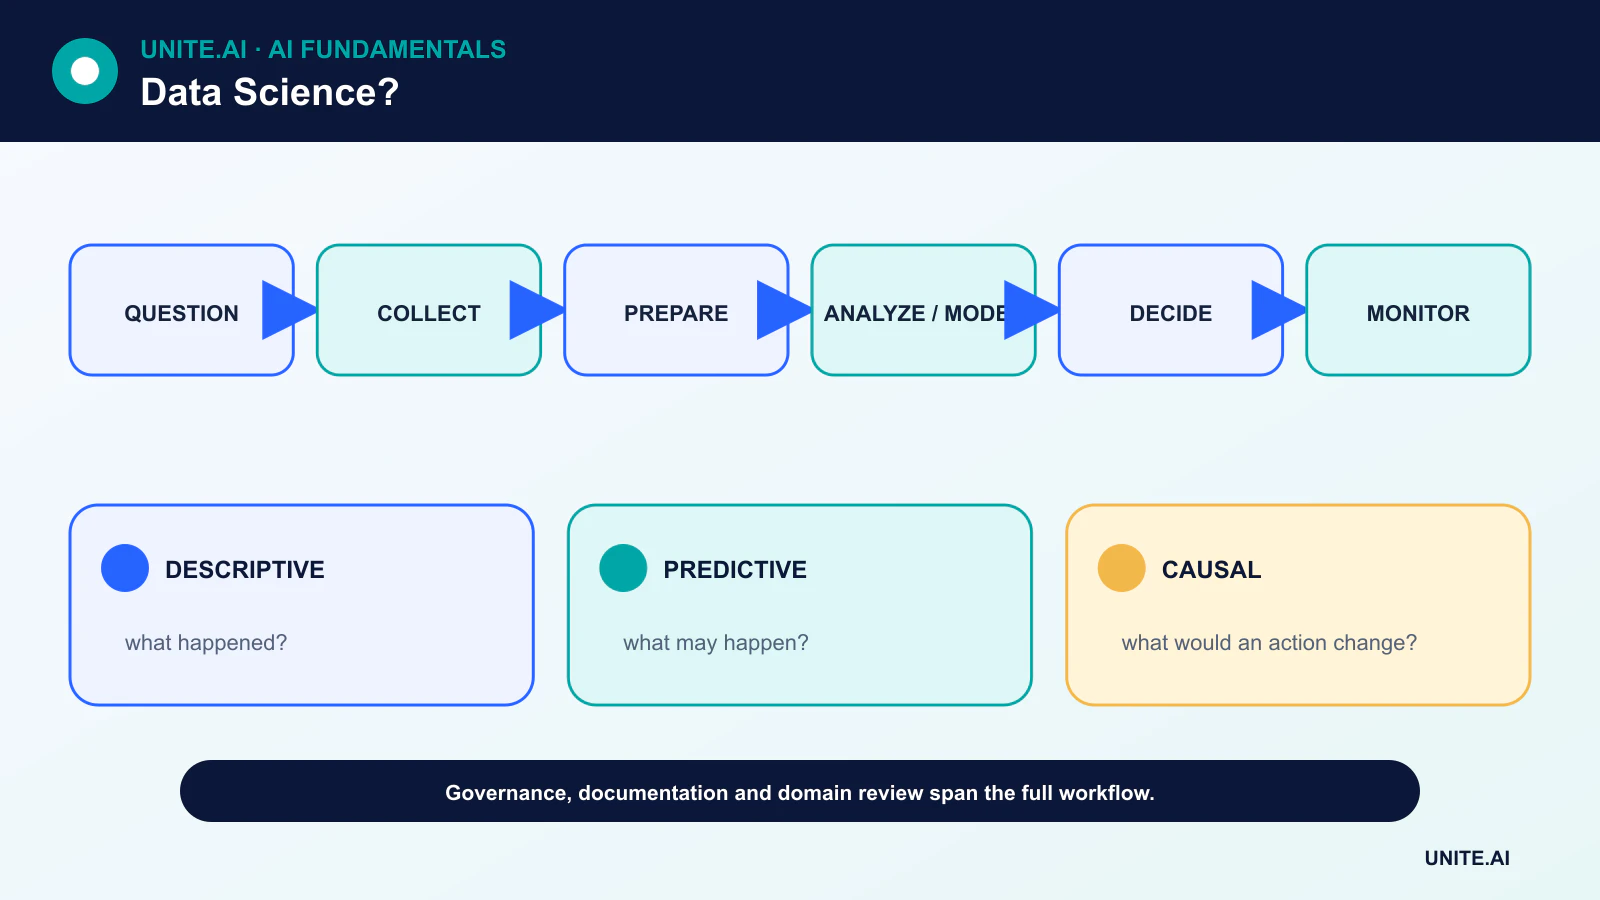
Börja med ett beslut och ett estimand
Ett projekt bör identifiera användaren, beslutet, interventionen och felkostnaden. För en beskrivande fråga kan målet vara en frekvens eller trend. För prediktion kan det vara framtida efterfrågan eller risk. För en kausal fråga beskriver estimandet effekten av en definierad intervention under angivna antaganden.
Vaga mål som ”hitta insikter” gör utvärdering omöjlig. Ett mätbart mål skapar en gräns för datainsamling och förhindrar att analysen expanderar till alla tillgängliga fält.
Samla in, styr och förstå data
Team gör en inventering av källor, ägarskap, samtycke, lagring, härkomst och åtkomst. De skiljer mellan strukturerad och ostrukturerad data, definierar enheter och tidsstämplar samt undersöker huruvida poster representerar den aktuella populationen och tidsperioden.
Rengöring handlar inte bara om att ta bort saknade rader. Det inkluderar att lösa dubbletter, omöjliga värden, etikett‑oklarhet, schema‑drift, censurering och sammanslagningar som förändrar analysenheten. Varje transformation bör vara reproducerbar och dokumenterad.
Utforska innan modellering
Explorativ analys studerar fördelningar, saknade värden, samband och potentiella mätartefakter. Visualisering kan avslöja avvikare och undergruppsskillnader som ett sammanfattande medelvärde döljer. Utforskning bör informera hypoteser utan att förväxlas med bekräftande evidens.
Feature‑engineering, dimensionalitetsreduktion och representationsinlärning kan förbättra modellering, men transformationer måste anpassas endast på träningsdata för att förhindra läckage.
Välj metoder för frågan
Statistisk uppskattning kvantifierar osäkerhet kring intressanta kvantiteter. Maskininlärning är användbart när huvudmålet är prediktiv prestanda på ny data. Experiment och kausala inferensmetoder krävs när målet är en interventions‑effekt.
En baslinje bör vara tillräckligt enkel att förstå. Mer komplexa modeller måste förtjäna sin extra kostnad genom bättre prestanda på håll‑ut‑data, kalibrerad osäkerhet, operativt värde eller en nödvändig funktion såsom bild‑ eller språkbehandling.
Utvärdera, kommunicera och övervaka
Utvärderingen bör matcha beslutet. En klassificerare kan kräva precision, recall, kalibrering och undergruppsanalys snarare än enbart noggrannhet; ett prognossystem behöver tidsmedveten backtesting. Överanpassning och läckage är processfel, inte bara modellens egenskaper.
Kommunikation inkluderar antaganden, osäkerhet, begränsningar och rekommenderade åtgärder. När en modell eller instrumentpanel används, övervakar teamet indata‑kvalitet, resultat‑drift, användarbeteende och nedströms‑påverkan. En pensionerad beslutsprocess behöver ett arkiv och tydligt ägarskap precis som en driftsatt process behöver en operatör.
Datavetenskapens livscykel och analytiska frågor
Data science kombinerar domänkunskap, statistik, databehandling och kommunikation för att omvandla data till evidens för beslut. Börja med att särskilja beskrivning, diagnos, prediktion och kausal inferens. En instrumentpanel som rapporterar vad som hände, en modell som förutspår vem som kommer att churna, och ett experiment som uppskattar huruvida en intervention förändrar churn svarar på olika frågor. Definiera enhet, population, tidsfönster, utfall, åtgärd och felkostnad innan data extraheras. Många misslyckade projekt löser en mätbar proxy som inte kan stödja det avsedda beslutet.
Anskaffning kräver proveniens, behörigheter, urvalsdesign och ett datakontrakt. Utforskning kontrollerar fördelningar, saknade värden, dubbletter, avvikare, samband, mätförändringar och potentiellt läckage. Rengöringsval är analytiska antaganden: att radera saknade rader, imputera värden eller begränsa avvikare kan förändra populationen och slutsatsen. Versionera rådata oföränderligt och transformationer som kod, och skapa en datadictionary med enheter och betydelse. Dela upp utvärderingsdata innan transformationer lärs eller hypoteser testas upprepade gånger.
Modellering, inferens och reproducerbarhet
Statistisk inferens kvantifierar osäkerhet under antaganden; prediktiv modellering uppskattar prestanda på out‑of‑sample‑data; kausal analys kräver identifiering genom design eller försvarbara antaganden. Välj metoder som matchar frågan och den data‑genererande processen. Jämför med enkla baslinjer, använd grupperad eller tidsmedveten validering, och rapportera osäkerhet och känslighet. En hög korrelation eller funktionens betydelse fastställer inte kausalitet. Multipla tester, forskarens frihetsgrader och selektiv rapportering kan skapa övertygande mönster, så förregistrering eller ett tydligt separerat bekräftande steg kan hjälpa.
Reproducerbarhet inkluderar kod, miljö, datamoment, slumpfrön, fråge‑definitioner och en logg över manuella beslut. Automatiserade tester bör täcka scheman, affärsinvarians, transformationer och mått. Anteckningsböcker är värdefulla för utforskning men produktionsarbete kräver modulära, granskbara pipelines. Kollegial granskning bör utmana antaganden, läckage, målvaliditet och om resultaten generaliseras. Kommunicera effektstorlekar, osäkerhet, begränsningar och motbevis snarare än enbart statistisk signifikans eller en modells poäng.
Driftsättning och beslutsinverkan
Om analysen driver en återkommande process, tilldela ägare, övervaka datans fräschör och resultatkvalitet, och definiera återgång eller pensionering. Skydda personlig och konfidentiell information genom minimering, åtkomstkontroll, lagring och säkra utdata. Utvärdera undergruppseffekter och hur användare reagerar på modellen; återkopplingsslingor kan förändra framtida data. Mät om beslutet förbättrade det verkliga målet, inte bara om en modell driftsattes. Data science är framgångsrik när evidens förändrar handlingar på ett pålitligt och transparent sätt – inte när en organisation samlar instrumentpaneler, funktioner eller experiment utan ägarskap.
Praktiskt exempel: mätning av en retention‑intervention
Ett produktteam observerar lägre retention och definierar en aktiv användare, kohort, fönster, exkluderingar och beslut. Analytiker granskar instrumentering, saknade händelser och anskaffningsmix innan modellering. Beskrivande kohorter identifierar var nedgången sker, en prediktiv modell prioriterar forskningsdeltagare, och ett randomiserat onboarding‑experiment uppskattar huruvida den föreslagna förändringen förbättrar retention. Detta är tre separata analyser med egna antaganden och resultat.
Anteckningsboken, frågorna, datamomentet, metriksdefinitionen och experimentplanen versioneras och granskas av kollegor. Resultaten rapporterar effektstorlek och osäkerhet med skyddsmekanismer för supportbehov och tillgänglighet. En instrumentpanel övervakar experimentet men ersätter inte den fördefinierade analysen. Om interventionen lyckas förblir utrullningen stegvis och kontrollerar långsiktigt beteende. Arbetet anses värdefullt endast om det stödjer ett reproducerbart beslut, inte för att en komplex modell eller visuellt imponerande diagram skapades.
Implementerings‑evidens och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionerat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja evidens från en attraktiv prototyp.
Före lansering, tilldela behörighet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regel‑version, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verklig evidens efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incident‑lärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är datavetenskap samma som dataanalys?
Begreppen överlappar. Datavetenskap inkluderar ofta att bygga dataprodukter och prediktiva system, medan analys kan fokusera mer på beskrivande och diagnostiskt beslutsstöd. Användningen inom organisationer varierar.
Behöver varje datavetenskapsprojekt AI?
Nej. En välutformad fråga, diagram, experiment eller statistisk uppskattning kan vara mer användbar och pålitlig än en komplex modell.
Primära referenser











