
Grunderna i AI
Vad är ett datalager? Arkitektur, ETL och användningsfall

 Lägg till Unite.AI bland dina föredragna källor på Google
Ett datalager är ett analytiskt datasystem som integrerar information från operativa källor och organiserar den för rapportering, affärsintelligens och återupprepbar analys. Det separerar många analytiska arbetsbelastningar från de applikationer som registrerar transaktioner.
Moderna lager kan vara kolumnbaserade, distribuerade, serverlösa eller anslutna till objektlagring. Det grundläggande arbetet förblir konsekvent: styrd insamling, modellerad betydelse, historik, frågeprestanda, säkerhet, kvalitet och pålitlig leverans till användare.
Viktiga slutsatser
- Operativa system optimerar aktuella transaktioner; lager optimerar historisk analys över källor.
- ETL transformerar innan laddning, medan ELT laddar först och transformerar inom den analytiska plattformen.
- Dimensionala, normaliserade och bredtabellsmodeller betjänar olika arbetsbelastningar och styrningsbehov.
- Förtroende beror på härledning, tester, aktualitet, åtkomstkontroll, semantiska definitioner och kostnadsövervakning.
Källor, insamling och lagring
Data kan komma in via batchar, förändringsdatafångst, strömmar, filer och API:er. Ett landningslager bevarar källkontext; transformationer standardiserar typer, avduplicerar poster, hanterar sena händelser och skapar återanvändbara analytiska enheter.
Detta utökar ETL‑arbetsflödet. ELT använder lagerets beräkningskraft för transformation, medan ETL kan reducera eller validera data innan laddning. Det rätta valet beror på latens, integritet, skala och verktygskedja.
Modellera data för frågor
Dimensionala modeller organiserar mätbara fakta kring beskrivande dimensioner som kund, produkt och tid. Normaliserade kärnmodeller kan bevara företagsrelationer, medan denormaliserade martar förenklar vanliga frågor.
Ett semantiskt lager ger metriska definitioner som är konsekventa. Utan det kan team producera flera till synes korrekta intäkts- eller retentionstal från samma rader. Strukturerad data kräver fortfarande en överenskommen betydelse.
Datalager, sjö och lakehouse
En datalake lagrar vanligtvis filer och mångsidig rå- eller bearbetad data i objektlagring. Ett lager tillhandahåller hanterade analytiska tabeller och frågetjänster. Lakehouse‑designer lägger till tabellmetadata, transaktioner och styrning till lake‑lagringen.
Dessa är arkitekturmönster, inte garantier. Organisationer kombinerar dem ofta via ett data‑fabric eller ett gemensamt styrningslager. Arbetsbelastning, kompetens, interoperabilitet och livscykelkostnad väger tyngre än etiketten.
Kvalitet, säkerhet och drift
Definiera ägare, kontrakt, aktualitetsmål, härledning, tester, lagringstid och rad- eller kolumnåtkomst. Separera personligt identifierbar data, använd minsta privilegium och granska känsliga frågor. Backfills och schemaändringar kräver kontrollerade, observerbara procedurer.
Mät lyckade uppdateringar, datafördröjning, testfel, frågeprestanda, adoption, incidentpåverkan och kostnad per arbetsbelastning. Ett lager är användbart när personer kan spåra en metrisk till styrd data och reproducera resultatet.
Dimensional modellering och semantik
En faktatabell registrerar händelser eller periodiska mätningar på en angiven granularitet, såsom en orderrad eller en enhet per timme. Dimensioner ger beskrivande kontext. Att deklarera granularitet innan kolumnval förhindrar blandning av nivåer som kan leda till dubbelräkning. Additiva mått kan summeras över alla dimensioner; semi‑additiva mått kräver försiktighet över tid.
Surrogatnycklar frikopplar lagerhistorik från föränderliga källidentifierare. Långsamt föränderliga dimensioner definierar hur attributförändringar hanteras: skriva över, bevara en ny historisk rad eller behålla begränsade tidigare värden. Den korrekta metoden följer den analytiska frågan och lagringsförpliktelser.
Ett semantiskt mått bör definiera formel, filter, tidsbeteende, valuta, undantag, ägare och tester. Centrala definitioner minskar inkonsekvens, men styrning bör tillåta föreslagna ändringar och versionering. Ett enskilt semantiskt lager blir en flaskhals om användare inte kan inspektera eller utöka det på ett ansvarsfullt sätt.
Modern lagring och frågearkitektur
Kolumnlagring håller värden i en kolumn samlade, vilket förbättrar komprimering och skannar endast nödvändiga fält. Partitionering beskär stora sektioner efter datum eller annan nyckel; klustring placerar relaterade värden tillsammans; materialiserade vyer och cache återanvänder resultat. Dåliga partitionsval skapar små filer, snedvridning eller dyra fulla skanningar.
Massivt parallella frågemotorer delar upp skanningar, join‑operationer och aggregationer över arbetare. Datamovement under join kan dominera körtiden, så distribution, statistik och join‑ordning är viktiga. Autoskalning och serverlösa tjänster förenklar kapacitet men kräver kostnadskontroller, arbetsbelastningsprioriteringar och begränsningar för okontrollerade frågor.
Lakehouse‑tabellformat lägger till metadata, snapshots, schema‑evolution och transaktionssemantik över objektfiler. De förbättrar interoperabilitet men medför katalog‑ och underhållsansvar. Öppna format minskar inlåsning endast när beräkningsmotorer, styrning och operativa rutiner faktiskt kan använda dem.
Tillförlitliga pipelines och dataprodukter
Pipelines bör vara idempotenta eller kunna lösa dubbletter. Vattenmärken och händelsetid hanterar sena ankomster; backfills återproducerar historiska transformationer; schemaavtal definierar kompatibla förändringar. Datatester omfattar unikhet, fullständighet, accepterade värden, relationer och affärsinvarianter – inte bara om ett jobb kördes.
Behandla viktiga dataset som produkter med ägare, dokumentation, tjänsteförväntningar, upptäckbarhet, support och användare. Härledning kopplar källfält genom transformationer till rapporter, vilket gör förändringspåverkan och incidentutredning snabbare. Åtkomstpolicyer bör spridas eller omvärderas när data kopieras.
Ett lagerprogram lyckas när beslut blir mer pålitliga och snabbare, inte när lagringsvolymen ökar. Avveckla oanvända tabeller, visa fråga‑ och lagringskostnad, granska känslig åtkomst och mät om team litar på och återanvänder styrda mått istället för att underhålla privata kalkylblad.
Arbetsexempel: design av ett försäljningsanalysdatalager
Definiera faktagranulariteten som en slutförd orderrad och länka sedan produkt-, kund-, kanal-, kampanj-, geografiska- och datumdimensioner via surrogatnycklar. Håll orderstatushändelser i en separat faktatabell istället för att blanda snapshots och transaktioner. Intäkter, kvantitet, rabatt, skatt och kostnad kräver explicit valuta, retur, avbokning och redovisningsregler. Metrikdefinitionen bör ge samma svar i instrumentpaneler, notebooks och finansiell avstämning.
Inmatning fångar källförändringar, landar oföränderlig rådata, validerar schema och transformerar den till testade staging‑ och dimensionala modeller. Sena uppdateringar måste korrigera rätt historisk period utan att duplicera fakta. Jämför radantal och monetära totaler med källsystem, testa unikhet och relationer samt registrera härledning från rapportfält till källa. Backfills använder versionsstyrd kod och isolerad validering innan betrodda tabeller ersätts.
Åtkomst separerar kundidentifierare från brett tillgängliga aggregationer och tillämpar minsta privilegium efter roll och syfte. Arbetsbelastningshantering håller ledningsinstrumentpaneler responsiva medan analytiker kör utforskande frågor. Övervaka aktualitet, misslyckade tester, frågekostnad, oanvända tabeller och semantiska förändringar. Ett lager är framgångsrikt när styrda mått stödjer återupprepbara beslut; att bara centralisera data kan centralisera förvirring om ägandeskap, kvalitet och definitioner förblir olösta.
Katastrofåterställning bör ange backup‑täckning, kopior över regioner, katalog‑ och behörighetsåterställning, acceptabel dataförlust och återställningstid. Testa återställning i en isolerad miljö och verifiera mått, inte bara filer. Krypteringsnycklar, identitetskonfiguration, orkestreringskod och semantiska definitioner är en del av det återställningsbara systemet. Ett lager som kan återställa petabyte men inte kan reproducera åtkomstpolicy eller betrodda beräkningar har inte återställt sin analytiska tjänst.
Praktisk implementeringschecklista
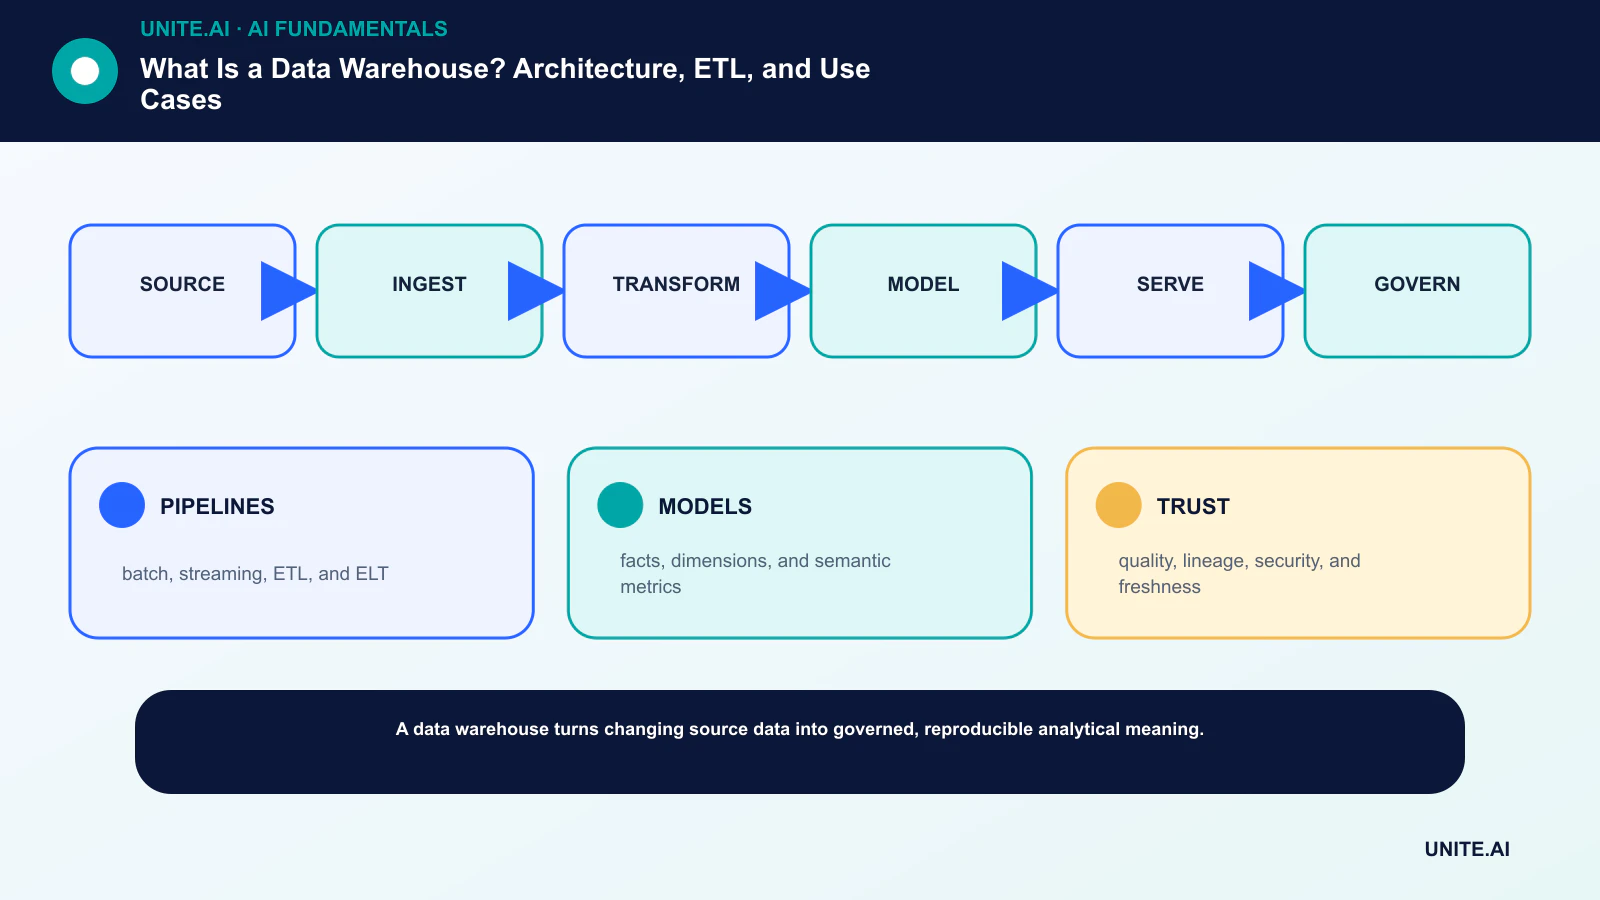
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: källa → inmatning → transformation → modell → leverans → styrning. Namnge en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevis och olösta risker. Definiera vem som kan godkänna release, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- PIPELINES: batch, streaming, ETL och ELT.
- MODELS: fakta, dimensioner och semantiska mått.
- TRUST: kvalitet, härledning, säkerhet och aktualitet.
Vanliga frågor
Är ett datalager bara en stor databas?
Det är en databas eller analytisk plattform utformad för integrerad, historisk analys. Dess modellering, insamling, styrning och arbetsbelastningsmönster skiljer sig från en transaktionsapplikationsdatabas.
Bör ett företag använda ETL eller ELT?
Många använder båda. Transformera tidigt när integritet, validering eller bandbredd kräver det; transformera efter laddning när lagerberäkning och snabb iteration är fördelaktiga.
Primära referenser











