
Grunderna i AI
Vad är ett generativt adversarialt nätverk (GAN)?

 Lägg till Unite.AI bland dina föredragna källor på Google
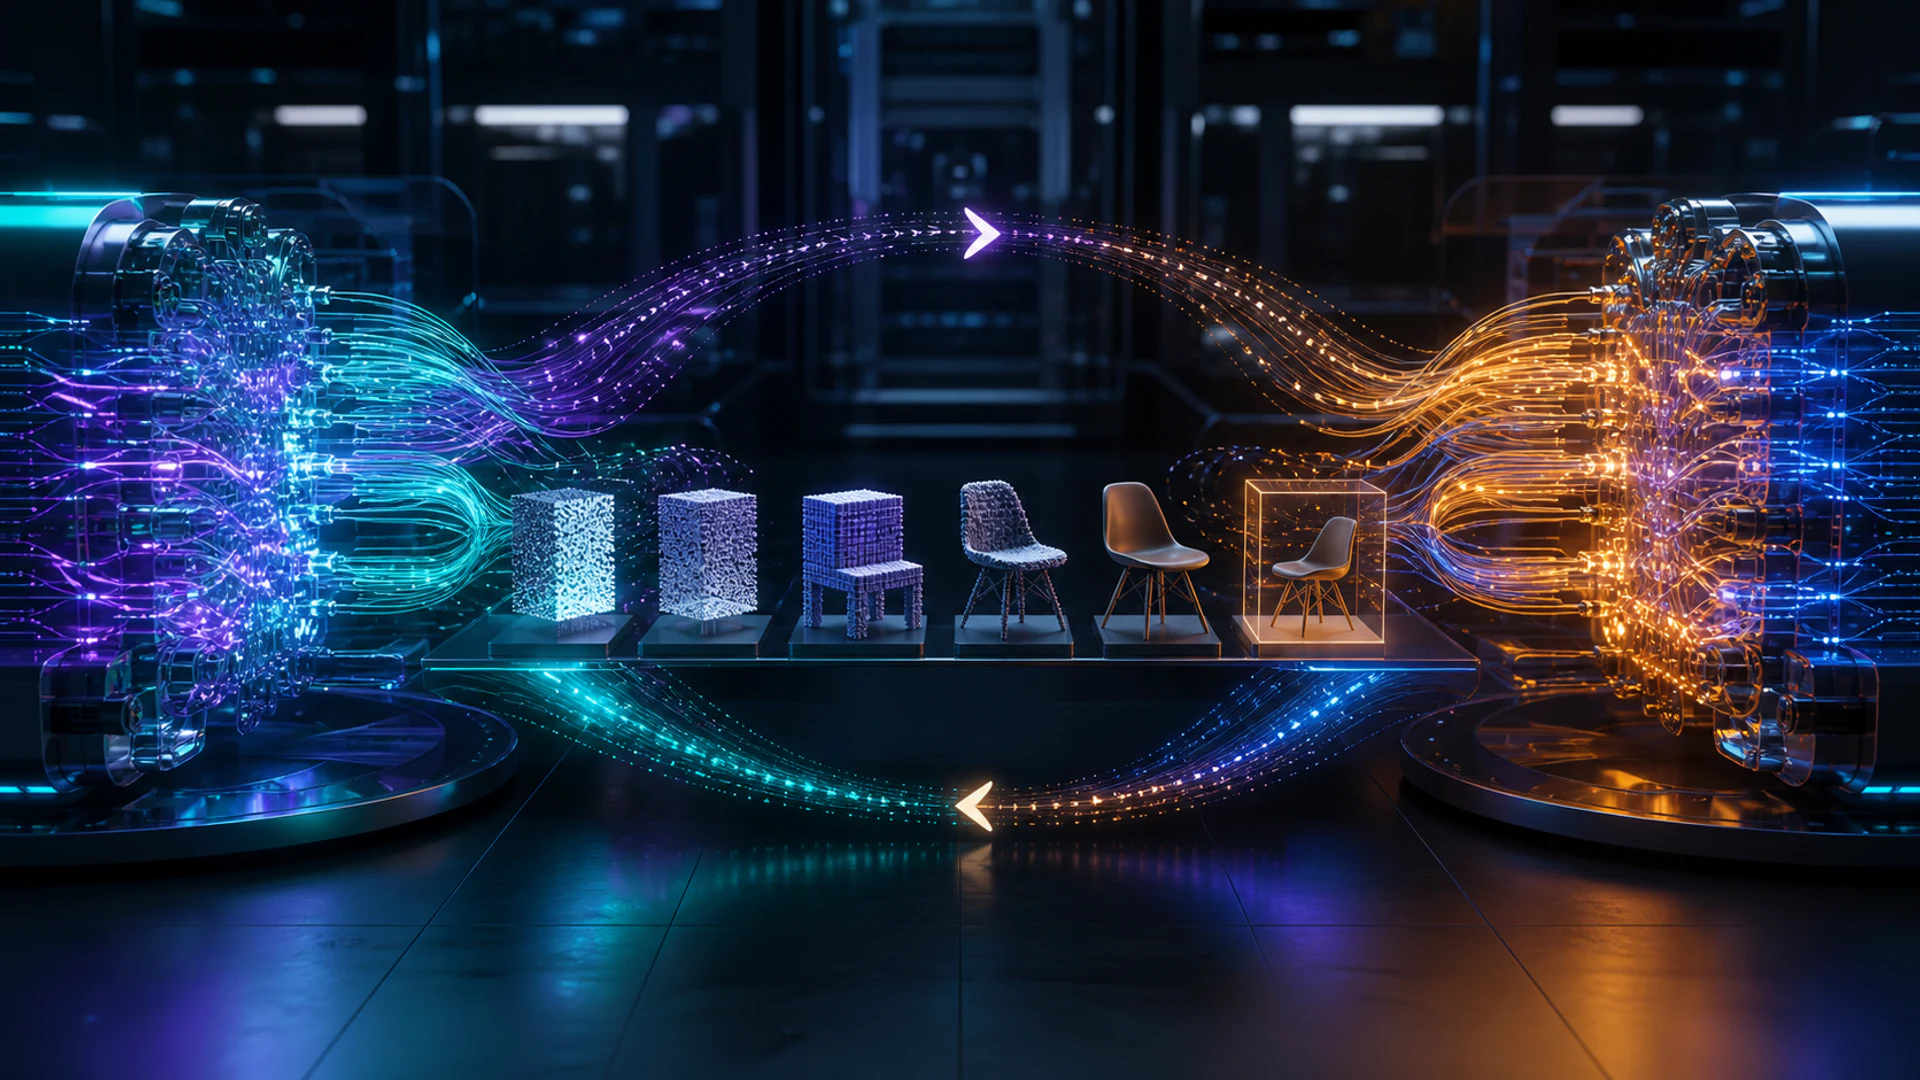
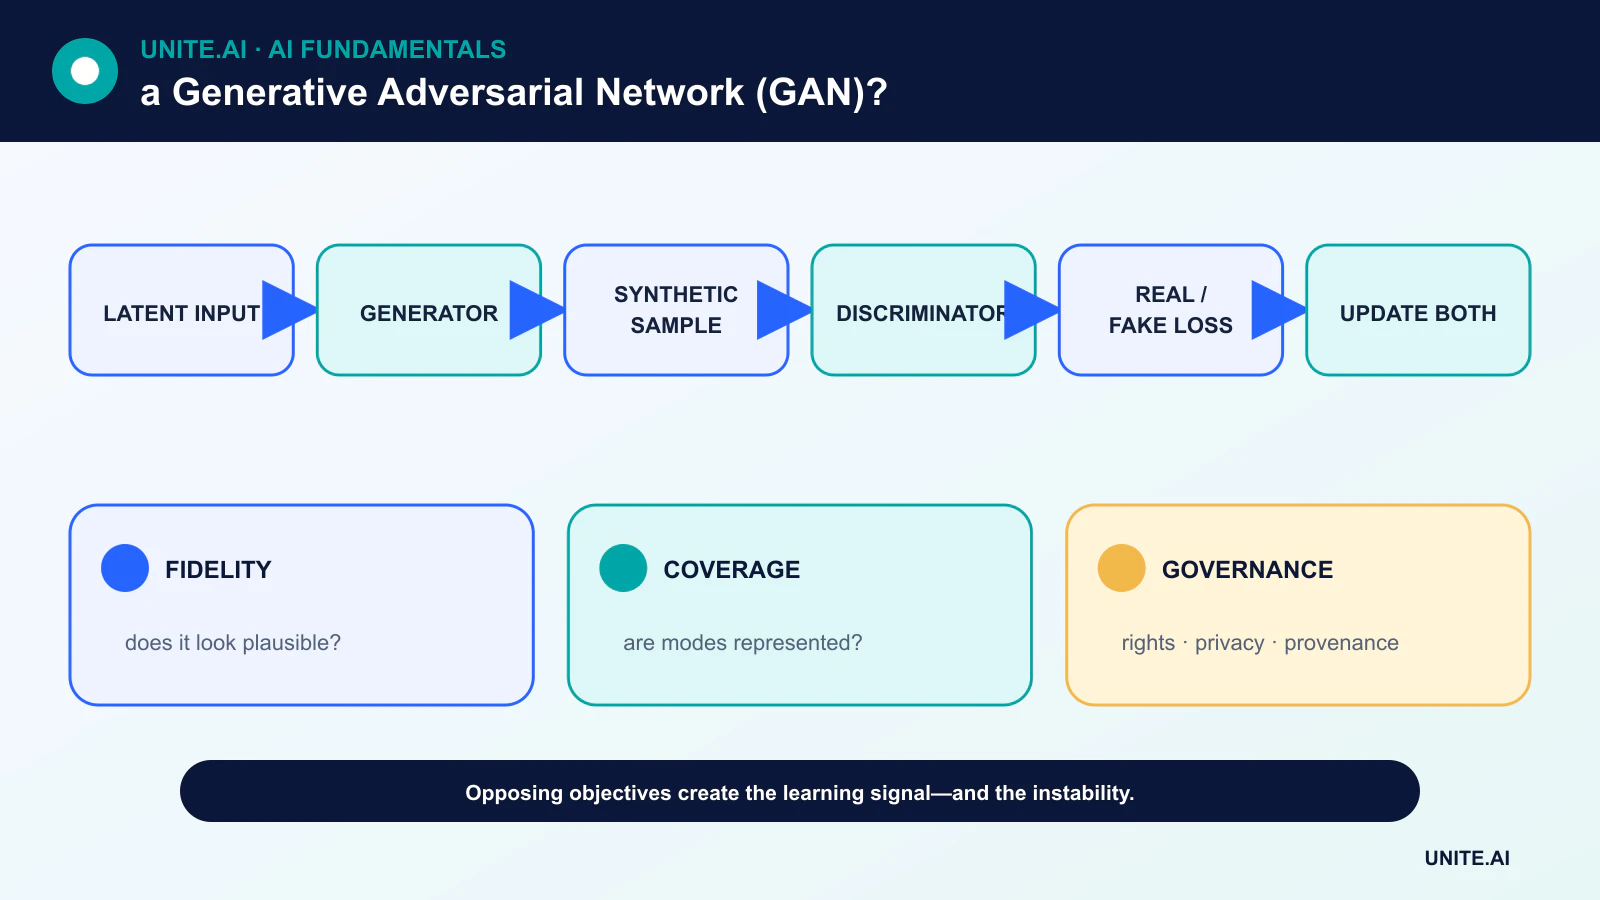
Ett generativt adversarialt nätverk (GAN) tränar två neurala nätverk i konkurrens. En generator omvandlar slumpmässig eller villkorad indata till syntetiska prover. En diskriminator försöker skilja genererade prover från verkliga träningsexempel. Feedbacken från varje nätverk förändrar det andra nätverkets inlärningsproblem.
GAN:er kan skapa skarpa bilder och styrbara syntetiska data, men adversarial träning är svår att stabilisera. Visuell realism är inte ett bevis på mångfald, faktuell giltighet eller tillstånd att använda träningsdata.
Viktiga slutsatser
- Generatorn producerar prover; diskriminatorn lär sig ett beslutssignal som skiljer verkligt från genererat.
- Träning söker ett jämviktstillstånd, men förändrade motståndare kan orsaka instabilitet, oscillation eller lägeskollaps.
- Villkorliga GAN:er styr genereringen med etiketter, text eller annan kontext.
- Utvärdering bör testa äkthet, täckning, memorering och nedströmsrisk – inte bara bildkvalitet.
Det adversariala spelet
Den ursprungliga formuleringen är ett tvåspelarminsimaxspel. Diskriminatorn förbättras i att separera verkliga data från genererade data, medan generatorn förbättras i att skapa prover som diskriminatorn klassificerar som verkliga. Båda tränas med backpropagation.
Om diskriminatorn blir för exakt kan dess återkoppling till generatorn vara obrukbar. Om den är för svag kan generatorn utnyttja enkla genvägar. Träningen växlar därför uppdateringar och balanserar noggrant kapacitet, förluster och optimeringsinställningar.
Modkollaps och träningsstabilitet
Modkollaps uppstår när många latenta indata ger liknande utdata, så proverna ser trovärdiga ut men täcker endast en del av datadistributionen. Andra fel inkluderar oscillation, exploderande gradienter och känslighet för slumpmässig initialisering.
Wasserstein‑mål, gradientstraff, spektral normalisering, arkitekturförändringar och justerade uppdateringsförhållanden kan förbättra stabiliteten. De eliminerar inte behovet av att granska mångfald och upprepa experiment med flera frön.
Villkorlig generering och latent kontroll
En villkorlig GAN ger generatorn och diskriminatorn en etikett eller annan kontext, vilket möjliggör målgruppsspecifika klasser eller attribut. Stilbaserade arkitekturer separerar aspekter av latent kontroll vid olika upplösningar och har producerat mycket realistiska bilder.
Latenta riktningar kan korrelera med mänskliga begrepp, men redigering av ett attribut kan förändra andra eftersom träningsdata innehåller korrelerade egenskaper. Påståenden om styrbarhet bör testas över olika identiteter och kontexter.
Utvärdering, integritet och proveniens
Mått som Fréchet Inception Distance jämför funktionsdistributioner, men de ärver antaganden från funktionsmodellen och kan missa memorering eller misslyckanden i undergrupper. Närmaste‑granne‑analys, precision/recall‑liknande täckningstester och mänsklig granskning ger kompletterande bevis.
En GAN kan memorera sällsynta exempel, reproducera bias eller generera vilseledande media. Team bör dokumentera dataset, rättigheter, filtrering, vattenmärkning eller proveniensmekanismer samt missbrukskontroller. Syntetiska data är inte automatiskt anonyma.
GAN:er, VAE:er och diffusionsmodeller
Variationsautoenkodare optimerar ett sannolikhetsbaserat latent mål och offrar ofta bildskärpa för ett strukturerat latent rum. Diffusionsmodeller lär sig att reversera en brusningsprocess och har blivit en vanlig grund för bildgenerering.
GAN:er förblir användbara när snabb engångssampling, specifika bild‑till‑bild‑mappningar eller kompakt distribution är viktiga. Den rätta metoden beror på kvalitet, mångfald, latens, träningsstabilitet och styrning – inte på vilken arkitektur som är nyast.
Adversariala mål och träningsdynamik
Ett generativt adversarialt nätverk tränar en generator att producera prover och en diskriminator att skilja genererade från verkliga data. I det ursprungliga minimax‑spelet uppskattar diskriminatorn en signal relaterad till täthetsförhållandet och generatorn försöker lura den. Träningen växlar uppdateringar, så varje nätverk lär sig mot en rörlig motståndare snarare än en fast förlust. Om diskriminatorn blir för stark kan generatorgradienterna bli obrukbara; om den är för svag stagnerar den genererade kvaliteten. Enbart förlustvärdet motsvarar inte direkt provkvaliteten.
Modkollaps uppstår när generatorn producerar begränsade variationer som lurar diskriminatorn. Oscillation, känslighet för hyperparametrar och instabil normalisering är också vanliga. Wasserstein‑mål, gradientstraff, spektral normalisering, funktionsmatchning, minibatch‑statistik och noggrant balanserade uppdateringsscheman adresserar olika felmekanismer. Villkorliga GAN:er använder etiketter, text eller bilder för att styra utdata; stilbaserade arkitekturer separerar latenta influenser. Datasetkvalitet och täckning förblir grundläggande eftersom generatorn reproducerar och kombinerar den distribution den ser.
Utvärdering och ansvarsfull användning
Utvärdera äkthet och mångfald separat. Fréchet Inception Distance jämför funktionsdistributioner men beror på provstorlek, funktionsmodell, förbehandling och domän; Inception Score utelämnar jämförelse med verkliga data. Precision och recall för generativa modeller, närmaste‑granne‑analys, memoreringstester och mänsklig uppgiftsevaluering ger ytterligare bevis. För vetenskaplig eller medicinsk syntes, använd domänspecifika mått och nedströmsvalidering. Behåll en avhållen verklig uppsättning och jämför med diffusions‑ eller autoregressiva baslinjer med motsvarande beräkningskraft och upplösning.
GAN:er kan förstärka data, översätta domäner, superupplösa bilder, syntetisera media och stödja simulering, men syntetiska data kan förstärka bias eller läcka träningsexempel. Verifiera licensiering, samtycke, identitet och proveniens. Skydda mot icke‑samtyckt personifiering och vilseledande användning, märk eller signera utdata där det är lämpligt och behåll genereringsmetadata. En fotorealistisk bild är inte dokumentär bevisning; osäkerhet och syntetiskt ursprung måste förbli synliga när utdata påverkar beslut.
Implementering och reproducerbarhet
Registrera generator, diskriminator, optimerare, dataset, slumpmässigt frö, trunkering och samplingsinställningar. Kvantisering eller export kan förändra normalisering och utdata, så validera den levererade artefakten. Övervaka prompt‑ eller villkorsdistribution, säkerhetsfilter, utdata‑mångfald, latens och rapporter. Använd hastighetsbegränsningar och identitetsskydd i offentliga system. GAN‑träning är ett kopplat optimeringsexperiment: utvalda exempelbilder kan inte fastställa robusthet, täckning eller avsaknad av memorering, och en modell bör utvärderas på hela distributionen av avsedda genereringsuppgifter.
Arbetsexempel: syntetiska defektbilder med en GAN
En tillverkare tränar en villkorlig GAN för att skapa sällsynta ytfelbilder. Den verifierar att träningsbilderna har rättigheter och separerar produktionslotter före träning och utvärdering. Genererade prover kontrolleras för närmaste‑granne‑memorering, felgeometri, bakgrundsartefakter, mångfald och expertplausibilitet. En klassificerare tränad med syntetisk förstärkning utvärderas endast på oberoende verkliga fel, jämfört med samma klassificerare med konventionell förstärkning.
Syntetiska data accepteras endast om återkallelse i verkligheten förbättras utan att öka falska avslag eller undergruppsfel. Genereringsinställningar och proveniens förblir bifogade till varje bild, och syntetiska filer hamnar aldrig i testsetet eller bevisarkivet som verkliga inspektioner. Operatörer kan inte använda generatorn för att fabricera revisionsposter. Teamet jämför diffusionsalternativ och kostnaden för att samla in fler verkliga exempel, och inser att ett realistiskt utseende inte bevisar att GAN:en fångade den fysiska felprocessen.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, distributionsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter utrullning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policys, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incidentlärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Förstår en GAN bilderna den skapar?
En GAN lär sig statistisk struktur som är användbar för generering. Det innebär inte i sig att den har mänsklig liknande semantisk eller kausal förståelse.
Är GAN‑genererade prover säkra att använda som träningsdata?
Endast efter att ha kontrollerat täckning, etikettens giltighet, memorering, bias och huruvida den syntetiska distributionen hjälper på ett verkligt avskilt testset.
Primära referenser












