
Grunderna i AI
Vad är KNN (K-Nearest Neighbors)?

 Lägg till Unite.AI bland dina föredragna källor på Google
K-nearest neighbors (KNN) förutsäger ett resultat från de märkta träningsexemplen som är närmast en frågepunkt. Vid klassificering röstar grannarna på klassen. Vid regression medelvärdesberäknas deras målvärden eller kombineras på annat sätt.
KNN är en instansbaserad, icke‑genererande metod: anpassning lagrar främst träningsexemplen och ett valfritt sökindex. Det eliminerar inte behovet av tränings-, validerings‑ och testuppdelningar. Utvärdering på håll‑ut‑data är avgörande för att välja k, avståndsmått, funktionsbearbetning och röstningsregel.
Viktiga slutsatser
- KNN förutsäger lokalt; den delar inte först datasetet i kluster.
- Funktionell skalning är kritisk eftersom avståndet avgör vilka exempel som räknas som grannar.
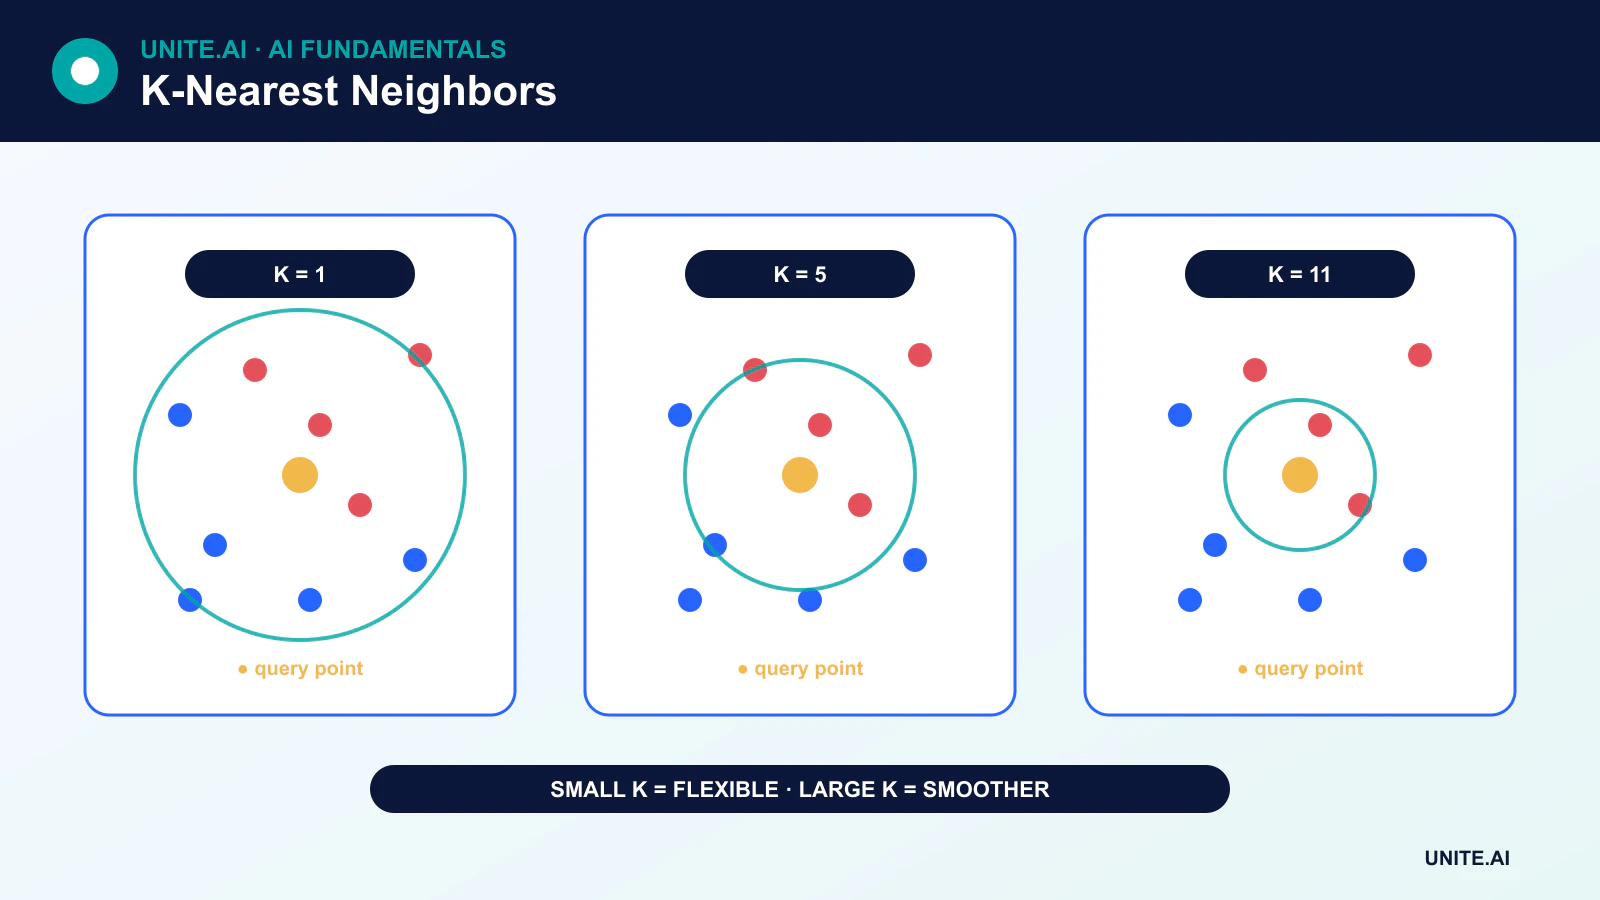
- Litet k kan vara bullrigt, medan stort k kan jämna ut lokal struktur.
- Höga dimensioner, irrelevanta funktioner, klassobalans och långsam sökning kan begränsa prestanda.
Hur KNN‑klassificering fungerar
- Representera frågan och träningsexemplen i samma funktionsrum.
- Beräkna avståndet från frågan till träningsexemplen.
- Välj de k närmaste exemplen.
- Förutsäg majoritetsklassen eller använd avståndsviktad röstning.
Avståndsviktad röstning ger närmare grannar mer inflytande. Oavgjorda resultat kräver en dokumenterad regel, och grannar med lika avstånd men olika etiketter kan göra att resultatet beror på sorteringsordning eller implementationsdetaljer.
KNN‑regression
Vid regression är förutsägelsen vanligtvis medelvärdet av de grannande målen. Avståndsviktning kan minska inflytandet från mer avlägsna observationer. Median eller robust aggregation kan vara användbart när lokala mål innehåller avvikande värden.
Avståndsmått
Euklidiskt avstånd är vanligt för kontinuerliga funktioner, Manhattan‑avstånd summerar absoluta skillnader och cosinusavstånd fokuserar på riktning snarare än magnitud. Andra mått gäller för binära, kategoriska, geografiska, sekvens‑ eller inlärda inbäddningsdata.
Att kalla KNN för ”icke‑parametrisk” betyder att den inte antar en fast, ändlig‑dimensionell funktionell form för beslutsgränsen. Den förutsätter ändå att den valda representationen och avståndsmåttet gör närliggande punkter relevanta för varandra.
Varför skalning är viktig
Om en funktion varierar från 0 till 1 och en annan från 0 till 100 000, kommer vanligt euklidiskt avstånd att domineras av den andra funktionen. Standardisering, normalisering eller domänspecifika transformationer bör anpassas på träningsdelen och tillämpas på validerings-, test‑ och produktionsdata.
Irrelevanta funktioner förvränger också grannskapen. Funktionsurval, dimensionsreduktion eller inlärda representationer kan hjälpa, men varje val måste valideras utan dataläckage.
Att välja k
Med k = 1 kan modellen följa brus och felmärkta exempel. När k ökar blir förutsägelserna mjukare och mindre känsliga för en enskild punkt. Om k blir för stort, dominerar avlägsna klasser eller regioner och modellen underanpassar.
Välj k genom korsvalidering på träningsdata. För binär klassificering minskar ett udda k antalet oavgjorda fall men eliminerar dem inte helt. Klassviktning, stratifierade uppdelningar, tröskelval och lämpliga mått är viktiga när klasserna är obalanserade.
Den förbannelse som hög dimensionell data innebär
I högdimensionella rum kan avstånden bli mindre informativa eftersom exemplen är glesa och närmaste och längst bortliggande avstånd blir relativt lika. KNN kan kräva enorma mängder data för att upprätthålla meningsfulla lokala grannskap. Detta är den förbannelse som hög dimensionell data innebär.
Dimensionsreduktion eller uppgiftsspecifika inbäddningar kan hjälpa, men en inbäddnings geometri bör valideras för den avsedda likhetsdefinitionen.
Sökprestanda
En brute‑force‑fråga jämför den nya punkten med varje lagrat exempel. KD‑träd och ball‑träd påskyndar vissa exakta sökningar, men deras fördelar minskar i hög dimension. Approximerade närmaste‑granne‑index byter en liten mängd återkallelse mot stora hastighets‑ och minnesvinster. Detta koncept ligger också till grund för vektorsimilaritetssökning.
Styrkor och begränsningar
KNN är enkel, stödjer oregelbundna beslutsgränser och ger en intuitiv exempelbaserad förklaring. Den kan också kräva betydande minne, exponera känsliga träningsexempel, förutsäga långsamt och fungera dåligt när avstånd inte är meningsfullt. Den är en användbar baslinje – inte en metod som per automatik är mycket exakt på de flesta problem.
Avstånd, grannskap och hyperparameterbeteende
K‑nearest neighbors lagrar träningsexempel och förutsäger från de k närmaste enligt ett valt avstånd. Klassificering använder en majoritets‑ eller avståndsviktad röst; regression medelvärdesberäknar grannmålen. Skalning är avgörande eftersom en funktion med stort värdeintervall kan dominera euklidiskt avstånd. Kategorisk, gles, sekvens‑ eller geografisk data kan kräva Hamming, cosinus, redigerings-, storcirkelform eller inlärda avstånd. Måttet är ett modelleringsantagande om likhet och bör valideras mot den faktiska betydelsen av närliggande fall.
Litet k skapar flexibla, högvariansgränser och känslighet för brus; stort k jämnar ut förutsägelser och kan radera minoritetsstruktur. Udda k undviker bara vissa binära oavgjorda fall och är ingen generell regel. Välj k, avstånd, viktning, funktionsuppsättning och förbehandling inom korsvalidering. Klassobalans kan göra att lokala majoritetsröster ignorerar sällsynta utfall, så inspektera återkallelse per klass och grannskapsammansättning. Högdimensionella avstånd tenderar att koncentrera sig, och irrelevanta funktioner försämrar grannskap; urval, dimensionsreduktion eller inlärda inbäddningar kan hjälpa.
Indexering, osäkerhet och produktionsdrift
Naiv inferens jämför en fråga med varje träningspunkt. KD‑träd och ball‑träd hjälper i lämpliga låga dimensioner; approximativa närmaste‑granne‑index byter exakthet mot hastighet och skala. Mät återkallelse av grannsökningen separat från den prediktiva kvaliteten. Minne inkluderar lagrade funktioner, etiketter och indexstrukturer. Uppdateringar är konceptuellt enkla men kan kräva indexåteruppbyggnad, versionskonsekvens och borttagningsspridning. Skydda känsliga träningsexempel eftersom återgivning av grannar eller avstånd kan exponera poster.
KNN kan visa exempel som gör en förutsägelse begriplig, men närhet är inte orsakssamband eller rättvisa. Tillhandahåll avstånd, röstmarginal och en avståenderegler när grannskap är glesa eller motstridiga. Övervaka frågeavstånd, grannetiketter, funktionsdrift, latens och bekräftade resultat. Håll förbehandling och indexversioner synkroniserade och testa exakta mot approximativa resultat efter förändringar. KNN är en effektiv lokal baslinje och återhämtningsmetod när avståndet är meningsfullt; den har svårigheter när likhet inte kan representeras av de tillgängliga funktionerna.
Arbetsexempel: KNN för produktsubstitution
En återförsäljare representerar produkter med standardiserade numeriska attribut, kategorisk kompatibilitet och en inlärd textinbäddning, och definierar sedan ett viktat avstånd som granskas av varuexperter. K och vikter väljs med hjälp av senare produktlanseringar, inte slumpmässiga artiklarader. Utvärderingen kontrollerar relevant substitutåterkallelse, inkompatibla rekommendationer, avstånd, kategoritäckning och resultat för sällsynta artiklar. En popularitetsbaslinje visar om lokal likhet tillför värde.
Ett approximativt index benchmarkas mot exakta grannar för återkallelse och latens. Frågor utan nära kompatibel artikel returnerar inget förslag snarare än en påtvingad granne. Produktborttagningar och attributkorrigeringar sprids till indexet via versionsuppdateringar. Övervakning spårar avståndsfördelningar, tomma resultat, överskrivningar och kommersiella utfall utan att förväxla försäljning med sann kompatibilitet. Känsliga leverantörsvillkor utesluts från förklaringar, och returnerade exempel förblir bevis på likhet – inte ett påstående att produkter är ekvivalenta.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionsstyrd utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgångsmekanism och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indatakvalitet, utdatabeteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för respons, och granska verkliga bevis efter utrullning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policys, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incident‑lärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Har KNN en träningsfas?
Den har liten parameteranpassning, men den har ändå en utvecklingsprocess: förbehandling lärs från träningsdata, ett index kan byggas, och k, mått, vikter och funktioner väljs med validering.
Är KNN samma som K-means?
Nej. KNN är främst en övervakad lokal‑förutsägelsemetod. K-means är en oövervakad klustringsalgoritm där K är antalet klustercentra.
Primära referenser












