
Grunderna i AI
Vad är dimensionsreduktion?

 Lägg till Unite.AI bland dina föredragna källor på Google
Dimensionsreduktion representerar data med färre variabler samtidigt som den bevarar information som är användbar för en uppgift. Den kan minska lagring och brus, förbättra visualisering, mildra redundanta funktioner och göra efterföljande modeller enklare att träna.
Ingen metod bevarar varje relation. En användbar reduktion börjar med att ange vad som bör överleva: varians, klassseparation, lokala grannskap, global geometri, återkonstrueringskvalitet eller tolkbarhet.
Viktiga slutsatser
- Variabelurval behåller de ursprungliga variablerna; funktionsutvinning skapar nya lägre-dimensionella koordinater.
- PCA är linjär och variansorienterad; t-SNE och UMAP betonar grannskapsstruktur för visualisering.
- Visualiseringsinbäddningar kan förvränga avstånd, klusterstorlekar och global separation.
- Anpassa reduktionen endast på träningsdata och tillämpa sedan den inlärda transformen på validerings- och testdata.
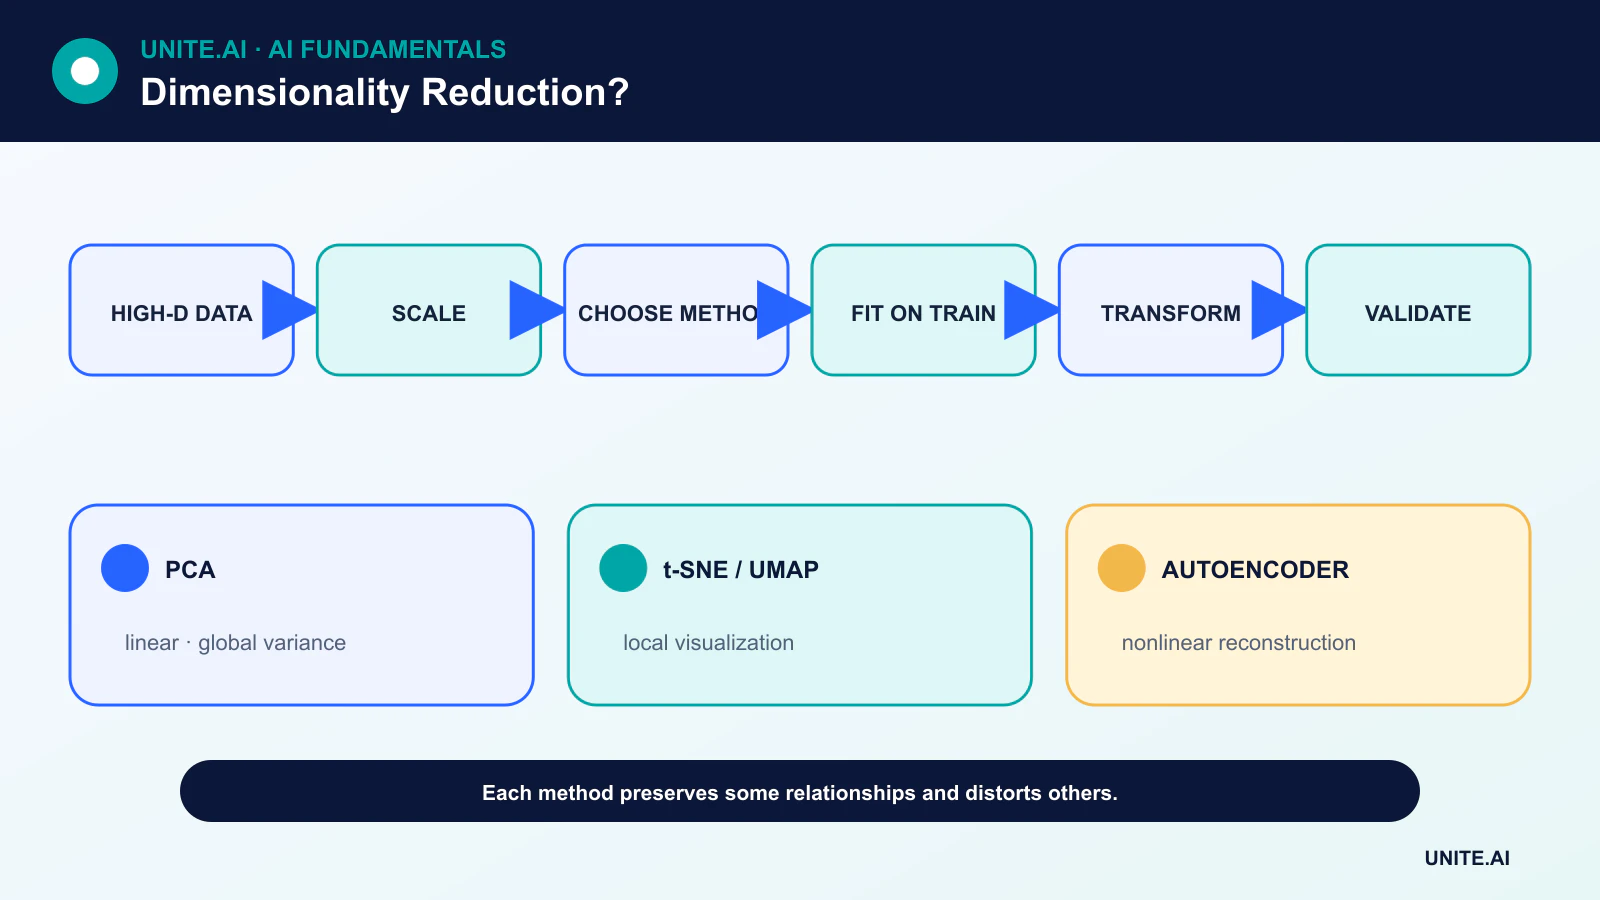
Variabelurval kontra projektion
Variabelurval tar bort variabler med hjälp av domänregler, saknad data, redundans, prediktiva tester eller regularisering. Det bevarar de ursprungliga betydelserna, vilket kan underlätta styrning och förklaring.
Projektioner kombinerar variabler till nya koordinater. De kan fånga distribuerad struktur men kan göra varje koordinat svårare att tolka. En autoencoder lär sig en icke‑linjär projektion genom återuppbyggnad.
PCA och SVD
Principal component analysis identifierar ortogonala riktningar med minskande varians efter att data har centrerats. Singular value decomposition ger en vanlig numerisk metod. Skalning är viktig: en mätenhet med hög varians kan dominera komponenterna.
PCA är deterministisk upp till tecken och upprepade egenvärden, stödjer transformation av nya observationer och ger sammanfattningar av förklarad varians. Hög varians är inte alltid uppgiftsrelevant, och linjära komponenter kan inte veckla ut varje krökt mångfalt.
t-SNE och UMAP
t-SNE konstruerar sannolikhetsfördelningar över grannar och optimerar en lågdimensionell karta som betonar lokal likhet. UMAP bygger en viktad grannskapsgraf och optimerar en lägre‑dimensionell representation med relaterade mål för lokal struktur.
Båda är kraftfulla utforskande verktyg men är känsliga för förbehandling, avståndsmått och hyperparametrar. Tomt utrymme, klusterarea och avstånd mellan kluster i en 2D‑plot bör inte automatiskt tolkas som verkliga värden.
Övervakade metoder och uppgiftsmedvetna representationer
Linear discriminant analysis använder klassetiketter för att söka separation, vilket skiljer den från den osupervised PCA. Neural representation learning kan optimera prediktions‑ eller kontrastiva mål istället för återuppbyggnad.
Om etiketter styr reduktionen måste all anpassning och justering ske inom träningsprocessen. Annars kan information från testsetet läcka in i modellvalet och skapa ett optimistiskt resultat.
Att välja och validera en metod
Börja med förbehandling och en enkel baslinje. För komprimering, mät återuppbyggnad eller efterföljande prestanda över dimensioner. För visualisering, testa stabilitet över slumptalsfrön och hyperparametrar samt jämför bevarande av grannskap med domänkunskap.
För produktion, fråga om metoden kan transformera nya poster, hur den hanterar saknade värden, om den förändras vid omträning och om användare behöver förklaringar av ursprungsvariabler. Overfitting kan inträffa i reduktionssteget precis som i den slutliga modellen.
Linjär och icke‑linjär reduktionsmetoder
Dimensionsreduktion kartlägger högdimensionell data till färre koordinater samtidigt som den bevarar vald struktur. Principal component analysis hittar ortogonala riktningar med maximal varians efter centrering; skalning behövs när enheter ska bidra jämförbart. Singular value decomposition beräknar relaterad låg‑rank‑struktur och stödjer glesa matriser. Linear discriminant analysis använder etiketter för att finna klassseparerande riktningar. Dessa metoder ger explicita transformationer, men varians eller klassseparation bevarar inte alltid den information som krävs för en efterföljande uppgift.
Manifold‑metoder såsom t‑SNE och UMAP konstruerar grannskap och optimerar en lågdimensionell layout. De är kraftfulla för utforskning men förvränger globala avstånd, densitet, klusterstorlek och ibland separation. Resultaten beror på förbehandling, mått, grannar eller perplexity, initiering och frö. Ett attraktivt kluster i två dimensioner kan uppstå även utan diskreta grupper. Använd flera inställningar, färgmarkera endast efter metadata som inte använts i anpassning, och validera skenbar struktur i originalrummet eller med oberoende etiketter.
Variabelurval, inbäddningar och utvärdering
Variabelurval behåller ursprungliga variabler genom filter, wrappers eller modellbaserad betydelse; representation learning skapar nya latenta funktioner med autoencoders eller övervakade modeller. Slumpmässiga projektioner bevarar avstånd approximativt under vissa villkor och erbjuder effektiva baslinjer. Välj metod baserat på komprimering, visualisering, brusreducering, hastighet, lagring eller modellprestanda. Anpassa reduktorn endast på träningsdata, transformera sedan validerings‑ och testset. Övervakad reduktion måste vara inbäddad i korsvalidering för att undvika läckage av etiketter.
Utvärdera förklarad varians eller återuppbyggnad för linjär komprimering, tillförlitlighet och bevarande av grannskap för visualisering, samt efterföljande noggrannhet, kalibrering, latens och robusthet för prediktion. Mät stabilitet över prover och frön. Kontrollera om sällsynta klasser eller känsliga grupper har kollapsat och om omvänd mappning är möjlig. Reducerade koordinater kan fortfarande innehålla privat information; en tvådimensionell plot är ingen anonymisering. Dokumentera transform, skalare, funktionsordning och begränsningar.
Produktionsanvändning
Drift kräver exakt anpassad transform och inmatningsschema. Övervaka saknade funktioner, skift i intervall, fördelning av komponentpoäng, återuppbyggnadsfel och efterföljande resultat. Om nya kategorier eller sensorer dyker upp, omträn och versionera hela pipeline‑kedjan i stället för att tyst lägga till kolumner. Reduktion kan förbättra beräkning och avbrusa en modell, men kan också kassera svaga signaler som är viktiga för sällsynta händelser. Behandla den som ett inlärt mätningssteg vars behållna och förlorade information måste testas mot beslutet.
Arbetsexempel: reducera kundbeteende‑funktioner
En analytiker standardiserar 200 beteendemått och anpassar PCA enbart på träningskunder. Korsvalidering väljer antalet komponenter efter efterföljande churn‑prestanda och stabilitet, inte en tvådimensionell spridningsplot. Laddningar granskas för dominerade källor och saknad data. PCA, variabelurval, slumpmässig projektion och en o‑reducerad regulariserad modell jämförs på kalibrering, latens och resultat för sällsynta kundsegment. Upprepade prover testar även om de ledande komponenterna och efterföljande slutsatser förblir stabila.
Den distribuerade pipeline‑kedjan fixerar funktionsordning, skalare och komponenter samt avvisar saknade schemaversioner. Övervakning spårar komponentfördelningar, återuppbyggnadsfel och efterföljande resultat. En visualisering med skenbara kluster används för att generera frågor, inte för att tilldela kundpersonas. Eftersom latenta komponenter fortfarande kodar beteende förblir åtkomst och retention kontrollerade. Om källdefinitioner förändras byggs hela transformen och modellen om och valideras i stället för att projicera inkompatibel data i gamla komponenter.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, in‑ och utdata, beroenden, ägare och konsekvens av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset före finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för utgivning, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödiga känsliga data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning i stället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver även dokumenterade återställnings‑, incident‑inlärnings‑, raderings‑ och bevarandeförfaranden samt en tydlig punkt då det bör inaktiveras eller ersättas.
Vanliga frågor
Förbättrar dimensionsreduktion alltid en modell?
Nej. Den kan kassera förutsägande information eller komplicera tolkning. Jämför med en baslinje utan reduktion på håll‑out‑data.
Visar separerade t‑SNE‑kluster att verkliga klasser existerar?
Nej. Kartan är en optimerad visualisering av grannskapsrelationer och kan skapa en skenbar separation. Validera kluster med oberoende bevis.
Primära referenser












