
Grunderna i AI
Vad är Ensemble Learning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Ensemble learning kombinerar förutsägelser från flera modeller. Den centrala idén är att modeller med olika fel kan ge ett mer exakt eller stabilt resultat när deras utdata medelvärdesberäknas, röstas eller skickas till en meta‑inlärare.
Att bara lägga till modeller räcker inte. Om varje medlem lärde sig samma genväg blir deras fel korrelerade och ensemblen kan bara bli säkrare på samma misstag.
Viktiga slutsatser
- Ensembler fungerar bäst när medlemsmodellerna är individuellt användbara och gör meningsfullt olika fel.
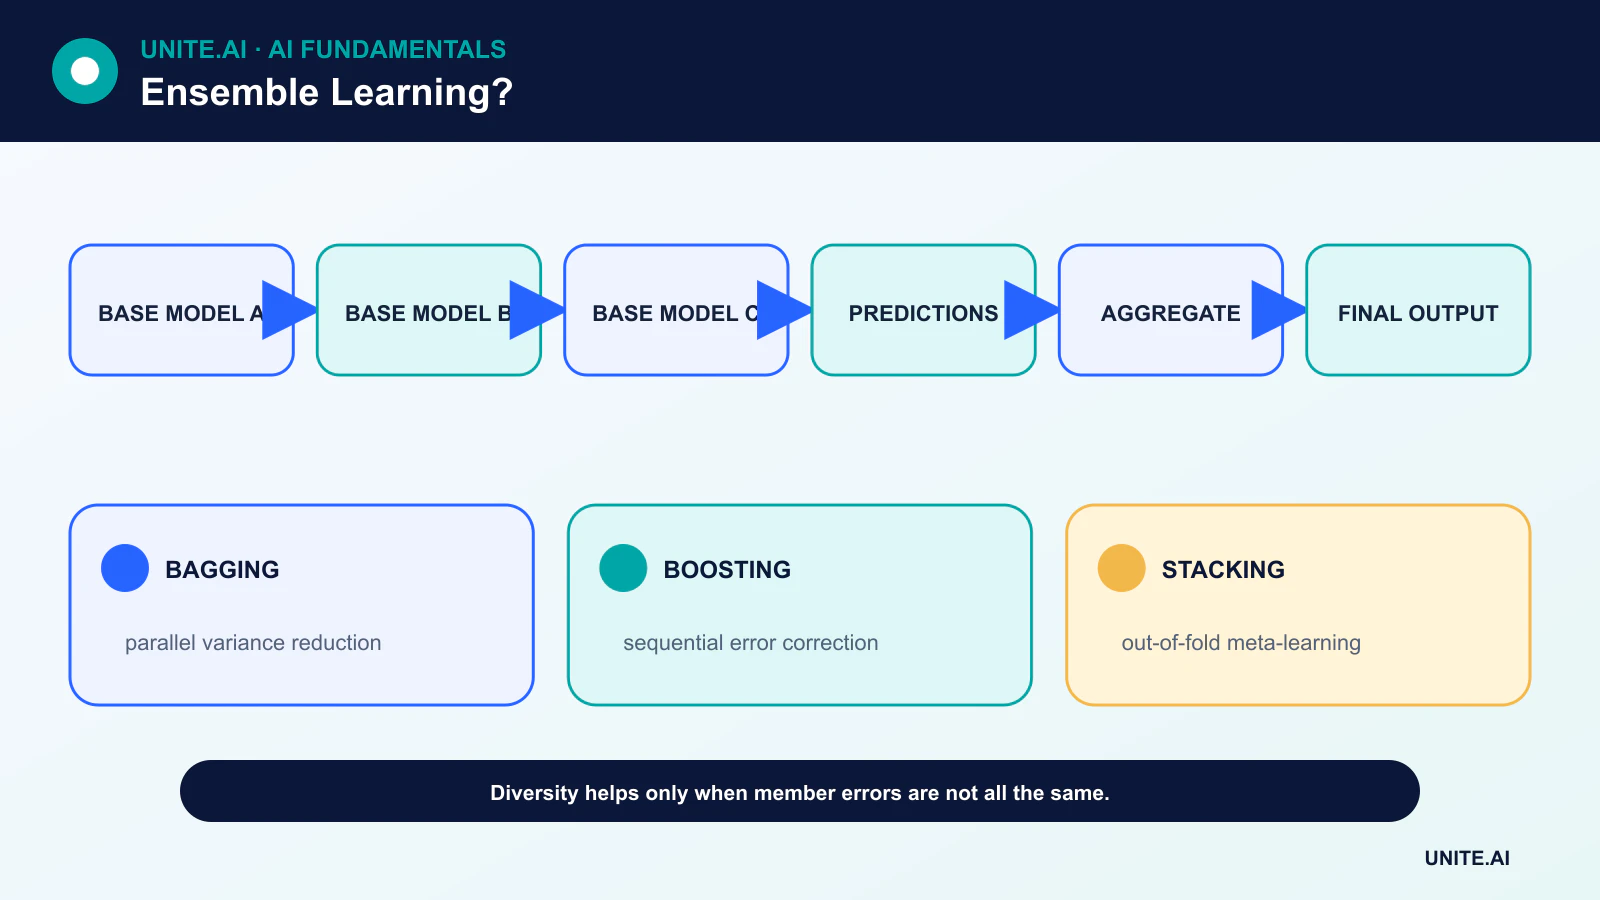
- Bagging tränar medlemmarna parallellt på omprovade data; boosting tränar inlärare sekventiellt för att korrigera fel.
- Stacking tränar en meta‑modell på out‑of‑fold‑förutsägelser, inte på in‑sample‑förutsägelser.
- Vinster i noggrannhet måste vägas mot latens, kalibrering, tolkbarhet och underhållskostnad.
Röstning och medelvärde
Hård röstning väljer den klass med flest röster. Mjuk röstning medelvärdesberäknar klass‑sannolikheter, vanligtvis efter kalibrering. Regressionsensembler medelvärdesberäknar ofta numeriska förutsägelser. Viktade versioner ger mer inflytande till starkare medlemmar.
Ett medelvärde kan minska variansen när fel inte är helt korrelerade. Det kan inte reparera en gemensam datadefekt, felaktig etikett eller saknad delgrupp. Mångfald bör mätas genom oenighet och felöverlapp, inte antas baserat på olika modellnamn.
Bagging och slumpmässiga skogar
Bootstrap‑aggregating tränar modeller på omprovade dataset och medelvärdesberäknar dem. Ett decision tree har hög varians, vilket gör det till ett naturligt kandidat för bagging.
Random forests lägger till slumpmässigt urval av funktioner vid delningar, vilket minskar korrelationen mellan träd. Out‑of‑bag‑exempel kan uppskatta prestanda, men ett slutgiltigt orört testset är fortfarande värdefullt för modellval och påståenden om driftsättning.
Boosting
Boosting bygger en additiv modell i steg. Senare inlärare fokuserar på exempel eller residualmönster som den nuvarande ensemblen hanterar dåligt. AdaBoost ändrar exempelviktningar; gradient boosting anpassar inlärare till negativa gradienter av en vald förlust.
Boostade träd kan modellera komplexa tabellära relationer, men djupa träd, för många iterationer och läckage kan fortfarande leda till överanpassning. Inlärningshastighet, träd‑djup, delprovtagning och tidig stoppning är viktiga styrparametrar.
Stacking och blending
Stacking skapar en modell på andra nivån som lär sig hur man kombinerar basförutsägelser. För att undvika läckage måste varje träningsrad för meta‑modellen komma från ett basmodell som inte tränades på den raden. Korskontroll genererar dessa out‑of‑fold‑förutsägelser.
Blending använder ett separat holdout‑set för meta‑modellen, vilket är enklare men minskar den data som finns tillgänglig för träning. Båda metoderna kräver samma förbehandling och versionskontroll vid inferens.
Operativa avvägningar
En ensemble kan multiplicera minne, beräkning och felmodeller. Den kan vara svårare att förklara, kalibrera och uppdatera konsekvent. Destillation kan komprimera en ensemble till en mindre modell, men eleven måste utvärderas oberoende.
Ett praktiskt urval jämför prestanda, svans‑latens, kalibrering, resursanvändning och felkostnad. Ibland är en väl‑regulariserad modell att föredra framför en liten noggrannhetsökning från en skör stack.
Varför ensembler fungerar
Ensemble‑lärande kombinerar flera modeller så att deras fel delvis tar ut varandra eller deras styrkor täcker olika områden. Bagging tränar modeller på omprovade data och medelvärdesberäknar förutsägelser, vilket minskar varians; random forests lägger till slumpmässigt urval av funktioner för att avkorrugera träd. Boosting tränar inlärare sekventiellt för att fokusera på residualfel, vilket ofta minskar bias men ökar känsligheten för brus och finjustering. Stacking tränar en meta‑modell på bas‑modellförutsägelser. Mångfald måste vara användbar: att medelvärdesberäkna identiska modeller ger kostnad utan mycket felreduktion.
Korrelationen mellan fel avgör fördelen. Mångfald kan komma från datasampling, funktioner, algoritmer, hyperparametrar, slumpmässig initiering eller tidsfönster. Hård röstning förkastar förtroende; mjuk röstning medelvärdesberäknar sannolikheter men kräver kompatibel kalibrering. Regression kan medelvärdesberäkna eller använda robust aggregation. Vid stacking är out‑of‑fold‑förutsägelser avgörande – att träna meta‑modellen på bas‑förutsägelser från samma anpassade data orsakar läckage. Behåll en enkel medelvärdesbaslinje innan du antar en komplex kombinerare.
Utvärdering, kalibrering och osäkerhet
Jämför varje medlem och ensemblen på ett håll‑out‑set med identisk förbehandling. Rapportera uppgiftsmått, kalibrering, delgruppsfel, varians över folds eller frön, och resurskostnad. En ensemble kan förbättra genomsnittskvaliteten samtidigt som den döljer ett gemensamt blind spot som orsakas av gemensamma data eller etiketter. Inspektera oenighet: den kan identifiera osäkerhet, men korrelerade, säkert felaktiga modeller kan hålla med. Kalibrera den slutgiltiga ensemblen, inte bara medlemmarna, och validera avståendetrösklar mot granskningskapacitet och konsekvenser.
Out‑of‑bag‑estimat är användbara för baggade modeller men ersätter inte ett slutgiltigt, driftsrepresentativt test. För tidsberoende data, undvik omprovning som bryter ordningen. För säkerhetskritiska tillämpningar, testa medlemsfel, föråldrade modeller och adversariell indata. Viktade ensembler kan överanpassa valideringsdata när många kandidater provas. Dokumentera kandidatval och använd nästlad validering när finjustering är omfattande.
Drift och underhåll
Ensembler multiplicerar minne, latens, energi och operativa beroenden. Destillation kan komprimera det kombinerade beteendet till en modell, med ett nytt valideringskrav. Versionshantera medlemmar, förbehandling, vikter och routing som en artefakt; definiera beteende när en medlem tidsöverskrider eller ger ett ogiltigt resultat. Övervaka medlemsförutsägelser och oenighet så att tyst fel blir synligt. Avveckla redundanta medlemmar och återtränna medvetet. Ensembler förbättrar förutsägelsen när felmångfald är verklig, men de förvandlar inte partisk träningsdata eller ett ogiltigt mål till pålitlig evidens.
Arbetsexempel: en ensemble för allvarliga vädervarningar
Ett prognoslag kombinerar ett fysiskt modell‑featureset, gradient‑boostat träd, neuralt sekvens‑modell och en kalibrerad statistisk baslinje. Out‑of‑fold‑förutsägelser tränar en enkel meta‑modell, och utvärderingen använder framtida stormar som helt uteslutits från medlems‑träning. Mått inkluderar händelse‑återkallelse, falsklarm, ledtid, kalibrering, geografisk prestanda och tillförlitlighet under sällsynta extrema förhållanden. Medlemsfelkorrelation undersöks eftersom delad indata kan skapa gemensamma blind spots.
Driften behåller varje förutsägelse och det kombinerade resultatet. Om en medlem är otillgänglig använder systemet en förvaliderad degraderad konfiguration istället för att tyst renormalisera. Oenighet utlöser ytterligare granskning men betraktas inte som osäkerhet i alla fall. Övervakning spårar medlemsdrift, latens och stormutfall, med vikter som endast uppdateras genom kontrollerad validering. Offentliga varningar förblir under auktoriserade meteorologiska beslutsprocesser; ensemblen förbättrar evidens men omdefinierar inte automatiskt varningspolicyn.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, in‑ och utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja evidens från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och avveckling. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regel‑version, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödig känslig data. Definiera varnings‑trösklar och en ansvarig för svar, och granska verklig evidens efter driftsättning istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver även dokumenterade återhämtnings‑, incident‑lärande‑, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är en random forest en ensemble?
Ja. Den kombinerar många slumpmässiga beslutsträd, vanligtvis genom röstning eller medelvärdesberäkning.
Kan identiska modeller bilda en användbar ensemble?
De kan göra det om träningsdata, initiering eller sampling skapar tillräckligt olika fel, men enbart duplicering ger ingen fördel.
Primära referenser












