Grunderna i AI
Vad är linjär regression?

 Lägg till Unite.AI bland dina föredragna källor på Google
Linear regression modellerar ett kontinuerligt mål som en linjär kombination av en eller flera ingångsegenskaper. Det används för prediktion, uppskattning och som en transparent baslinje för att förstå om en mer komplicerad modell tillför meningsfullt värde.
Orden oberoende variabel och beroende variabel beskriver roller i modellen, inte bevisad orsak och verkan. En regression kan identifiera ett samband medan förväxlingsfaktorer, urvalsbias, omvänd kausalitet eller mätningsfel förklarar relationen.
Viktiga slutsatser
- Målet y modelleras från ingångsegenskaperna X; artikelns äldre version vände dessa etiketter i en formelförklaring.
- Vanlig minsta kvadrater minimerar summan av kvadrerade residualer.
- Residualdiagnostik och antaganden är viktiga för inferens och osäkerhet.
- Ridge- och lasso‑regularisering hjälper när prediktorer är många eller korrelerade.
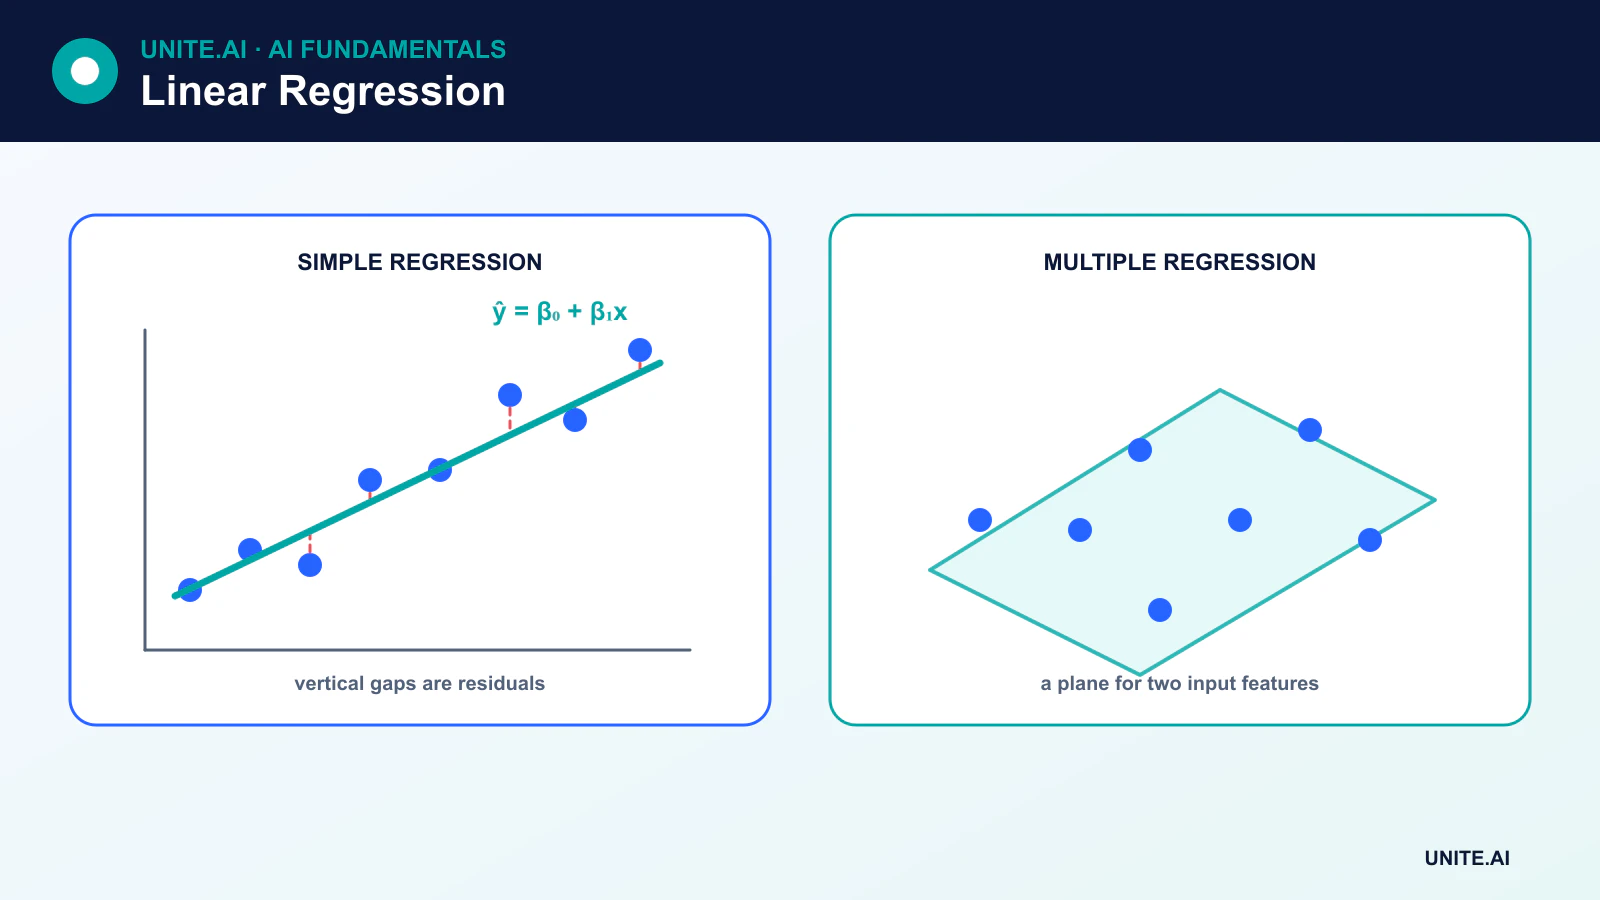
Enkel linjär regression
Med en egenskap är modellen:
ŷ = β₀ + β₁x
β₀ är interceptet och β₁ är lutningen. Residualen för observation i är yᵢ - ŷᵢ. Vanliga minsta kvadrater (OLS) väljer koefficienter som minimerar summan av kvadrerade residualer.
Lutningen uppskattar den förväntade förändringen i målet som är förknippad med en enhetsförändring i egenskapen under den anpassade modellen. Den bör inte beskrivas som en kausal effekt såvida inte studiedesignen och antagandena stödjer kausal identifiering.
Multipel linjär regression
Med p egenskaper:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Varje koefficient tolkas villkorat på de andra inkluderade egenskaperna. Multipel regression kan införliva kategoriska variabler genom kodning, polynomtermer och interaktioner. Den förblir “linjär” eftersom den är linjär i koefficienterna, även om transformerade egenskaper såsom x² inkluderas.
Antaganden och diagnostik
För prediktion är huvudfrågan hur väl modellen generaliserar. För klassiska koefficienttester och intervall blir ytterligare antaganden viktiga:
- Linjäritet: det villkorliga medelvärdet representeras av den valda linjära formen.
- Oberoende eller korrekt modellerade fel: upprepade, grupperade, rumsliga eller tidsserieobservationer kan kräva en annan felstruktur.
- Konstant felvarians: heteroskedasticitet påverkar standardfel och osäkerhetsuppskattningar.
- Begränsad multikollinearitet: starkt korrelerade prediktorer gör enskilda koefficienter instabila.
- Residualfördelning: normalitet är relevant för viss inferens med små urval, men det är inte ett krav att varje egenskap är normalfördelad.
Residualdiagram, leverage‑ och inflytelsemått samt domängranskning kan identifiera avvikare, icke‑linjäritet, förändrad varians eller observationer som dominerar anpassningen.
Utvärdera prediktioner
- Medelabsolutfel (MAE) medelvärdesberäknar den absoluta residualstorleken.
- Medelkvadratfel (MSE) ger större fel mer vikt.
- Rotmedelkvadratfel (RMSE) återför kvadrerade fel till målens enheter.
- R² jämför residualvariation med en konstant baslinje på de utvärderade data.
R² är inte ett mått på noggrannhet, fastställer ingen kausalitet och kan bli negativt på håll‑ut‑data. Validering bör motsvara den verkliga prediktionssituationen, inklusive tids‑ eller gruppmedvetna uppdelningar när så behövs.
Ridge, lasso och elastic net
Ridge‑regression lägger till en L2‑straffterm som krymper koefficienterna och stabiliserar korrelerade prediktorer. Lasso lägger till en L1‑straffterm och kan sätta koefficienter till noll. Elastic net kombinerar båda. Egenskaper bör vanligtvis skalas kompatibelt innan dessa straff jämförs.
Regularisering inför bias i utbyte mot lägre varians och kan minska överanpassning. Straffstyrkan väljs med validering, inte med det slutgiltiga testsetet.
När linjär regression är fel verktyg
En linjär modell kan misslyckas när samband är starkt icke‑linjära, fel beror på tidigare värden, målfördelningar kräver specialiserad modellering, eller några få avvikare dominerar kvadratförlusten. Beslutsträd, generaliserade linjära modeller, tidsseriemodeller, robust regression eller icke‑linjära metoder kan passa bättre.
Även när en komplex modell vinner förblir linjär regression en värdefull baslinje. Om ett stort system inte konsekvent kan överträffa den, kan den extra komplexiteten vara ogrundad.
Modellantaganden, uppskattning och diagnostik
Linjär regression modellerar det villkorliga medelvärdet av ett numeriskt utfall som ett intercept plus vikta prediktorer. Vanliga minsta kvadrater väljer koefficienter som minimerar kvadrerade residualer. Koefficienterna beskriver den förväntade förändringen i utfallet för en enhetsförändring i prediktorn medan övriga inkluderade variabler hålls konstant, enligt den specificerade modellen. Detta är ett samband såvida inte antaganden om kausal identifiering och studiedesign motiverar mer. Enheter, kodning, transformationer, interaktioner och referenskategorier bestämmer tolkningen, så koefficienter utan en datadictionary är ofullständiga.
Klassisk inferens bygger på antaganden om funktionsform, oberoende fel, konstant varians och felfördelning för specifika tester och intervall. Residual‑mot‑anpassade diagram avslöjar icke‑linjäritet eller heteroskedasticitet; Q–Q‑diagram bedömer svansbeteende; leverage‑ och inflytelse‑diagnostik identifierar observationer som starkt påverkar uppskattningarna. Korrelerade prediktorer ökar osäkerheten och gör enskilda koefficienter instabila även när prediktionerna är tillräckliga. Robust standardfel, transformationer, splines, hierarkisk struktur eller en annan modell kan behövas i stället för att radera besvärliga datapunkter.
Regularisering, utvärdering och ansvarsfull användning
Ridge‑regression krymper koefficienter med ett L2‑straff, medan lasso kan sätta vissa till noll med ett L1‑straff; elastic net kombinerar dem. Standardisera prediktorer när straffskalan bör vara jämförbar och välj styrkan med validering eller korsvalidering. Utvärdera medelabsolutfel, rotmedelkvadratfel, residualfördelning, kalibrering över intervall och osäkerhet, med tids‑ eller gruppuppdelningar som speglar användningen. Jämför med en medelbaslinje och icke‑linjära alternativ, men behåll linjära modeller när transparens och stabilitet är värdefulla.
Extrapolering bortom det observerade prediktorranget följer den anpassade linjen utan bevis och kan vara farlig. Övervaka egenskapsintervall, saknade värden, residualer och subgruppsfel i produktion. Prediktionsintervall beskriver osäkerhet för individuella utfall och är bredare än konfidensintervall för medelvärdet; båda kräver antaganden. Undvik att kontrollera för variabler som inför kausalt bias när målet är effektuppskattning. Linjär regression är ett exakt verktyg för ett definierat samband, inte en universell garanti för att världen är linjär eller att en koefficient representerar en intervention.
Arbetsexempel: uppskattning av leveranstid
Ett logistikteam modellerar leveranstid från avstånd, servicenivå, region, veckodag och känt väder. De granskar icke‑linjära residualmönster och lägger till motiverade splines och interaktioner snarare än att behandla en linjär ekvation som bokstavlig fysik. Transportör‑ och ruttgrupper definierar valideringsdelar. Medelabsolutfel, svansfel, intervalltäckning och systematiskt bias rapporteras. Avbrutna leveranser och data som registrerats efter ankomst exkluderas eller modelleras explicit.
Koefficienterna dokumenteras i enheter och kontrolleras för instabilitet under korrelerade prediktorer. Modellen avvisar extrapolering utanför validerade avstånds‑ och regionsintervall. Prediktionsintervall följer med uppskattningarna, och efterföljande schemaläggning använder deras osäkerhet. Övervakning spårar egenskapsintervall, residualer, intervalltäckning och bias efter nätverksförändringar. Ett kausalt påstående om transportör eller väder görs inte utifrån prediktiva koefficienter; operativa experiment eller starkare identifiering skulle krävas för att stödja en intervention.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter implementering i stället för att anta att offline‑prestanda kvarstår. Utvärdera på nytt när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver även dokumenterad återställning, incident‑lärande, raderings‑ och bevarandeprocesser samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Kräver linjär regression bara en ingångsvariabel?
Nej. Enkel regression har en prediktor, medan multipel linjär regression kan använda många numeriska, kodade kategoriska, transformerade och interaktions‑egenskaper.
Kan linjär regression bevisa kausalitet?
Nej. Kausal tolkning kräver en försvarbar forskningsdesign och antaganden om förväxlingsfaktorer, urval, mätning och intervention. En prediktiv koefficient beskriver enbart ett samband i den anpassade modellen.
Primära referenser