Grunderna i AI
Vad är överanpassning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Överanpassning uppstår när en modell fångar mönster eller brus som fungerar exceptionellt bra på träningsdata men misslyckas med att generalisera till nya exempel. En överanpassad modell kan ha mycket låg träningsfel medan validerings- eller verklig prestanda är avsevärt sämre.
Det motsatta problemet är underanpassning: modellen eller träningsprocessen kan inte fånga tillräckligt av signalen ens på träningsuppsättningen. God modellering balanserar anpassning med generalisering snarare än att sträva efter perfekt träningsprestanda.
Viktiga slutsatser
- Träningsprestanda ensam kan inte diagnostisera generalisering.
- Tidigt stopp bör baseras på valideringsbeteende, aldrig upprepade beslut på det slutgiltiga testsetet.
- Mer data kan hjälpa, men fler funktioner eller högre kapacitet kan också förvärra överanpassning.
- Regularisering, augmentation, korsvalidering, läckageförebyggande och lämplig utvärdering hanterar olika orsaker.
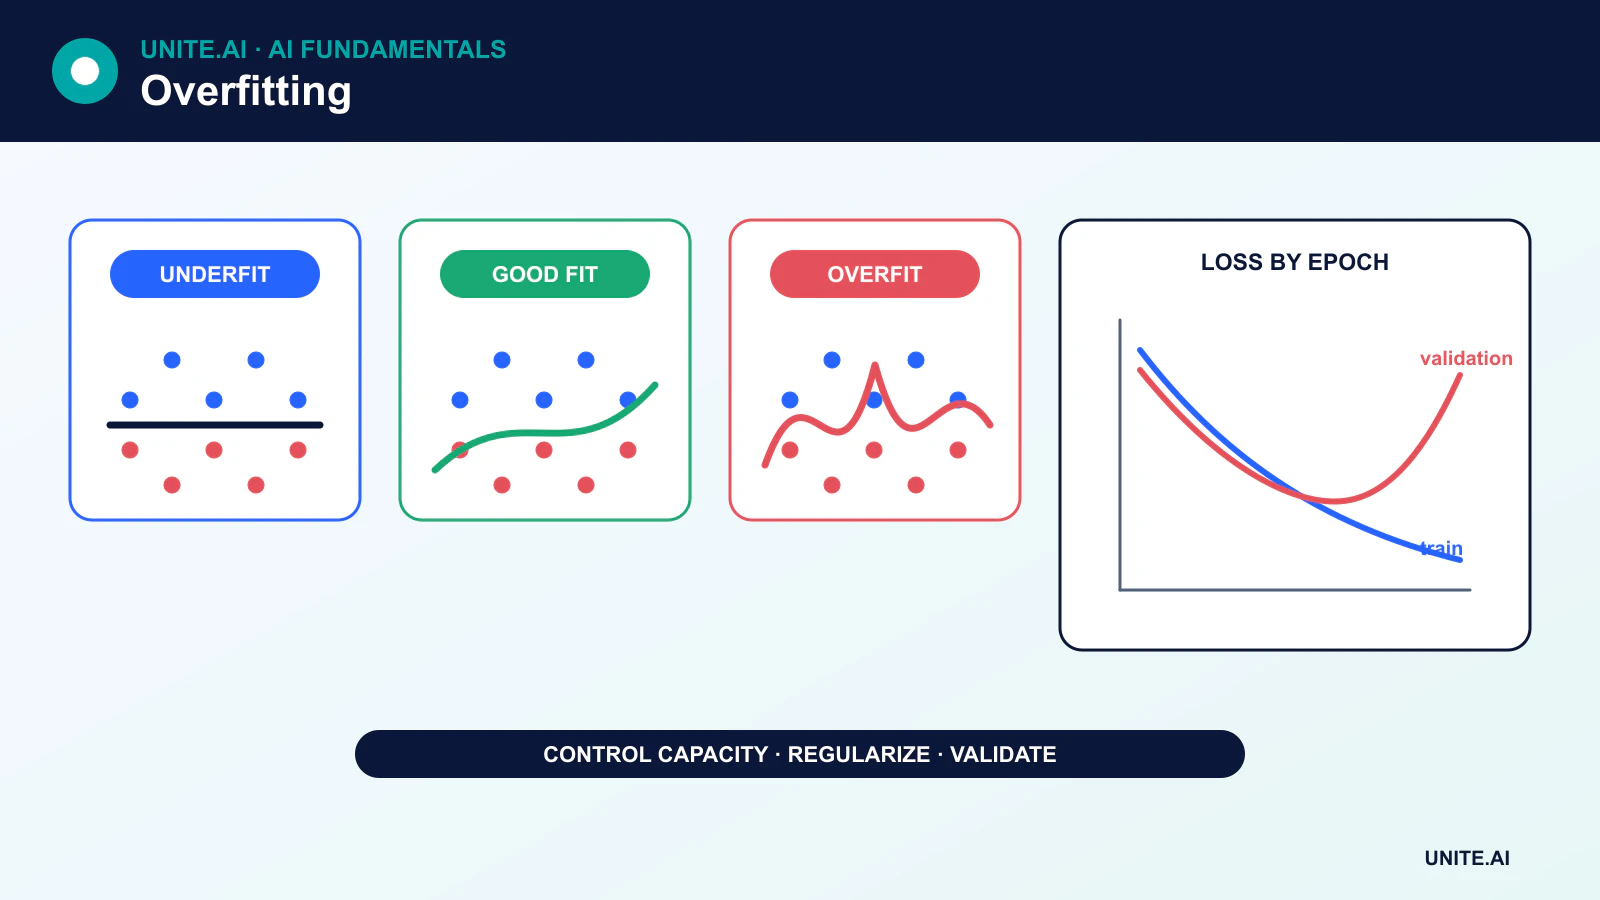
Anpassning, underanpassning och överanpassning
En modell underanpassar när dess antaganden är för restriktiva, dess funktioner utelämnar viktig signal, optimeringen är otillräcklig eller träningen är otillräcklig. Att lägga till relevanta funktioner eller kapacitet kan hjälpa, men att bara lägga till godtyckliga funktioner kan öka brus och överanpassning.
En modell överanpassar när dess effektiva kapacitet är för hög i förhållande till informationen i träningsdata. Exempel inkluderar ett djupt beslutsträd som skapar mycket små blad, ett polynom som följer slumpmässiga fluktuationer, eller ett neuralt nätverk som memoriserar exempel.
Tränings-, validerings- och testdata:s roll
- Träningsdata anpassar modellparametrar.
- Valideringsdata väljer arkitektur, hyperparametrar, tröskelvärden och stoppunkt.
- Testdata ger en slutgiltig uppskattning efter att dessa val är färdiga.
Om testsetet upprepade gånger styr beslut blir det en del av utvecklingsprocessen och ger inte längre en opartisk slutgiltig uppskattning. Korsvalidering kan göra mer effektiv användning av begränsad data, men all förbehandling och funktionsurval måste ske inom varje träningsfold.
Tidigt stopp
Under träning faller vanligtvis träningsförlusten fortsatt. Valideringsförlusten kan falla först och senare stiga när modellen specialiseras på träningsbrus. Tidigt stopp sparar den kontrollpunkt med det bästa valideringsmålet eller stoppar efter att valideringen inte förbättrats under en definierad tålamodsperiod.
Den korrekta kontrollpunkten är inte den med lägst träningsförlust. Ett separat slutligt testset utvärderas efter tidigt stopp och efter att justeringsbeslut är slutförda.
Regulariseringsmetoder
Viktstraff
L2-regularisering eller viktförfall avskräcker stora parametervärden. L1-regularisering kan uppmuntra glesa koefficienter. Deras effekter beror på modell och optimerare; AdamW exempelvis separerar viktförfall från den adaptiva uppdateringen.
Dropout och stokastisk regularisering
Dropout maskerar slumpmässigt aktiveringar under träning. Andra metoder släpper vägar, stör funktioner eller mjukar upp etiketter. Dessa tekniker förändrar träningsmålet och måste inaktiveras eller hanteras korrekt vid inferens.
Dataaugmentation
Augmentation skapar realistiska variationer — såsom beskärningar, rotationer, brus eller parafraser — som bör bevara målet. Ogiltiga transformationer kan ändra etiketten och skada modellen. För bildbehandling hjälper verktyg som Albumentations att implementera kontrollerade pipelines.
Kapacitetskontroll
Ytliga träd, färre parametrar, funktionsurval, beskärning och enklare hypotesklasser kan minska variansen. Trädbeskärning styrs av kriterier, inte slumpmässig borttagning av inlärd detalj.
Dataleckage kan se ut som exceptionell prestanda
Läckage uppstår när information som inte är tillgänglig vid förutsägelse tidpunkt kommer in i träning eller utvärdering. Vanliga exempel inkluderar att anpassa normalisering på hela datamängden, dela upp upprepade poster över folds, använda framtida data för att förutsäga det förflutna, eller inkludera en funktion härledd från målet.
Läckage är inte vanlig överanpassning, men det skapar samma missvisande gap mellan offline-resultat och produktionssättning. Delningsstrategin bör respektera tid, identitet, plats och datagenereringsprocesser.
Distributionsförskjutning är ett separat problem
En modell kan generalisera till sin testfördelning och ändå misslyckas när produktionsdata förändras. Nya enheter, policys, populationer, årstider eller motståndsbeteende kan förändra förhållandet mellan indata och mål. Övervakning och periodisk omvärdering är nödvändiga även när den ursprungliga modellen inte var överanpassad.
Diagnostisering av överanpassning
Använd inlärningskurvor, korsvalideringsvarians, delgruppsmått, kalibrering och felinspektion. Om både tränings- och valideringsprestanda är dåliga, fokusera på underanpassning, funktioner, etiketter eller optimering. Om träning är stark men validering svag, undersök kapacitet, läckage, regularisering och representativitet innan du bara samlar in mer data.
Varför överanpassning sker och hur man upptäcker det
Överanpassning uppstår när en modell lär sig mönster som minskar träningsfelet men inte generaliserar till målpopulationen. Orsaker inkluderar för hög kapacitet i förhållande till effektiv data, etikettbrus, upprepade enheter, flexibel funktionsurval, läckage och justering mot samma valideringsset. Ett växande gap mellan tränings- och valideringsprestanda är vanlig bevisning, men ett litet gap utesluter inte överanpassning om båda seten delar kontamination eller skiljer sig från produktionsmiljön. Inlärningskurvor över datavolym och kapacitet hjälper att skilja varians från bias.
Läckage är särskilt vilseledande: framtida information, dubletter, överlappande subjekt, förbehandling anpassad på all data, eller etiketter kodade i metadata kan ge utmärkta håll‑ut‑resultat. Dela efter den enhet som kommer vara ny vid produktionssättning — patient, kund, maskin, plats eller tid — innan transformationer eller augmentationer anpassas. Behåll ett slutligt testset förseglat medan funktioner, arkitektur och trösklar väljs. Om team upprepade gånger granskar testresultat blir testsetet ett annat valideringsset och behöver ersättas eller korrigeras formellt.
Regularisering, modellval och produktionsdrift
Minska överanpassning med mer representativ data, lägre kapacitet, viktförfall, dropout, tidigt stopp, augmentation, ensemblemetoder eller begränsningar som speglar domänstruktur. Varje metod har avvägningar: augmentation kan förvränga etiketter, dropout förändrar optimering, och ensembler ökar driftskostnaden. Korsvalidering uppskattar urvalets variabilitet, men grupperade eller tidsmedvetna folds måste bevara produktionsgränsen. Jämför med en enkel modell och rapportera osäkerhet över folds eller frön snarare än att välja den mest fördelaktiga körningen.
Produktion kan avslöja en annan form av generaliseringsfel när indata, användare, incitament eller mätning förändras. Övervaka funktion- och förutsägelsefördelningar, kalibrering, delgruppsresultat och fördröjd sann data. Träna inte om automatiskt på ogranskad återkoppling; modellens egna beslut kan forma de etiketter den senare ser. Diagnostisera om felet beror på drift, datapipelines, policyförändringar eller ett ogiltigt mål. Överanpassning styrs av experimentdesign och livscykeldisciplin, inte en enskild regulariseringsinställning.
Arbetsexempel: eliminera läckage i en bedrägerimodell
En initial bedrägeriklassificerare får extremt bra poäng eftersom upprepade kort- och handlarevent dyker upp i slumpmässiga tränings- och testrader, och chargeback‑information som registrerats veckor senare inkluderas som en funktion. Teamet rekonstruerar varje funktions tillgänglighetstid, tar bort fält efter beslut, grupperar efter konto och använder en framåtriktad tidsuppdelning. Prestandan sjunker kraftigt men uppskattar nu det faktiska beslutet. En enkel regelbaslinje och inlärningskurvor styr den nödvändiga modellkomplexiteten.
Regularisering och tidigt stopp finjusteras endast inom historiska folds. Den slutliga utvärderingen rapporterar precision vid granskningskapacitet, återkallelse, kalibrering och kostnad per bedrägerityp och kundsegment. I produktion kommer bekräftade etiketter sent och är partiska beroende på vilka transaktioner som granskades, så övervakning separerar poängdrift från resultatuppskattningar. Omskolning använder adjudicerade fall och återuppspelning mot aktuell policy. Projektet föredrar en lägre ärlig poäng framför en hög läckt poäng som inte kan överleva i produktion.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, distributionsförskjutning, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata kvalitet, utdata beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter utrullning istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policys, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incidentlärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Kan en enkel modell överanpassa?
Ja. Upprepad funktionsurval, tröskeljustering eller utvärdering på samma håll‑ut‑set kan överanpassa utvecklingsprocessen även när den slutliga modellen är enkel.
Löser mer träningsdata alltid överanpassning?
Nej. Mer representativ, korrekt märkt data kan hjälpa, men duplicerad, partisk, läckt eller utanför domän data kanske inte gör det. Lärandemålet och utvärderingsdesignen är fortfarande viktiga.
Primära referenser