Grunderna i AI
Vad är Bayes sats?

 Lägg till Unite.AI bland dina föredragna källor på Google
Bayes sats beskriver hur man uppdaterar sannolikheten för en hypotes efter att ha observerat bevis. Den kopplar sannolikheten för bevis givet en hypotes med sannolikheten för hypotesen givet det beviset.
Denna distinktion är central för statistiskt resonemang och maskininlärning. Ett test kan vara mycket exakt när ett tillstånd är närvarande, medan ett positivt resultat fortfarande har en måttlig sannolikhet att indikera tillståndet om tillståndet är sällsynt.
Viktiga slutsatser
- Den posterior kombinerar en a priori tro med sannolikheten för observerade bevis.
- Bevis‑termen normaliserar de möjliga hypoteserna.
- Basfrekvenser kan dominera till synes starka bevis.
- Naiv Bayes antar att funktioner är villkorligt oberoende givet klassen, inte oberoende i varje situation.
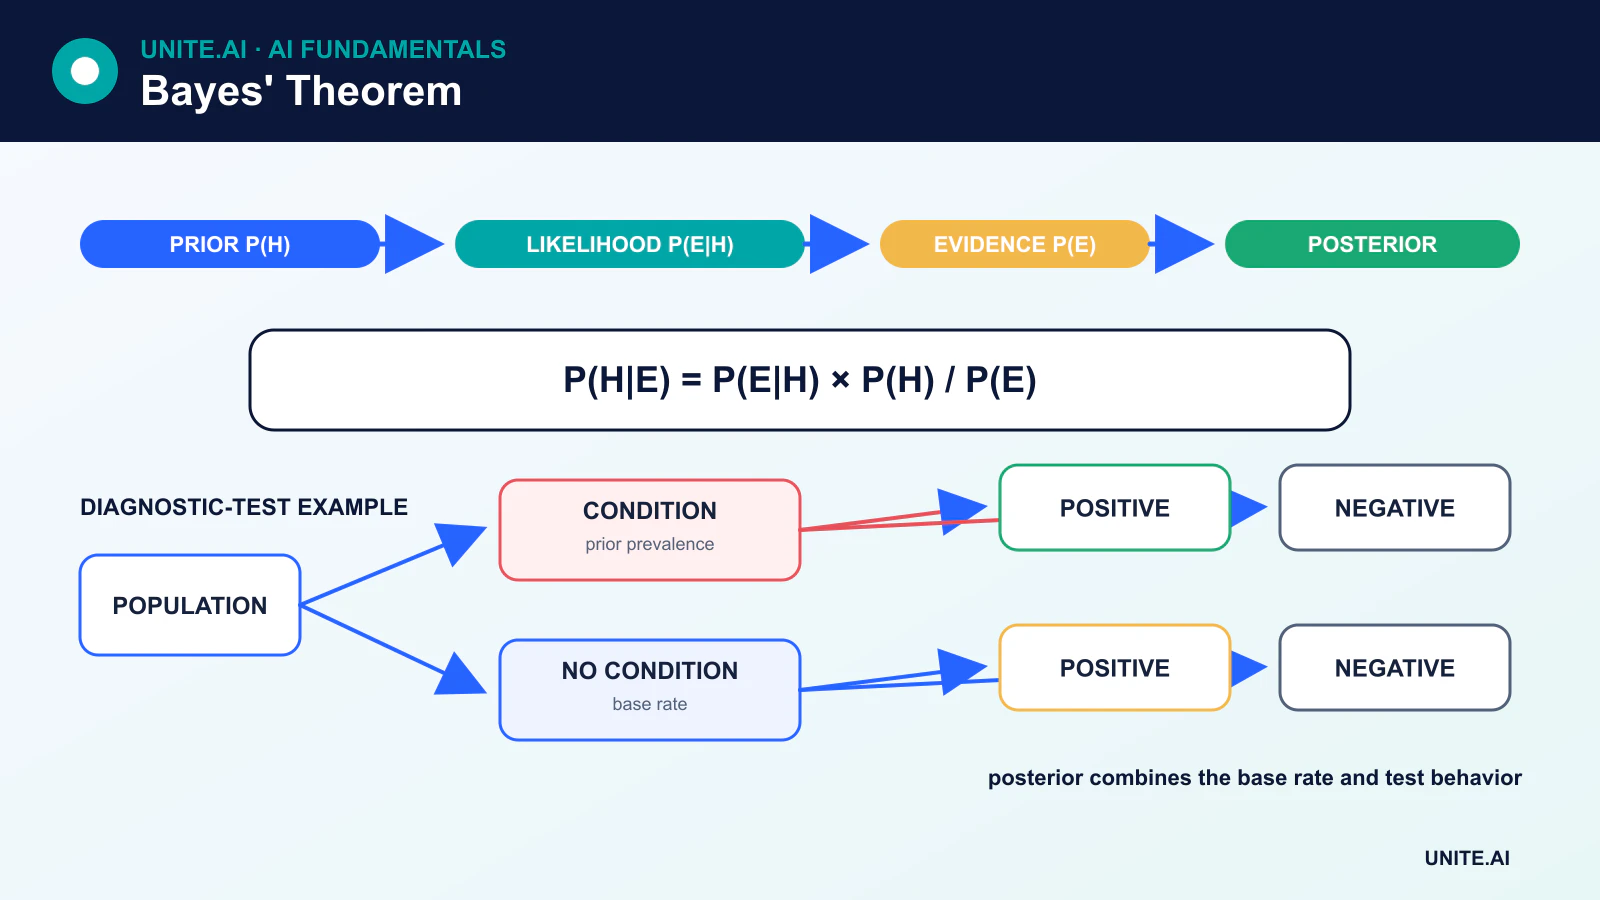
Formeln
P(A|B) = P(B|A)P(A) / P(B)
- P(A) är den a priori sannolikheten för hypotes A.
- P(B|A) är sannolikheten för att observera bevis B om A är sann.
- P(B) är den totala sannolikheten för beviset.
- P(A|B) är den posteriora sannolikheten för A efter att ha observerat B.
Satsen följer av två ekvivalenta uttryck för gemensam sannolikhet: P(A ∩ B) = P(B|A)P(A) och P(A ∩ B) = P(A|B)P(B).
Ett numeriskt exempel på basfrekvens
Anta att ett tillstånd påverkar 1 % av en population. Ett test har 90 % känslighet och 5 % falsk‑positiv frekvens. Betrakta 1 000 personer:
- Omkring 10 har tillståndet; testet flaggar korrekt 9.
- Omkring 990 har inte tillståndet; en 5 % falsk‑positiv frekvens flaggar ungefär 50.
- Det blir därför omkring 59 positiva resultat, varav 9 är sanna positiva.
Sannolikheten för tillståndet efter ett positivt resultat är cirka 9 / 59 ≈ 15 %, inte 90 %. Testets känslighet svarar på P(positiv | tillstånd); användaren vill vanligtvis ha P(tillstånd | positiv). Bayes sats kopplar dem via basfrekvensen.
Bayesisk uppdatering
När ny bevisning anländer kan en posterior bli den a priori för nästa uppdatering. En komplett Bayesisk modell specificerar möjliga hypoteser, a priori‑fördelningar, en sannolikhetsfunktion och den storhet som ska infereras. Osäkerhet representeras med en posteriorfördelning snarare än enbart en punktuppskattning.
Den a priori bör dokumenteras och testas för känslighet. En svagt informativ a priori kan regularisera osannolika värden, medan en dåligt vald stark a priori kan dominera begränsade data.
Naiva Bayes‑klassificerare
Naiv Bayes förutsäger en klass y från funktioner x₁ … xₙ med hjälp av Bayes sats och antagandet:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Funktionerna antas vara villkorligt oberoende när klassen är känd. Detta är ofta orealistiskt, men klassificeraren kan fungera bra när de resulterande klasspoängen fortfarande är användbara.
Vanliga varianter
- Multinomial Naive Bayes modellerar räkneliknande funktioner och är vanlig i dokumentklassificering.
- Bernoulli Naive Bayes modellerar binär närvaro av funktioner.
- Gaussian Naive Bayes modellerar varje kontinuerlig funktion med en klass‑villkorlig Gaussisk fördelning.
- Categorical Naive Bayes modellerar diskreta kategorier.
Utjämning och numerisk stabilitet
Om ett funktionsvärde aldrig förekommer med en klass i träningsdata kan en osmoothed sannolikhetsuppskattning bli noll och eliminera hela produkten. Additiv eller Laplace‑liknande utjämning förhindrar detta. Implementationer beräknar loggsannolikheter så att multiplikation av många små värden blir addition av stabila loggvärden.
Sannolikheter, poäng och kalibrering
Naiva Bayes‑sannolikhetsutdata kan vara dåligt kalibrerade eftersom korrelerade funktioner i praktiken räknas flera gånger. En klassificerare kan rangordna klasser väl samtidigt som den överskattar förtroendet. Kalibrering bör utvärderas på håll‑ut‑data när sannolikheter styr beslut.
Bayes bortom Naiv Bayes
Bayesisk inferens stödjer hierarkiska modeller, A/B‑tester, vetenskaplig parameterestimering, prognostisering, osäkerhetsmedvetet beslutsfattande och probabilistiska grafiska modeller. Approximerade metoder såsom Markov‑kedje‑Monte‑Carlo och variational inference används när en posterior inte kan beräknas i sluten form.
Vanliga resonemangsfel
- Förväxla P(A|B) med P(B|A).
- Ignorera en sällsynt eller vanlig basfrekvens.
- Behandla en a priori som objektiv eller lämna den odokumenterad.
- Anta att en hög sannolikhet automatiskt innebär en hög posterior.
- Tolkar en prediktiv association som orsakssamband.
Villkorlig sannolikhet, odds och bevis
Bayes sats relaterar sannolikheten för en hypotes efter bevis till dess a priori‑sannolikhet, sannolikheten för att observera beviset under hypotesen och den totala sannolikheten för beviset. I odds‑form är posteriorodds lika med a priori‑odds multiplicerat med en sannolikhetskvot. Detta separerar vad som troddes innan ett test från hur starkt testet skiljer hypoteserna. Ett test som verkar mycket exakt kan fortfarande ge många falska positiva när tillståndet är sällsynt eftersom basfrekvensen påverkar postern.
Sannolikheten är en funktion av hypotesen för fasta observerade data och bör inte förväxlas med hypotesens sannolikhet. Bevisnormalisering summerar eller integrerar över konkurrerande hypoteser. Antaganden om villkorligt oberoende kan förenkla beräkningen, som i Naiv Bayes, men måste kontrolleras mot konsekvenser. Flera bevisstycken kan inte multipliceras som oberoende när de delar orsaker eller duplicerar information. Orsaklig riktning spelar också roll: P(bevis|hypotes) är i allmänhet inte P(hypotes|bevis), det klassiska felet med omvänd sannolikhet.
Modelleringsval, beräkning och beslutsanvändning
Bayesisk analys specificerar en a priori, en sannolikhetsfunktion och en posterior prediktiv fördelning. A priori kan kodas med etablerad kunskap, regularisera små urval eller vara svagt informativa; de bör motiveras och testas genom känslighetsanalys. Konjugata modeller ger analytiska uppdateringar, medan Markov‑kedje‑Monte‑Carlo, variational inference och sekventiella metoder approximerar komplexa posteriorer. Diagnostisera konvergens, effektivt stickprov, approximationsfel och a priori prediktiv plausibilitet snarare än att rapportera ett posteriorvärde utan beräkningskontroller.
En posterior sannolikhet informerar men väljer inte i sig själv en handling. Beslut kräver förluster, fördelar, begränsningar och tillgängliga alternativ. Utvärdera probabilistiska modeller med kalibrering, korrekta poängregler och posterior‑prediktiva kontroller på nya data. Uppdatera endast med bevis som samlats in under en modellerad process; urvalsbias och dataset‑skift kan ogiltigöra sannolikhetsfunktionen. Kommunicera trovärdiga intervall och antaganden utan att behandla dem som garanterade frekvensintervall. Bayes sats är exakt sannolikhetsalgebra, medan kvaliteten på ett Bayesiskt slutsats beror på den modell och de bevis som tillhandahålls.
Arbetsexempel: tolka ett diagnostiskt test
Ett test har 95 % känslighet och 90 % specificitet, men tillståndet påverkar endast 1 % av den screenade populationen. För 10 000 personer förväntas omkring 95 sanna positiva och 990 falska positiva, vilket ger ett positivt prediktionsvärde under 9 %. Bayes sats gör basfrekvenseffekten explicit. Beräkningen anger population, testtröskel och osäkerhet snarare än att marknadsföra känsligheten som chansen att ett positivt resultat är korrekt. Denna distinktion är också grundläggande för noggrann data science.
Kliniker uppdaterar sannolikheten med ytterligare bevis endast när beroende mellan tester modelleras. En beslutströskel införlivar skada av missad sjukdom, risk för bekräftande test, kostnad och patientpreferens. Kalibrering kontrolleras i den lokala populationen, och förändringar i prevalens utlöser en granskning. Postern stödjer diskussion och nästa steg; den ersätter inte en bekräftande diagnos. Rapportering använder naturliga frekvenser och känslighetsanalys så att patienter och praktiker kan se hur slutsatsen förändras under rimliga antaganden.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och särskilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång, och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata kvalitet, utdata beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödiga känsliga data. Definiera larmtrösklar och en ansvarig för respons, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Utvärdera igen när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterade återställnings‑, incident‑lärande‑, raderings‑ och behållningsprocedurer samt en tydlig punkt då det bör inaktiveras eller ersättas.
Vanliga frågor
Vad är skillnaden mellan en likelihood och en sannolikhet?
När parametrarna är fixerade tilldelar en modell sannolikhet till möjliga data. När observerade data är fixerade kan samma uttryck ses som en likelihood‑funktion över möjliga parametervärden. Den numeriska formeln kan vara densamma medan tolkningen skiljer sig.
Är Naiv Bayes fullständig Bayesisk inferens?
Den använder Bayes sats för klassificering under en stark villkorligt‑oberoende modell. Bredare Bayesisk inferens placerar fördelningar över okända storheter och resonerar med en posteriorfördelning.
Primära referenser