
Grunderna i AI
Vad är neurala nätverk?

 Lägg till Unite.AI bland dina föredragna källor på Google
Ett artificiellt neuralt nätverk är en parametriserad matematisk modell bestående av lager av sammankopplade operationer. Under träning justerar nätverket sina parametrar så att indata mappas till användbara utdata. Neurala nätverk kan approximera komplexa icke‑linjära samband och lära sig representationer direkt från text, bilder, ljud, tidsserier och annan data.
Namnet är historiskt inspirerat av biologiska neuroner, men moderna nätverk är ingenjörssystem snarare än realistiska simuleringar av hjärnan. Termer som ”neuron” och ”inlärning” är praktiska förkortningar och bör inte förväxlas med bevis på mänsklig liknande kognition.
Viktiga slutsatser
- En neuron beräknar en viktad summa, lägger till ett tränbart bias och applicerar en aktiveringsfunktion.
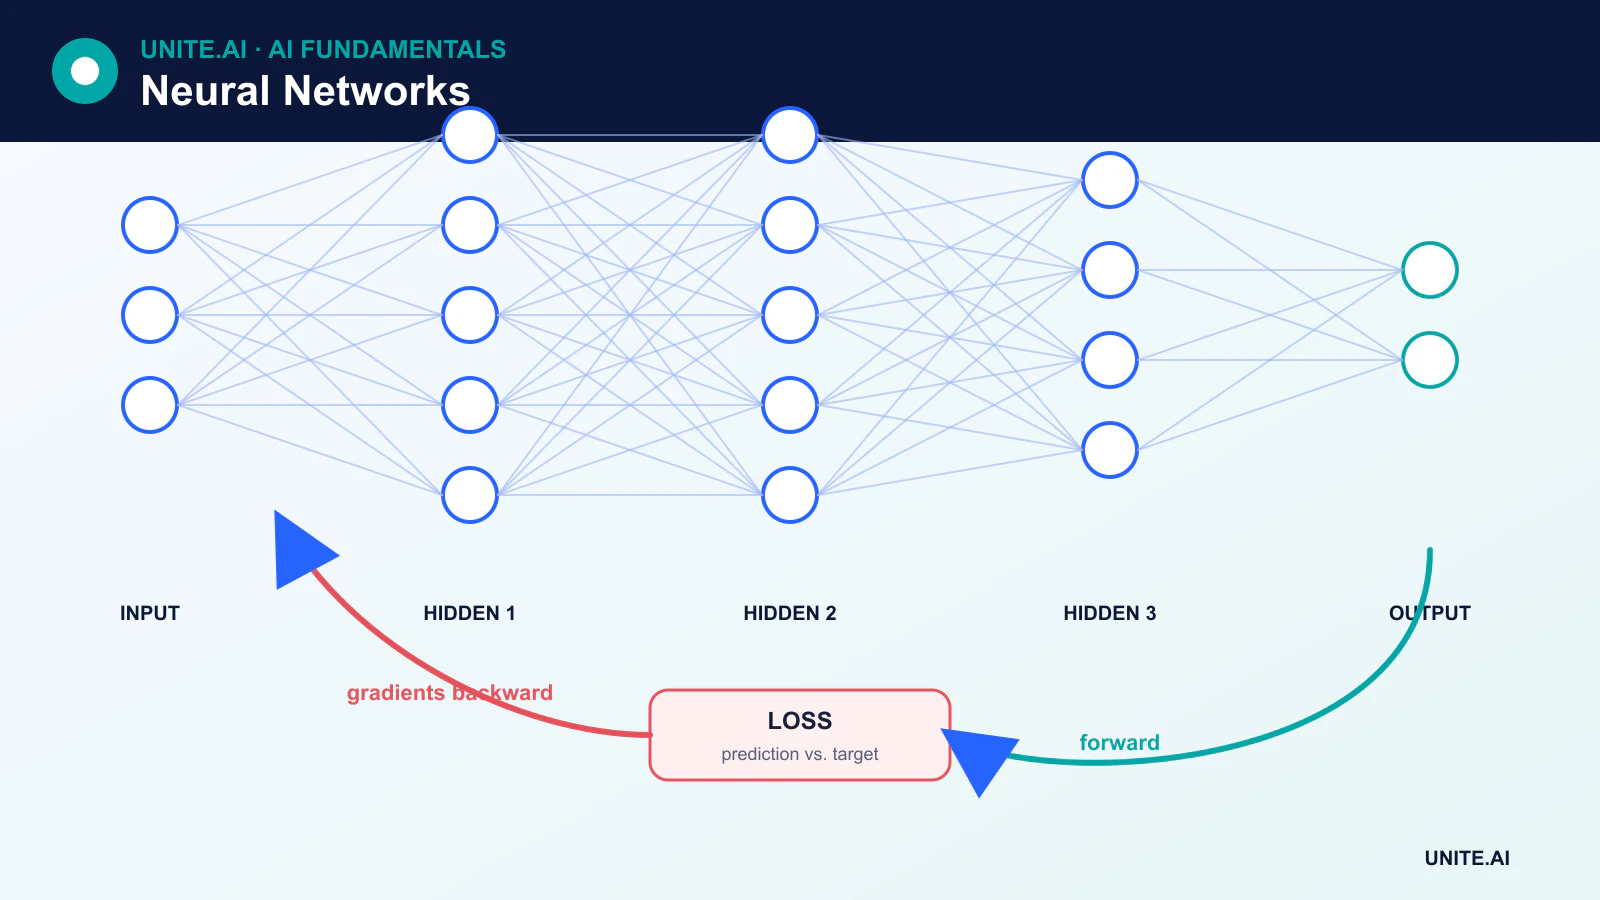
- En framåtpassning skapar prediktioner; en förlust mäter fel; bakåtspridning beräknar gradienter; en optimerare uppdaterar parametrar.
- MLP‑er, CNN‑er, RNN‑er och transformatorer organiserar anslutningarna på olika sätt.
- Fler lager eller parametrar ger inte automatiskt en bättre eller mer pålitlig modell.
Från en enskild artificiell neuron till ett nätverk
För en indatavektor x beräknar en grundläggande enhet:
z = Wx + boutput = activation(z)
W innehåller tränbara vikter och b är ett tränbart bias. Aktiveringsfunktionen introducerar icke‑linjäritet. Vikterna “passerar” inte själva genom aktiveringen; aktiveringen appliceras på den viktade summan och bias.
Ett flerlagers perceptron (MLP) staplar täta lager. Indatalagret representerar funktionerna, dolda lager transformerar dem, och utgångslagret är utformat för uppgiften – till exempel klasslogits eller ett regressionsvärde.
Hur neurala nätverk lär sig
- Modellen initierar tränbara parametrar.
- En framåtpassning bearbetar en batch och genererar prediktioner.
- En förlustfunktion jämför prediktioner med träningsmålet.
- Bakåtspridning använder kedjeregeln för att beräkna gradienter.
- En optimerare, såsom stochastic gradient descent eller AdamW, uppdaterar vikter och bias.
Bakåtspridning blev central för träning av neurala nätverk genom arbete som utvecklades och populariserades under flera decennier; den skapades inte först i den senaste deep‑learning‑eran. Moderna ramverk implementerar omvänd‑läge automatisk differentiering så att praktiker inte behöver härleda varje gradient manuellt.
Varför aktiveringsfunktioner är viktiga
Utan icke‑linjära aktiveringar kollapsar flera vanliga linjära lager till en enda linjär transformation. ReLU används i stor utsträckning eftersom den är enkel och effektiv. GELU och SiLU är vanliga i moderna arkitekturer. Sigmoid och softmax är fortfarande användbara för vissa utdatatolkningar, men sigmoid kan mättas i dolda lager och bidra till försvinnande gradienter.
Stora neurala nätverksarkitekturer
Konvolutionella neurala nätverk
CNN‑er tillämpar inlärda filter över lokala grannskap och delar parametrar över positioner. Dessa egenskaper gör dem effektiva för bilder och andra rutnätsliknande signaler.
Rekurenta nätverk
RNN‑er, LSTM‑er och GRU‑er uppdaterar ett dolt tillstånd över en sekvens. De är fortfarande användbara för strömning och tidsserier, även om återkommande begränsar parallell bearbetning och kan ha problem med långa beroenden.
Transformatorer
Transformatorer använder uppmärksamhet för att skapa kontextberoende representationer. Residuala anslutningar, normalisering, positionsinformation och feed‑forward‑block är kärnkomponenter i arkitekturen. Transformatorer ligger nu till grund för många stora språk‑ och multimodala modeller.
Autoenkodare och generativa nätverk
Autoenkodare lär sig representationer genom rekonstruktion. GAN‑er, diffusionsmodeller och autoregressiva nätverk genererar nya prover med olika mål och träningsprocedurer.
Komponenter som gör djupa nätverk träningsbara
Moderna system använder mer än lager och aktiveringar. Residuala anslutningar låter information och gradienter kringgå block. Normalisering stabiliserar aktiveringar. Regularisering, data‑augmentation, dropout och viktförfall kan minska overfitting. Inbäddningslager mappar diskreta element såsom token till vektorer. Uppmärksamhet låter en representation dynamiskt bero på andra element.
Styrkor och begränsningar
Neurala nätverk kan lära sig funktioner från högdimensionell rådata och skala med data och beräkningskraft. De kan också kräva stora datamängder, specialiserad hårdvara och noggrann fininställning. Deras prediktioner kan vara dåligt kalibrerade, sköra under fördelningsskift, sårbara för adversariell manipulation eller svåra att förklara.
Arkitekturen bör följa uppgiftens och driftsättningsbegränsningarnas krav. För många tabulära problem kan en trädensemble eller en linjär modell vara snabbare och enklare att validera. För höginsats‑applikationer måste modellens prestanda utvärderas per undergrupp och feltyp, inte bara genom ett samlat benchmark.
Lager, aktiveringar och informationsflöde
Ett neuralt nätverk komponerar parametriserade funktioner. Varje enhet bildar en viktad kombination av indata, lägger till ett bias och passerar resultatet genom en aktivering såsom ReLU, sigmoid, tanh eller GELU. Att stapla lager möjliggör hierarkiska funktioner och icke‑linjära beslutsgränser. Bredd styr antalet enheter per lager; djup styr successiva transformationer; anslutning och vikt‑delning kodar arkitekturen. Nätverkets utdata beror på förbehandling, parametrar, normalisering och inferensläge tillsammans. En neuron är en matematisk operation, inte en bokstavlig biologisk neuron eller ett självständigt meningsfullt begrepp.
Framåtpropagation beräknar prediktioner; en förlust kvantifierar fel; bakåtspridning applicerar kedjeregeln på gradienter; en optimerare uppdaterar parametrar. Initiering, inlärningshastighet, batch‑statistik, residual‑vägar och normalisering påverkar om gradienter försvinner, exploderar eller förblir användbara. Regularisering inkluderar viktförfall, dropout, augmentation, tidig stoppning och arkitekturella begränsningar. Plotta tränings‑ och valideringsbeteende, inspektera gradient‑ och aktiveringsstatistik, och jämför upprepade körningar. Ett stort nätverk kan memorera träningsdata, medan ett litet kan underanpassa eller missa nödvändig struktur.
Val av arkitektur, utvärdering och driftsättning
Flerlagers perceptroner bearbetar fasta vektorer; konvolutionella nätverk utnyttjar lokal struktur; rekurrenta och state‑space‑modeller bearbetar sekvenser; transformatorer använder uppmärksamhet; grafnätverk utbyter information längs kanter. Hybrider är vanliga. Välj baserat på induktiv bias, data, sekvens‑ eller bildstorlek, latens, minne, tolkbarhet och tillgänglig hårdvara. Utvärdera mot en linjär eller trädbaslinje och utför ablationer för att lära vilken komplexitet som är viktig. Antalet parametrar ensam förutsäger inte kvalitet, inferenskostnad eller datakrav.
Driftsättning kräver fryst förbehandlingssteg, en exporterad eller kompilerad graf, numerisk validering och resurs‑tester under realistisk belastning. Kvantisering och beskärning kan minska storlek men kan förändra beteende för sällsynta klasser. Övervaka indata, utdata, kalibrering, latens och bekräftade resultat; testa adversariella och skiftade data. Skydda modeller, beroenden och data genom signerade artefakter, åtkomstkontroll och leverantörskedjegranskning. Förklaringar från enskilda aktiveringar eller salienser kräver kausal och beteendemässig verifiering. Neurala nätverk är flexibla funktionsapproximerare, inte garantier för förståelse, sanning eller robusthet.
Arbetsexempel: en neural efterfrågeprognos
En återförsäljare förutspår veckovis produktefterfrågan utifrån försäljning, kampanjer, pris, helgdagar, tillgänglighet och väder. Nätverket jämförs med säsongsmässiga naiva, linjära och trädbaserade baslinjer med rullande tidsuppdelningar. Framtida kampanjer inkluderas endast när de faktiskt är kända vid prognostid, medan lagerbrist modelleras eftersom observerad försäljning kan underskatta efterfrågan. Utvärderingen använder viktad absolut fel, bias, intervalltäckning och resultat per artikel‑hastighet och butik.
Driftsättnings‑pipeline‑versionerna inkluderar funktionstillgänglighet, modell och horisont och avvisar en prognos när nödvändiga indata är föråldrade. Planerare ser intervall och kan åsidosätta med registrerade skäl. Övervakning upptäcker saknade flöden, förändrat fel, bias och ovanliga prognoser; affärsresultat separeras från prognosnoggrannhet eftersom beställningspolicy även påverkar lager. En modelluppdatering skuggas över flera cykler, och den tidigare prognosmodellen förblir tillgänglig för återgång under säsongs‑ eller leverantörsstörningar.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktiga eller saknade indata, fördelningsskift, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödig känslig data. Definiera larmtrösklar och en ansvarig för respons, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterade återställnings‑, incident‑lärande‑, raderings‑ och bevarandeförfaranden samt en tydlig punkt då det bör inaktiveras eller ersättas.
Vanliga frågor
Är varje neuralt nätverk deep learning?
Nej. Ett litet nätverk med ett dolt lager är ett neuralt nätverk, medan deep learning vanligtvis avser arkitekturer med flera inlärda bearbetningssteg. Gränsen är konventionell snarare än en strikt vetenskaplig tröskel.
Lagrar neurala nätverk sin träningsdata?
De lagrar inlärda parametrar, inte en vanlig sökbar kopia av datamängden. Trots detta kan stora modeller memorera och reproducera enskilda träningsexempel, vilket skapar integritets‑ och upphovsrättsrisker som måste testas.
Primära referenser












