
Grunderna i AI
Vad är backpropagation?

 Lägg till Unite.AI bland dina föredragna källor på Google
Backpropagation är algoritmen som används för att beräkna hur en neuronnätverk’s förlust förändras i förhållande till dess träningsbara parametrar. Den tillämpar kedjeregeln i kalkyl baklänges genom de operationer som registrerats under ett framåtpass.
Backpropagation beräknar gradienter; den bestämmer inte själva uppdateringen. En optimerare såsom stokastisk gradientnedstigning eller AdamW använder dessa gradienter för att förändra vikter, bias och andra träningsbara parametrar.
Viktiga slutsatser
- Framåtpasset bygger mellanstegsvärden och producerar en prediktion.
- Förlustfunktionen omvandlar prediktionen och målet till ett skalärt träningsmål.
- Backpropagation använder lokala derivator och kedjeregeln för att effektivt beräkna parametergradienter.
- Moderna ramverk implementerar omvänd läges automatisk differentiering över en beräkningsgraf.
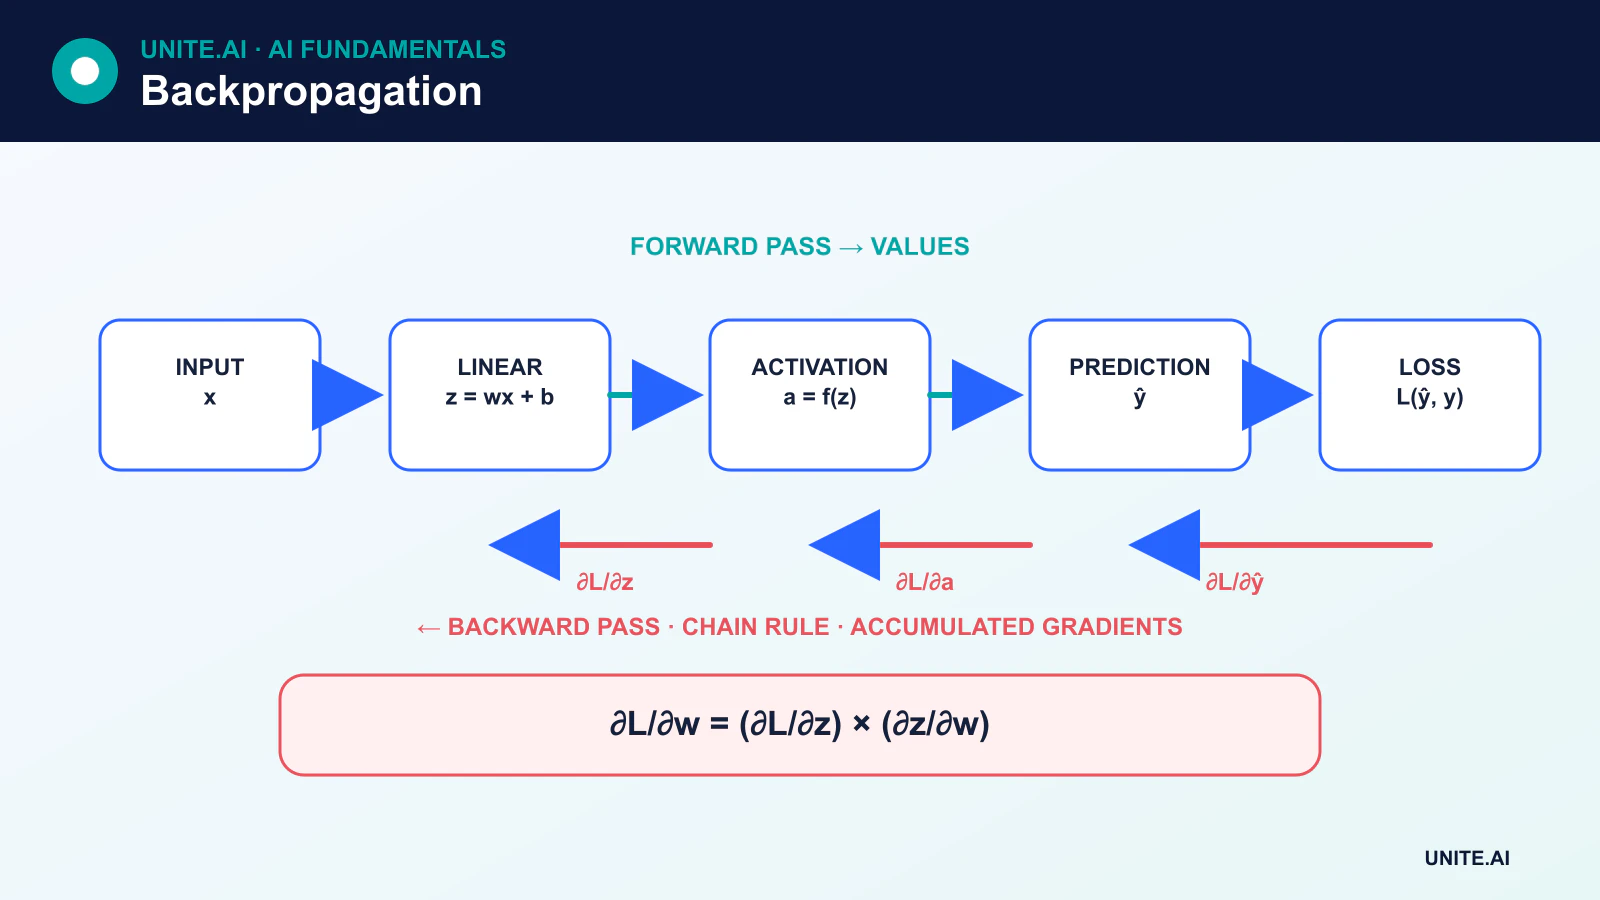
Framåtpasset
Betrakta en enkel enhet:
z = wx + bŷ = activation(z)
Indatan är x, medan w och b är träningsbara vikt- och biasparametrar. Bias förändras normalt under träning precis som vikter gör. Ett nätverk kombinerar många sådana operationer, samt normalisering, uppmärksamhet, konvolutioner, residualanslutningar eller andra differentierbara block.
Framåtpasset utvärderar dessa operationer och producerar en prediktion. En förlust såsom korsentropi eller medelkvadratfel mäter målet. Den bästa förlusten beror på uppgiften och tolkningen av utdata.
Kedjeregeln
Om förlusten L beror på ett mellanstegsvärde z, och z beror på parametern w, ger kedjeregeln:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Ett djupt nätverk innehåller många vägar. Backpropagation traverserar beräkningsgrafen i omvänd riktning och ackumulerar bidrag när ett värde påverkar förlusten genom mer än en väg. Resultatet är en gradient för varje träningsbar parameter som deltog i framåtkalkylen.
Ett litet numeriskt exempel
Anta ŷ = wx + b, med x = 2, w = 3 och b = 1. Prediktionen blir 7. Om målet är 5 och förlusten är L = ½(ŷ - y)², så:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optimeraren kan då flytta w och b i negativ gradientriktning. Denna formel är specifik för den valda linjära enheten och kvadratiska fel‑förlusten; en universell backpropagation‑regel är kedjeregeln över den faktiska grafen, inte en fast ”fel”-ekvation.
Backpropagation vs. gradientnedstigning
Gradientnedstigning är en optimeringsmetod. Backpropagation levererar de gradienter den behöver. Ett träningssteg följer vanligtvis:
- Rensa eller återställ lagrade gradienter.
- Kör framåtpasset.
- Beräkna förlusten.
- Kör bakåtpasset.
- Applicera optimerarens uppdatering.
Att separera dessa begrepp underlättar förståelsen av momentum, AdamW, gradientackumulering och träning med blandad precision.
Automatisk differentiering
Ramverk såsom PyTorch registrerar operationer och bygger en graf under framåtpasset. Omvänd läges automatisk differentiering beräknar sedan vektor‑Jacobian‑produkter effektivt från utdata tillbaka till parametrar. Detta är mer generellt än att manuellt koda derivator för ett fast nätverk och är grundläggande för moderna djupinlärnings-ramverk.
Vissa operationer är icke‑differentierbara eller har instabila derivator. Ramverk definierar subgradienter eller dokumenterade konventioner i vissa fall, men praktiker måste fortfarande förstå fristående tensorer, in‑place‑operationer och numerisk precision.
Försvinnande och exploderande gradienter
Upprepad multiplikation genom många lager eller tidssteg kan göra gradienter extremt små eller stora. Försvinnande gradienter fördröjer inlärning i tidigare lager; exploderande gradienter destabiliserar uppdateringar. ReLU‑familjens aktiveringar, noggrann initiering, residualanslutningar, normalisering, gated återkoppling och gradientklippning hjälper, men ingen är en universell lösning.
Kontroll av gradienter
Finita differensgradientkontroll jämför en analytisk eller automatisk gradient med en numerisk approximation. Den är långsam men användbar för felsökning av anpassade operationer. Övervakning av gradientnormer och upptäckt av NaN‑ eller oändliga värden kan avslöja instabilitet under träning.
Kedjeregeln genom en beräkningsgraf
Backpropagation beräknar effektivt gradienter av en skalär förlust med avseende på varje differentierbar parameter. Ett framåtpass registrerar mellanstegsvärden i en beräkningsgraf. Med start från förlusten tillämpar omvänd läges automatisk differentiering kedjeregeln, multiplicerar lokala derivator och ackumulerar bidrag där vägar möts. För ett lager y=f(x,w) kombineras upstream‑känsligheten för y med partiella derivator för att producera känsligheter för x och w. Backpropagation beräknar gradienter; optimeraren bestämmer hur parametrarna förändras.
Ett enkelt affint lager producerar y=Wx+b. Gradient för W är yttre produkten av upstream‑gradienten och indata, gradienten för b summerar upstream‑värden, och indata‑gradienten multipliceras med den transponerade viktmatrisen. Aktiveringar lägger till elementvisa derivator. Konvolution, normalisering, uppmärksamhet och återanvändning i återkommande nätverk följer samma grafprincip men kräver korrekta tensorformer, broadcasting, maskning och parameterdelning. Ramverk frigör sparade aktiveringar efter bakåtpasset om de inte behålls, så minnet växer ofta med batch, djup och sekvenslängd.
Gradientfel, verifiering och ingenjörspraxis
Produkter av många derivator kan försvinna eller explodera. ReLU‑liknande aktiveringar, noggrann initiering, normalisering, residualanslutningar, gating och gradientklippning hanterar olika mekanismer. Mättade aktiveringar och icke‑differentierbara operationer kan blockera användbara signaler; trunkerad backpropagation begränsar sekvenshistorik; blandad precision kan underflöda utan förlustskalning. Exploderande gradienter är ett symptom, så klippning bör åtföljas av undersökning av inlärningshastighet, data, arkitektur och numeriska fel snarare än att dölja dem.
Verifiera anpassade operationer med finita differensgradientkontroller på små dubbelprecisionsindata, undvik icke‑differentierbara punkter. Inspektera gradientnormer, NaN, inaktiva parametrar och om gradienterna når förväntade moduler. Rensa ackumulerade gradienter medvetet och skilj tränings‑ från utvärderingsbeteende för dropout och normalisering. Checkpointing beräknar om aktiveringar för att spara minne; distribuerad träning måste aggregera gradienter konsekvent. En minskande träningsförlust visar att en optimeringsväg existerar, men inte att gradienterna är konceptuellt korrekta, data är läckagefri eller modellen generaliserar.
Arbetsexempel: verifiera ett anpassat neuralt lager
En ingenjör implementerar ett differentierbart spektrallager för ett ljudnätverk. Ett litet dubbelprecisions‑test jämför automatiska gradienter med centrala finita differenser över indata och parametrar, exklusive punkter där operationen avsiktligt är icke‑differentierbar. Form, broadcasting, padding och komplex‑till‑reell konvertering får separata fall. Testet verifierar ackumulerade gradienter när en parameter återanvänds och bekräftar att maskerade ljudramar inte ger någon gradient.
Under träning spårar instrumentpaneler gradient‑ och aktiveringsnormer, NaN, inaktiva parametrar och förlustskalning. En medvetet korrumperad batch bekräftar att validering fångar icke‑ändliga utdata innan en optimeraruppdatering. Blandad precision och exporterade implementationer jämförs med referensen. Checkpoint‑återupptagningstester inkluderar optimerartillstånd och slumpmässig ordning. Lagret accepteras inte enbart för att den totala förlusten minskar; enhetsgradienter, numerisk stabilitet och nedströms generalisering måste alla ge konsekvent bevis.
Implementationsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata kvalitet, utdata beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incidentlärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Uppdaterar backpropagation vikterna?
Backpropagation beräknar gradienter. Optimeraren applicerar en uppdatering med hjälp av dessa gradienter, dess inlärningshastighet och eventuellt tillstånd såsom momentum eller adaptiva moment.
Är backpropagation biologiskt realistisk?
Standard backpropagation är en ingenjörsalgoritm och accepteras inte som en detaljerad modell för inlärning i biologiska hjärnor. Den historiska neurala analogin bör inte betraktas som biologisk ekvivalens.
Primära referenser












