
Grunderna i AI
Vad är CNNs (Convolutional Neural Networks)?

 Lägg till Unite.AI bland dina föredragna källor på Google
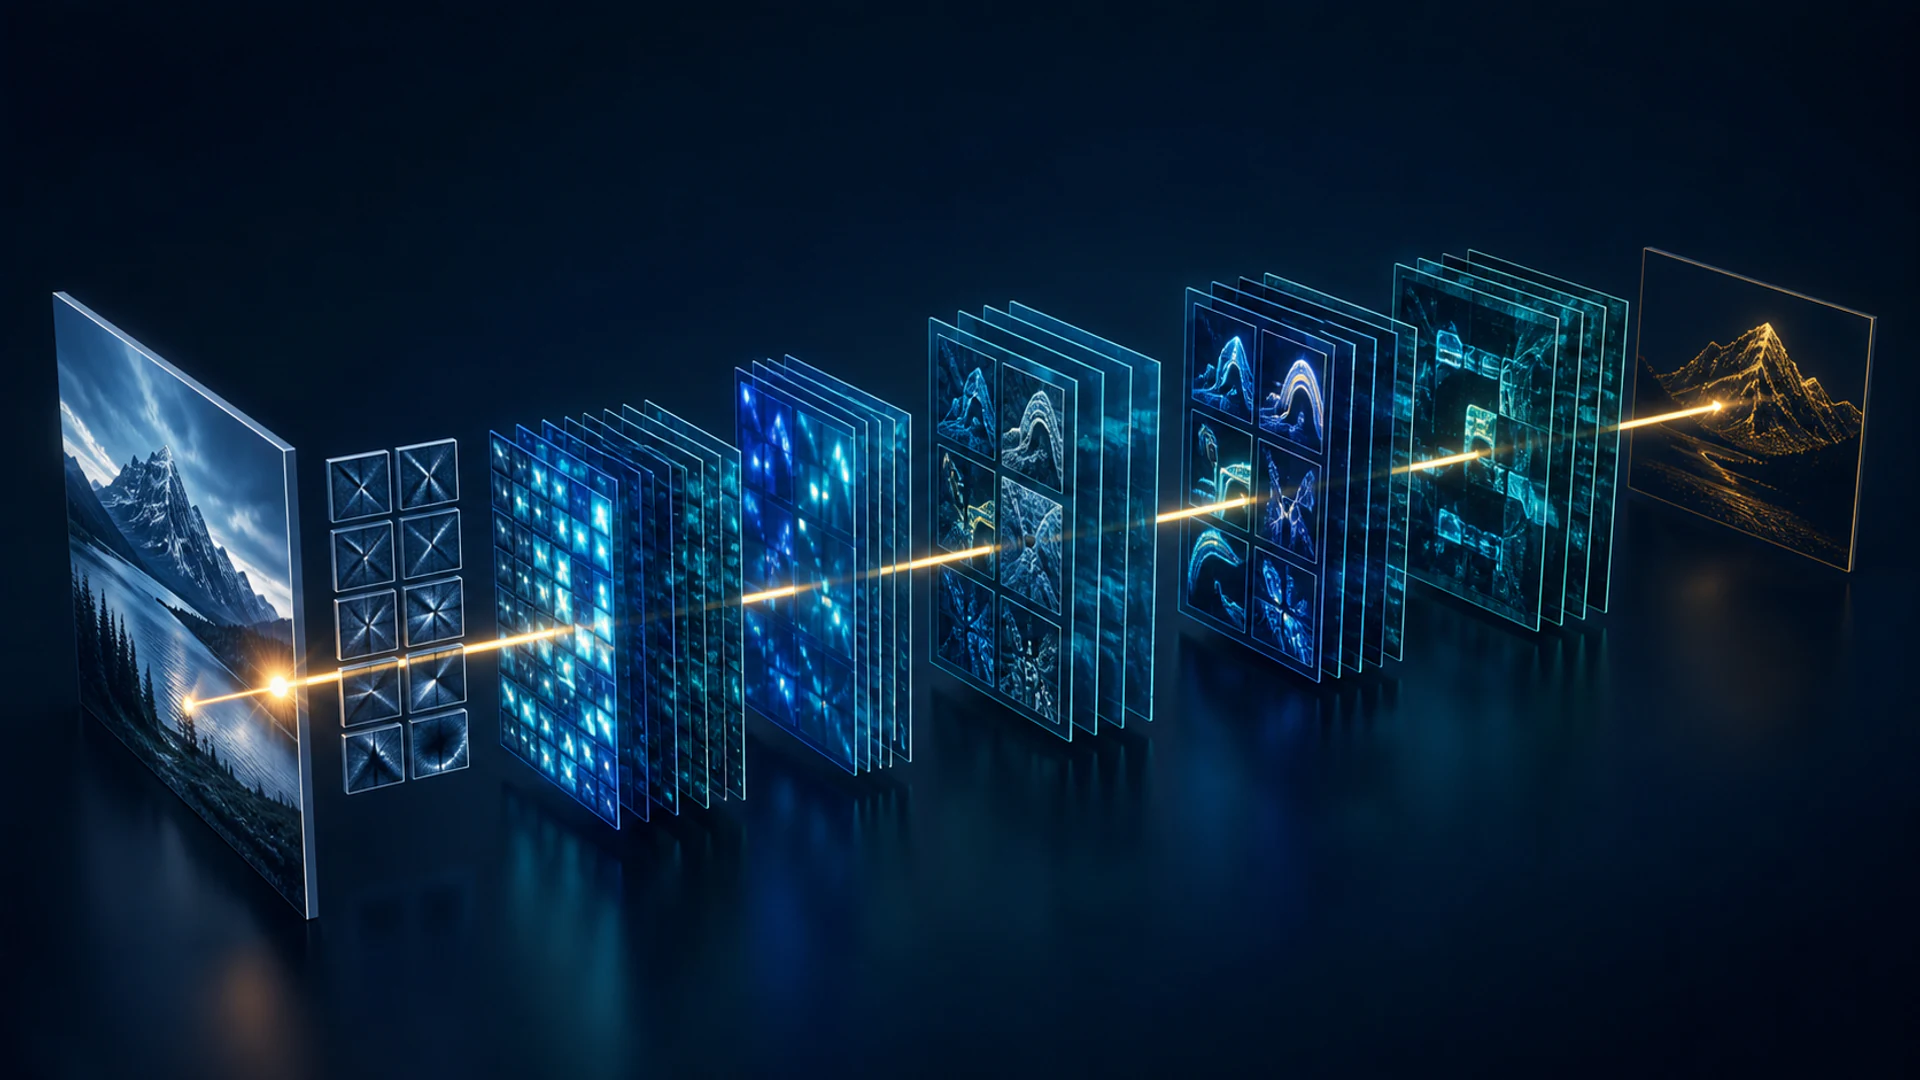
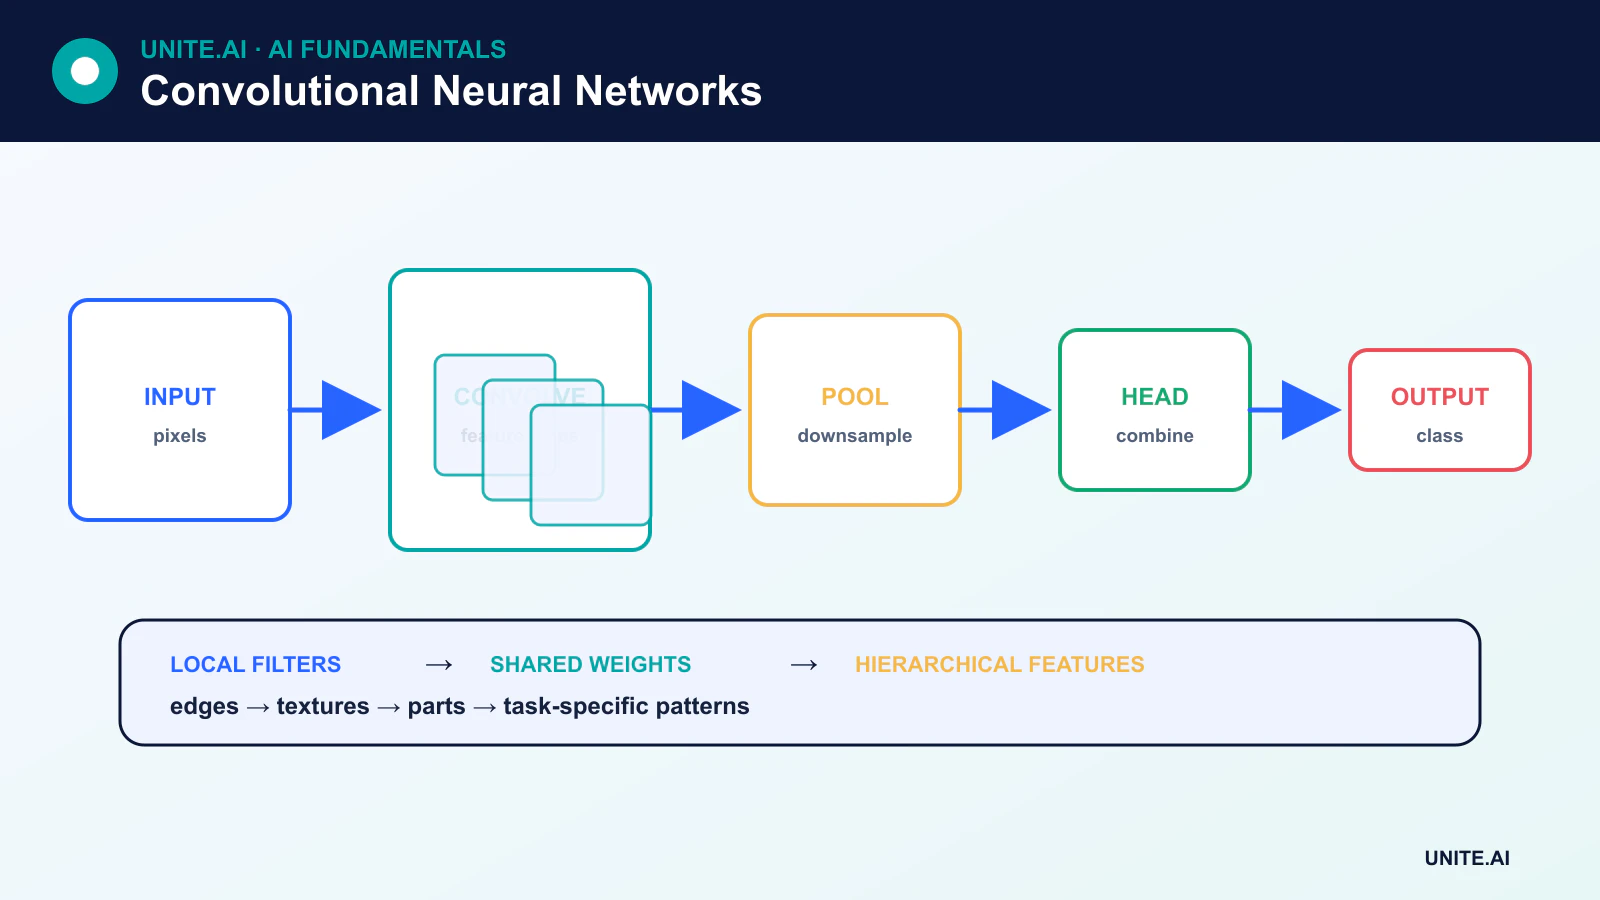
Ett convolutional neural network (CNN) är en neuronnätsarkitektur som använder inlärda filter över lokala regioner av en indata. CNN:er blev grundläggande för modern computer vision eftersom de kan upptäcka mönster oavsett var dessa mönster förekommer och återanvända samma parametrar över en bild.
Ett CNN konverterar inte en bild från icke‑numerisk till numerisk form – bilden kommer redan som en tensor av pixelvärden. Dess syfte är att omvandla den tensorn till feature‑kartor som är användbara för klassificering, detektering, segmentering eller någon annan uppgift.
Viktiga slutsatser
- En konvolution kombinerar lokala inmatningsvärden med ett inlärt kärnfilter för att producera en feature‑karta.
- Stride, padding, dilation och pooling styr den rumsliga upplösningen och det receptiva fältet.
- Viktdelning gör CNN:er mer parametrar‑effektiva än ett fullt anslutet nätverk på råa pixlar.
- Vision‑transformers erbjuder ett alternativ, men CNN:er förblir starka för effektiva och databegränsade system.
Hur konvolution fungerar
Ett kärnfilter är ett litet rutnät av träningsbara vikter. På varje position multiplicerar CNN kärnfiltervärdena med motsvarande inmatningsvärden, summerar resultaten och lägger vanligtvis till ett bias. Att upprepa detta över indata producerar en feature‑karta.
För en färgbild täcker ett kärnfilter alla inmatningskanaler. Ett lager använder flera kärnfilter för att skapa flera utgångskanaler. Under träning beräknar backpropagation gradienter för dessa kärnfiltervikter; konvolutionsoperationen tillverkar inte en ny fast uppsättning vikter för varje bild.
Stride, padding och dilation
- Stride styr hur långt kärnfilteret förflyttas. Ett stride större än ett minskar den rumsliga upplösningen.
- Padding lägger till värden runt en indata så att kantinformation kan bearbetas och utdata‑storleken kan styras.
- Dilation placerar kärnelementen längre ifrån varandra, vilket expanderar det receptiva fältet utan att proportionellt öka antalet parametrar.
Det receptiva fältet är den region av den ursprungliga indata som kan påverka en enhet. Att stapla konvolutioner expanderar det, vilket gör att senare funktioner kan kombinera information från bredare områden.
Aktivering, normalisering och pooling
Konvolutionslager följs vanligtvis av icke‑linjära aktiveringar och normalisering. Pooling sammanfattar lokala regioner med en operation såsom maximum eller medelvärde. Inlärda strided‑konvolutioner kan också nedsampla.
Pooling är inte obligatoriskt. Många moderna nätverk använder global medelvärdes‑pooling nära utdata istället för att platta ut en stor feature‑karta till en fullt ansluten stapel. Detta minskar antalet parametrar och låter nätverket samla rumsliga bevis.
En modern CNN‑arkitektur
En typisk visionmodell innehåller en stam, en sekvens av feature‑block, nedsamplingssteg och ett uppgifts‑huvud. Residuala anslutningar låter ett block lära sig en modifiering av sin indata och ger en direkt väg för information och gradienter. Framgången med residualnätverk gjorde det praktiskt att träna mycket djupare CNN:er.
Klassificeringshuvuden producerar klasspoäng. Detekteringshuvuden förutsäger kategorier och rutor. Segmenteringsarkitekturer lägger till avkodningsvägar som återställer rumslig detalj. Samma CNN‑ryggrad kan återanvändas via transfer learning.
Vad CNN‑lager lär sig
Det är vanligt att visualisera tidiga filter som svarar på kanter eller texturer och senare representationer som korrelerar med delar eller objekt. Detta är en användbar intuition, men det är ingen fast regel. Funktioner beror på uppgift, arkitektur, data, mål och träningsprocess, och vissa enheter kombinerar information som inte tydligt motsvarar ett mänskligt begrepp.
CNN:er kontra vision‑transformers
Vision‑transformers delar upp bilder i patchar och använder attention för att modellera relationer mellan dem. De kan skala effektivt med stora förträningsdatamängder. CNN:er bygger in lokalitet och translationsrelaterade antaganden direkt i arkitekturen, vilket kan göra dem mer effektiva och databegränsade i mindre miljöer.
Många praktiska system kombinerar konvolution och attention. Den rätta arkitekturen beror på noggrannhet, latens, minne, träningsdata, hårdvara och implementering – inte på vilken familj som är den nyaste.
Begränsningar och praktiska överväganden
CNN:er kan vara känsliga för fördelningsförskjutning, adversariella störningar, bakgrundssnabbsökningar och partisk träningsdata. De är inte helt invarianta mot position, rotation, skala eller vyvinkel. Augmentering och arkitekturval kan förbättra robusthet men garanterar inte det.
För implementering bör man mäta end‑to‑end‑latens, minne, genomströmning och beteende i undergrupper. Kvantisering och beskärning kan minska kostnaden, särskilt för edge AI, men komprimerade modeller måste valideras på nytt.
Konvolution, receptiva fält och moderna CNN‑block
Ett konvolutionslager glider inlärda kärnor över ett rutnät och delar vikter över positioner. Kärnstorlek, stride, dilation och padding bestämmer utdataform och receptivt fält. Tidiga lager svarar ofta på lokala kanter eller texturer; djupare lager kombinerar information över större regioner, även om inlärda representationer inte nödvändigtvis motsvarar mänskliga begrepp. Pooling eller strided‑konvolution minskar den rumsliga upplösningen. Kanaler bär feature‑kartor, medan grupperade och depthwise‑separerbara konvolutioner byter kors‑kanalmixning mot lägre beräkningskostnad. Residuala anslutningar gör mycket djupa nätverk enklare att optimera.
För en indatahöjd och -bredd styr padding hanteringen av gränser och stride styr urvalet. Aggressiv nedsampling kan radera små objekt; noll‑padding kan skapa kantartefakter; dilation expanderar kontext utan samma parameterökning men kan ge ett rutnätsmönster. Batch‑normalisering beror på träningsstatistik, medan alternativ kan fungera bättre vid små batch‑storlekar. Moderna arkitekturer kombinerar flaskhalsar, multi‑scale‑funktioner, attention eller inverterade residualer. Välj arkitektur baserat på uppgiftsupplösning, minnesbandbredd, latens och mål‑hårdvara snarare än enbart bildklassificeringsnoggrannhet.
Träning, tolkning och implementering
Använd augmenteringar som bevarar etiketter och speglar verklig variation, och dela upp efter subjekt eller scen innan augmentering. Transfer learning är vanligt: ersätt uppgifts‑huvudet, träna det, och lås sedan försiktigt upp ryggraden. Utvärdera klass‑specifik prestanda, kalibrering, robusthet mot suddighet, komprimering, belysning, skala, beskärning och adversariella störningar. Visualiseringsmetoder såsom feature‑kartor och salienser kan avslöja genvägar, men de är känsliga för metod och referens. Bekräfta misstänkt beroende med kontrafaktiska bilder, ocklusionstester eller dataset‑ändringar.
Exporterade CNN:er kan slås ihop, kvantiseras eller kompileras för GPU, NPU, webbläsare eller mikrokontroller. Validera den implementerade grafen, inklusive för‑ och efterbehandling, på exakt utrustning. Mät end‑to‑end‑latens, minne, energi och termiskt beteende; indata‑avkodning kan dominera en liten modell. Övervaka kamera‑ och bildstatistik, utdata‑distribution och bekräftade fel. Signerade modell‑artefakter, skyddade uppdateringskanaler och elegant sensorsvikt är en del av produktionsdesignen. CNN:er kodar en användbar lokalitetsbias, men de förstår inte automatiskt objekt eller kausala scener.
Arbetsexempel: implementering av ett CNN på en inspektionskamera
Ett CNN klassificerar ytfel från högupplösta linjeskanningsbilder. Ingenjörer mosaikerar bilder med överlappning så att små fel överlever nedsampling, bevarar koordinater för granskning och validerar augmenteringar mot verklig optisk variation. Ett residual‑CNN och en lättare depthwise‑modell jämförs vid lika återkallelse. Tester inkluderar kantdefekter, bländning, komprimering, rörelse, materialbatcher och kamerabyte, med oberoende produktionslotter reserverade för slutlig utvärdering.
Kompilering slår ihop och kvantiserar modellen för en edge‑accelerator, men den implementerade grafen jämförs med referensen på känsliga defekttillfällen. Avkodning, mosaikering, inferens och sammanslagningslatens mäts end‑to‑end. Systemet flaggar döda pixlar och exponering‑drift separat från produktdefekter. Operatörer kan inspektera källmosaiker och åsidosätta resultat. Modell‑ och kameraförändringar rullas ut gradvis, och linjen behåller en säker manuell inspektionsprocedur när vision‑pipen är otillgänglig.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera de avsedda användarna, driftmiljön, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsförskjutning, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regel‑version, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policys, hårdvara eller mål förändras. Ett underhållet system behöver även dokumenterad återställning, incident‑lärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Behöver ett CNN alltid pooling?
Nej. Ett CNN kan nedsampla med strided‑konvolution och kan bevara upplösning för tät prediktion. Pooling är ett designverktyg snarare än ett definierande krav.
Är CNN‑filter hand‑designade?
I ett tränat CNN lärs kärnvärden normalt in från data. Detta skiljer sig från klassiska vision‑filter vars koefficienter väljs i förväg för operationer såsom kantdetektering.
Primära referenser












