
Grunderna i AI
Vad är RNN:er och LSTM:er i djupinlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Recurrent neural networks (RNNs) bearbetar sekvenser genom att uppdatera ett dolt tillstånd över tid. Long short-term memory (LSTM)-nätverk är gateade RNN:er som är utformade för att bevara och kontrollera information mer effektivt än en grundläggande återkommande enhet.
RNN:er och LSTM:er dominerade tidigare många språkuppgifter, men moderna stora chattbotar är främst baserade på transformers. Återkommande modeller är fortfarande användbara för strömning, tidsserier, tal, styrning och resurssvaga system där inkrementellt tillstånd och låg latens är viktiga.
Viktiga slutsatser
- En RNN återanvänder samma parametrar vid varje sekvenssteg och för vidare ett dolt tillstånd.
- Träning över tid kan leda till försvinnande eller exploderande gradienter.
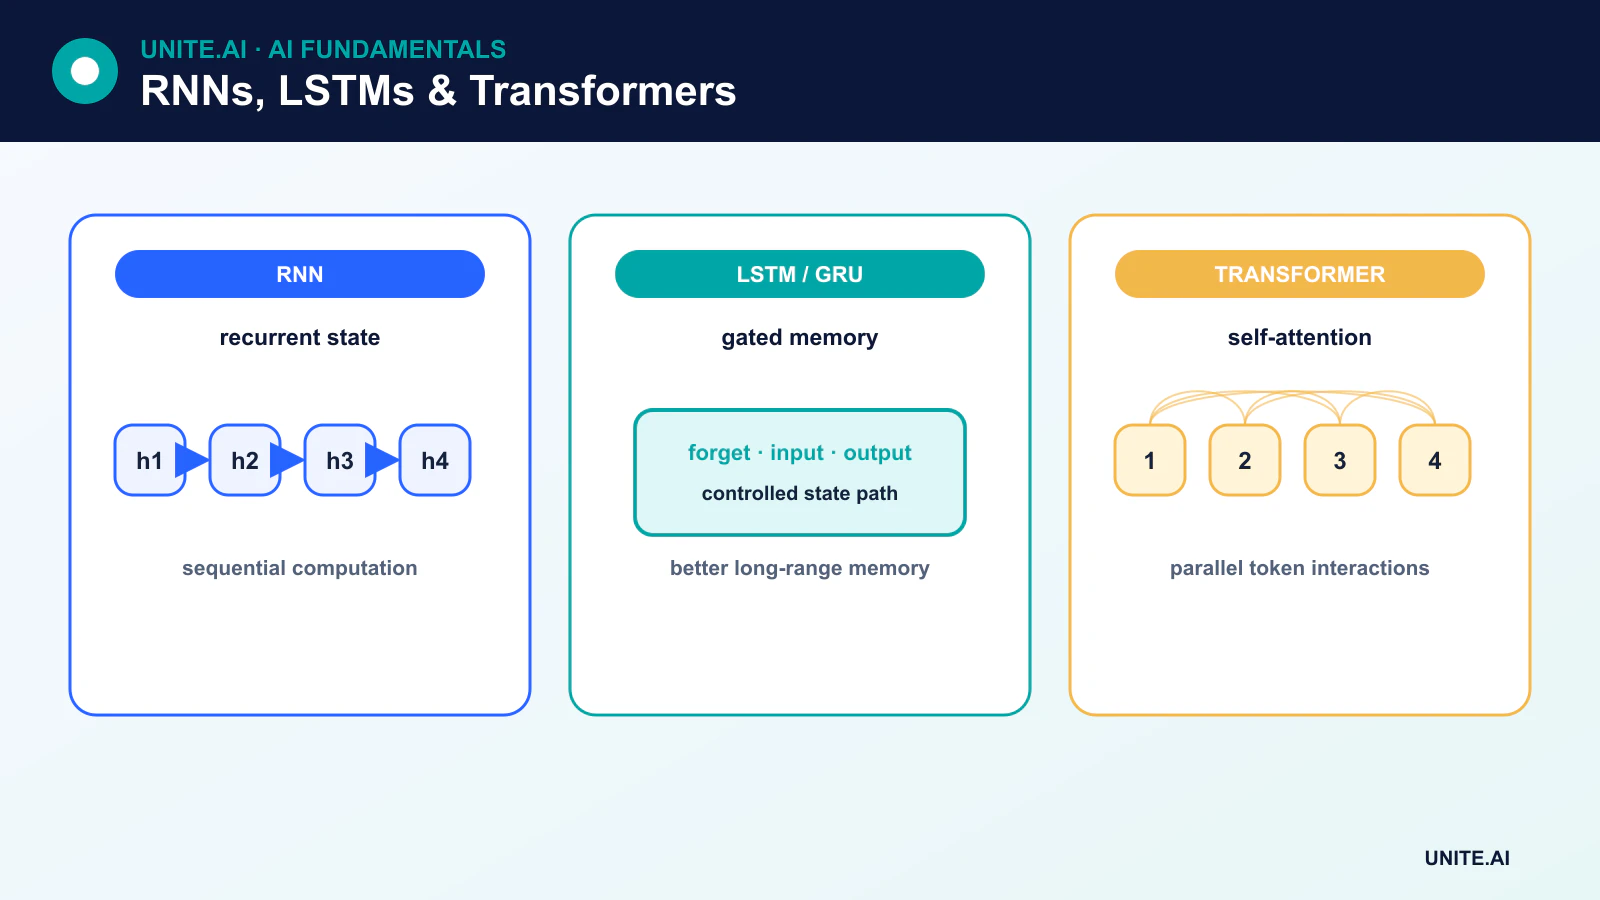
- En LSTM lägger till ett celltillstånd samt in-, glömske- och utgångsgates.
- Transformatorer hanterar långdistansrelationer och parallell träning på ett annat sätt; ingen av arkitekturerna är bäst för varje implementering.
Hur en grundläggande RNN fungerar
Vid steg t kombinerar en enkel återkommande enhet den aktuella indatan xₜ med föregående dolda tillstånd hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Det dolda tillståndet är en inlärd sammanfattning som används för nästa steg och, beroende på uppgift, ett utdata. Ett “unrullat” diagram ritar en kopia per tidssteg, men alla kopior delar parametrar. Utdata kopieras inte enkelt tillbaka som ny råindata; återupprepningen för vidare det dolda tillståndet genom en definierad transformation.
Bakåtspridning genom tid
RNN:er tränas med backpropagation through time (BPTT). Den unrullade sekvensen bildar ett djupt beräkningsgraf, och backpropagation beräknar hur förlusten beror på de delade återkommande parametrarna.
Upprepad multiplikation kan få gradienter att krympa mot noll eller växa utan gräns. Försvinnande gradienter hindrar inlärning av långa beroenden; exploderande gradienter ger instabila uppdateringar. Gradientklippning motverkar exploderande gradienter, medan gating, initiering, normalisering och kortare träningsfönster kan hjälpa.
Inuti en LSTM-cell
En LSTM upprätthåller ett celltillstånd cₜ utöver det dolda tillståndet hₜ. Dess gates är inlärda, datadrivna styrningar:
- Glömskegaten styr hur mycket av föregående celltillstånd som behålls.
- Ingångsgaten styr hur mycket kandidatinformation som skrivs.
- Utgångsgaten styr hur mycket cellinformation som bidrar till det dolda tillståndet.
Sigmoid-utgångar mellan noll och ett fungerar som mjuka gates, medan en tanh‑transformerad kandidat levererar nytt innehåll. Den additiva celltillståndsvägen hjälper gradienter att bestå, men LSTM:er garanterar inte obegränsat minne eller eliminerar alla optimeringsproblem.
GRU:er och bidirektionell återupprepning
En gated recurrent unit (GRU) kombinerar gate‑mekanismer i en enklare återkommande cell utan ett separat LSTM‑likt celltillstånd. GRU:er kan tränas snabbare och prestera liknande på vissa uppgifter.
En bidirektionell RNN bearbetar en färdig sekvens i båda riktningarna och kombinerar tillstånden. Den kan använda framtida kontext för märkning eller kodning, men är olämplig för kausal strömning när framtida indata ännu inte är tillgängliga.
Sekvens‑till‑sekvens-modeller
Encoder‑decoder‑RNN:er mappar en sekvens till en annan. Uppmärksamhet infördes för att låta en decoder konsultera olika encoder‑tillstånd istället för att förlita sig på en enda fast vektor. Detta forskningsspår ledde till transformer‑arkitekturen, som ersatte återupprepning med uppmärksamhetsbaserade block.
RNN:er kontra transformatorer
Transformatorer bearbetar träningspositioner parallellt och skapar korta uppmärksamhetsvägar mellan avlägsna token. RNN:er bearbetar tillstånd sekventiellt, vilket begränsar parallellism men erbjuder ett återkommande tillstånd av konstant storlek under strömning. Transformer‑inferens kan kräva en växande nyckel‑värde‑cache, medan en RNN komprimerar historik i sitt dolda tillstånd och kan förlora detaljer.
Välj baserat på sekvenslängd, datamängd, hårdvara, latens, minne och om uppgiften är offline eller strömmande. Hybrid‑ och tillståndsrymdsarkitekturer ger ytterligare avvägningar.
Aktuella användningsområden
RNN:er och LSTM:er är fortfarande relevanta för prognostisering, avvikelsedetektion, sensordata‑behandling, talkomponenter, handskrift, inbäddad styrning och låg‑latens sekvensmodellering. De är inte den vanliga förklaringen för dagens stora språkmodeller eller AI‑chattbotar.
Återupprepning, gates och sekvensminne
Ett återkommande neuralt nätverk bearbetar en sekvens genom att kombinera den aktuella indatan med ett dolt tillstånd som föras från tidigare steg. Delade vikter möjliggör variabel sekvenslängd, och unrullning exponerar beräkningen över tid för träning. Grundläggande RNN:er kan representera temporellt beroende men gradienter som multipliceras upprepade gånger över långa sekvenser tenderar att försvinna eller explodera. Avkortad bakåtspridning begränsar minne och beräkning, medan gradientklippning kontrollerar extrema uppdateringar. Det dolda tillståndet är en inlärd sammanfattning, inte en trogen lagring av varje tidigare token.
Long short-term memory‑nätverk lägger till ett celltillstånd samt in‑, glömske‑ och utgångsgates som reglerar skrivning, bevarande och exponering av information. Gated recurrent units använder en enklare återställnings‑ och uppdateringsstruktur. Bidirektionella varianter använder framtida kontext och kan därför inte strömma kausalt utan fördröjning. Staplade, residuala och uppmärksamhets‑förstärkta återkommande modeller ökar kapaciteten. Utfyllnad och masker måste förhindra att artificiella sekvenselement påverkar tillstånd eller förlust, och tillstånd bör återställas vid verkliga sekvensgränser för att undvika läckage mellan exempel.
Träning, jämförelse och tillståndsbaserad servering
RNN:er och LSTM:er är fortfarande användbara för strömning, kompakta modeller på enhet, tidsserier och arbetsbelastningar där sekventiellt tillstånd är effektivt. Transformatorer parallelliserar träning och modellerar långdistansinteraktioner på ett annat sätt men kan kräva mer minne och cache. Jämför arkitekturer på noggrannhet, latens, genomströmning, minne, energi och prestanda när sekvenslängden förändras. Utvärdera prognostisering med rullande tidsdelningar, språk med sekvensmedvetna mått och avvikelsedetektion med händelsenivåmått. Undersök fel efter långa luckor, regimförändringar, saknade prover och plötsliga sekvensgränser.
Tillståndsbaserad driftsättning måste koppla det dolda tillståndet till rätt session, låta det gå ut, kryptera det om det är känsligt och återställa det efter fel eller modelländringar. Oordnade eller duplicerade händelser kan förstöra tillståndet; inkludera tidsstämplar, sekvensnummer och idempotens. Övervaka tillståndets ålder, sekvenslängd, saknade data, utskriftsdrift och latens. Kvantisering kräver gate‑känslig validering eftersom små numeriska förändringar kan ackumuleras över tid. RNN‑minne möjliggör kontext, men det kan också bevara privat eller föråldrad information, så lagring och användarkontroller bör ingå i designen.
Arbetsexempel: en LSTM för strömmande sensorssekvenser
En tjänst använder en LSTM för att förutsäga korttidsbelastning utifrån senaste mätningar, kalender och väder. Sekvenser byggs med strikt tidsordning; dolt tillstånd återställs vid matningsgränser, och utfyllnad maskeras. Säsongs‑naiva och gradient‑förstärkta baslinjer jämförs med LSTM över rullande fönster. Tester omfattar saknade intervaller, fördröjt väder, helgdagar, strömavbrott och sekvenslängder som överstiger vanlig träning.
Strömningstjänsten kopplar tillstånd till en matning, avvisar oordnade dubletter och låter tillstånd gå ut efter långa luckor eller modelluppdateringar. En säker statistisk prognos ersätter utdata när sensorer eller tillstånd är ogiltiga. Kvantiserad inferens kontrolleras över långa sekvenser för ackumulerad drift. Övervakning spårar tillståndets ålder, saknade data, latens, bias och intervallfel. Modellen återtränas endast efter nätändringar och granskade resultat visar att de inlärda tidsmässiga relationerna inte längre generaliserar.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning före finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning i stället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incident‑lärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är en LSTM alltid bättre än en grundläggande RNN?
Nej. Gating hjälper många problem med långa beroenden men ökar beräkning och parametrar. En grundläggande RNN kan vara tillräcklig för korta, enkla sekvenser, och en annan arkitektur kan vara bättre för mycket lång kontext.
Kan en LSTM bearbeta en obegränsad historik?
Nej. Dess tillstånd har begränsad kapacitet, gradienter och träningsdata sätter gränser, och relevanta detaljer kan skrivas över. Prestanda för lång kontext måste mätas snarare än att antas utifrån arkitekturens namn.
Primära referenser












