
Grunderna i AI
Hur fungerar textklassificering?

 Lägg till Unite.AI bland dina föredragna källor på Google
Textklassificering tilldelar en eller flera etiketter till ett dokument, ett meddelande eller ett textavsnitt. Exempel inkluderar skräppostdetektering, avsiktsdirigering, sentimentanalys, ämnesmärkning, moderering och prioritering av supportärenden.
En produktionsklassificerare är mer än en modell. Den bygger på en exakt etikett‑taxonomi, representativa annoteringar, läckagesäkra uppdelningar, en kalibrerad beslutsregel och övervakning av förändrat språk och klassförekomst.
Viktiga slutsatser
- Definiera etiketter och tvetydiga fall innan du väljer en arkitektur.
- Enkla bag‑of‑words‑baslinjer är fortfarande värdefulla; förtränade kodare tillför kontext och överföringsinlärning.
- Noggrannhet kan dölja dålig prestanda för minoritetsklasser, så använd klassmedvetna mått och felanalys.
- Sannolikhetskalibrering, avstående och mänsklig granskning omvandlar poäng till säkrare beslut.
Definiera taxonomi och annoteringspolicy
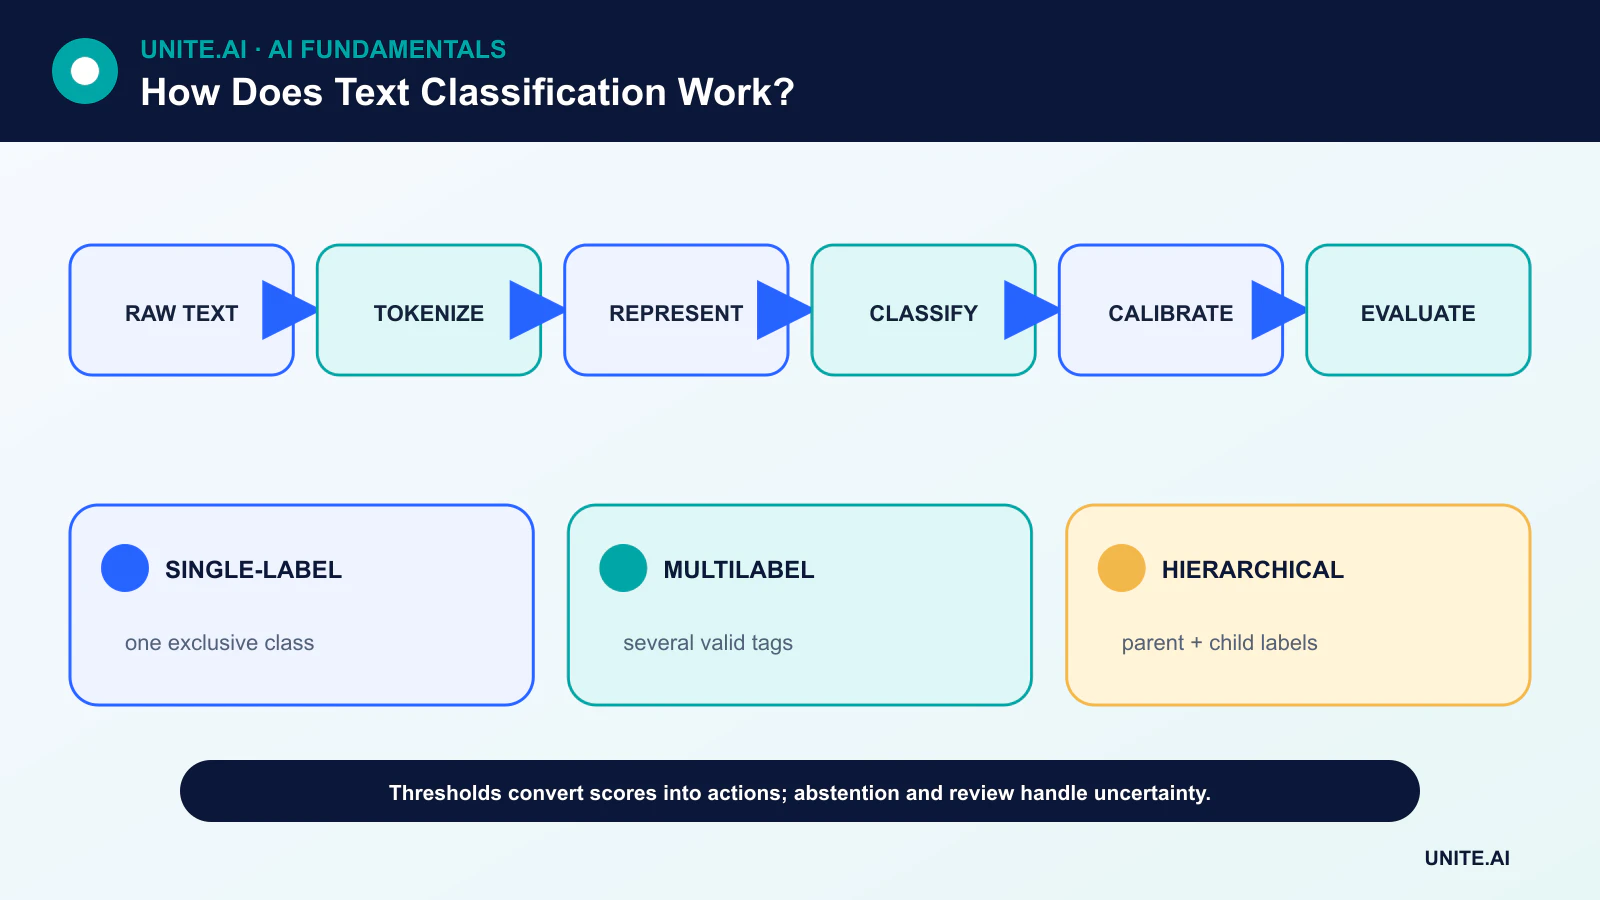
En enkel‑etikett‑uppgift väljer en ömsesidigt uteslutande klass. En flertag‑uppgift kan tilldela flera oberoende taggar. Hierarkiska taxonomier innehåller föräldra‑ och barnetiketter. Dessa är olika inlärningsproblem och kräver olika utdata och mått.
Annotatörer behöver definitioner, positiva och negativa exempel, regler för saknad kontext samt en eskaleringsväg. Enighetsstatistik kan avslöja en otydlig uppgift, men oenighet kan också representera verklig tvetydighet som systemet bör bevara.
Representera text
Traditionella pipeline‑ar använder tokenräkningar, n‑gram och TF‑IDF med linjära klassificerare eller supportvektormaskiner. De tränas snabbt, visar inflytelserika termer och ger en stark baslinje.
Neurala system mappar token till inbäddningar. Förtränade transformer‑kodare använder uppmärksamhet för att producera kontextuella representationer och kan finjusteras med märkta exempel. Promptade eller zero‑shot‑klassificerare kan minska den initiala märkningen, men deras etikettformulering, modellversion och kalibrering måste utvärderas på den faktiska domänen.
Träning utan läckage
Datamängden delas upp i tränings‑, validerings‑ och sluttestdata. Nära dubblett‑dokument, meddelanden från samma konversation eller mallar från samma källa bör ligga i samma delning. För tidsberoende användning representerar en kronologisk uppdelning implementeringen bättre.
Klassobalans kan hanteras genom viktning, omprovtagning, tröskelval eller extra data. Syntetiska exempel bör inte ersätta granskning av verkliga misslyckanden i minoritetsklasser och kan introducera artefakter som modellen lär sig för lätt.
Mått och kalibrerade beslut
En förvirringsmatris visar vilka etiketter som förväxlas. Precision mäter hur många förutsagda positiva som är korrekta; recall mäter hur många sanna positiva som hittas. Makro‑genomsnitt väger klasser lika, medan mikro‑genomsnitt väger enskilda exempel.
En rå softmax‑poäng är inte automatiskt en pålitlig sannolikhet. Kalibrering jämför förtroende med observerad korrekthet. Team kan sätta klass‑specifika trösklar, avstå när förtroendet är lågt och dirigera känsliga fall till en granskare.
Implementering, flerspråkig användning och drift
Text förändras med produkter, händelser, slang och motståndarskap. Övervakning bör spåra inmatningsspråk, längd, out‑of‑vocabulary‑mönster, klassfrekvenser, förtroende och fördröjda resultat. Omlärning kräver versionerad data och en regressionssvit med viktiga exempel.
Flerspråkig prestanda måste testas per språk och dialekt. Att översätta allt till ett språk kan förändra sentiment eller entiteter; en flerspråkig kodare kan fortfarande prestera ojämnt eftersom dess förträning och etiketter inte är lika representativa.
Representationer och klassificeringsfamiljer
Textklassificering mappar ett dokument, en mening eller en tokensekvens till en eller flera etiketter. Definiera om etiketter är ömsesidigt uteslutande, flertag, hierarkiska, ordnade eller öppna. Traditionella pipeline‑ar tokeniserar text, bygger bag‑of‑words‑ eller TF–IDF‑funktioner och tränar logistisk regression, Naïve Bayes eller en linjär SVM. Neurala system lär sig inbäddningar med konvolution, återkoppling eller transformatorer. Promptade språkmodeller kan klassificera utan uppgiftsspecifik träning, men utdata‑restriktioner, kostnad, drift och bevis kräver fortfarande utvärdering mot enklare baslinjer.
Förbehandling beror på representationen. Nedrullning till gemener eller borttagning av skiljetecken kan förstöra signaler för namn, sentiment, kod eller språk; stemming kan slå samman olika betydelser. Transformer‑tokenizers arbetar på subord och har längdgränser, så trunkeringsstrategi är viktig. Långa dokument kan kräva uppdelning och aggregation. Bevara den råa texten och transformationsversionen, och dela efter författare, konversation, källa eller tid för att förhindra nära dubbletter och återkommande mallar från att korsa tränings‑ och testuppsättningar.
Etiketter, mått och felanalys
En annoteringsguide bör definiera omfång, exempel, tvetydiga fall och ett alternativ för okänt eller avstående. Mät enighet och avgör oenighet snarare än att dölja den med majoritetsröstning. För obalanserade klasser är noggrannhet otillräcklig; rapportera precision, recall, F1, förvirring, kalibrering och tröskel‑specifik arbetsbelastning per klass. Flertag‑uppgifter behöver mikro‑, makro‑ och etikett‑nivåmått. Utvärdera språk, dialekter, domäner, meddelandelängd och tid. En slumpmässig uppdelning kan överskatta kvalitet när vokabulär eller mallar drifter.
Felanalys bör separera representationsfel, otillräcklig kontext, etikett‑tvetydighet, sällsynt vokabulär, negation, sarkasm och falska ledtrådar. Använd kontrafaktiska tester som ändrar namn, dialektmarkörer eller irrelevant metadata samtidigt som betydelsen bevaras. Inspektera misstag med högt förtroende och avvisade fall. En modell kan lära sig att en kundkanal eller signatur förutsäger en etikett snarare än att tolka innehållet. Ta bort läckage och revidera data innan du bara ökar modellkapaciteten.
Produktionsdesign
Tillhandahåll en fast tokeniserare och modell med schemavalidering, längdgränser, batchning och en reservlösning för språk som inte stöds eller lågt förtroende. Övervaka indatafördelning, etikettfrekvenser, kalibrering, latens och granskade resultat. Skydda text eftersom den kan innehålla personliga, konfidentiella eller motstridiga instruktioner. För automatiserad moderering, behörighet eller dirigerning, erbjud möjlighet till överklagande och mät olika fel. Versionera etiketter och trösklar enligt affärspolicy. Textklassificering är pålitlig endast inom sitt definierade etikett‑system och datadistribution; flytande modellförklaringar bevisar inte att en klassificering är korrekt.
Arbetsexempel: klassificering av inkommande supportförfrågningar
Ett supportteam definierar ömsesidigt uteslutande dirigeringsetiketter samt flaggor för brådskande, flerspråkiga och okända ärenden. Annotatörer märker av‑identifierade meddelanden med vägledning för blandade problem och mäter enighet. En TF–IDF‑logistisk baslinje, finjusterad kodare och promptad modell använder samma tidsbaserade testuppsättning. Utvärderingsrapporten visar klass‑precision och recall, brådskande falska negativa, kalibrering, schemavaliditet, latens och kostnad, med nära dubblett‑mallar grupperade för att undvika läckage.
Den implementerade klassificeraren validerar språk och längd, avstår vid svaga bevis och låter agenter korrigera rutter. Promptar och meddelanden behandlas som opålitliga; verktygsåtkomst saknas. Övervakning spårar etikett‑förekomst, förtroende, korrigering, svarstid och framväxande ämnen. En policy‑ eller produktändring uppdaterar taxonomin och omlärningsdata genom granskning. Systemet förbättrar köplacering, men det härleder aldrig kundens känslor eller anspråk utöver de validerade etiketterna.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning före finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela befogenhet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reservlösning och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larm‑trösklar och en ansvarig för svar, granska sedan verkliga bevis efter implementering istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incident‑lärande, raderings‑ och behållningsrutiner samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är sentimentanalys en textklassificeringsuppgift?
Vanligtvis ja, men sentiment kan vara flertag, aspektbaserat eller kontinuerligt snarare än en enda positiv/neutral/negativ etikett.
När bör en textklassificerare avstå?
När förtroendet är lågt, texten ligger utanför scope, nödvändig kontext saknas eller kostnaden för en felaktig automatisk åtgärd överstiger kostnaden för granskning.
Primära referenser












