
Grunderna i AI
Vad är en förvirringsmatris?

 Lägg till Unite.AI bland dina föredragna källor på Google
En förvirringsmatris är en tabell som räknar hur ofta en klassificerares förutsägelser överensstämmer eller avviker från kända etiketter. Den visar vilka klasser som förväxlas och tillhandahåller räkningarna som används för att beräkna mått såsom precision, återkallelse, specificitet och F1. Den är ett av de grundläggande diagnostiska verktygen för övervakad inlärning klassificeringsproblem.
Matrisen i sig är inte ett enskilt prestationsmått. Den är en strukturerad vy av utfall vid en viss beslutsgräns, dataset och klassdefinition.
Viktiga slutsatser
- För binär klassificering är de fyra utfallen sann positiv, falsk positiv, falsk negativ och sann negativ.
- Etikettsera alltid axlarna: bibliotek och publikationer placerar inte alltid faktiska och förutsagda klasser i samma orientering.
- Noggrannhet kan dölja allvarliga fel när klasserna är obalanserade.
- Att ändra klassificeringströskeln förändrar förvirringsmatrisen och avvägningen mellan precision och återkallelse.
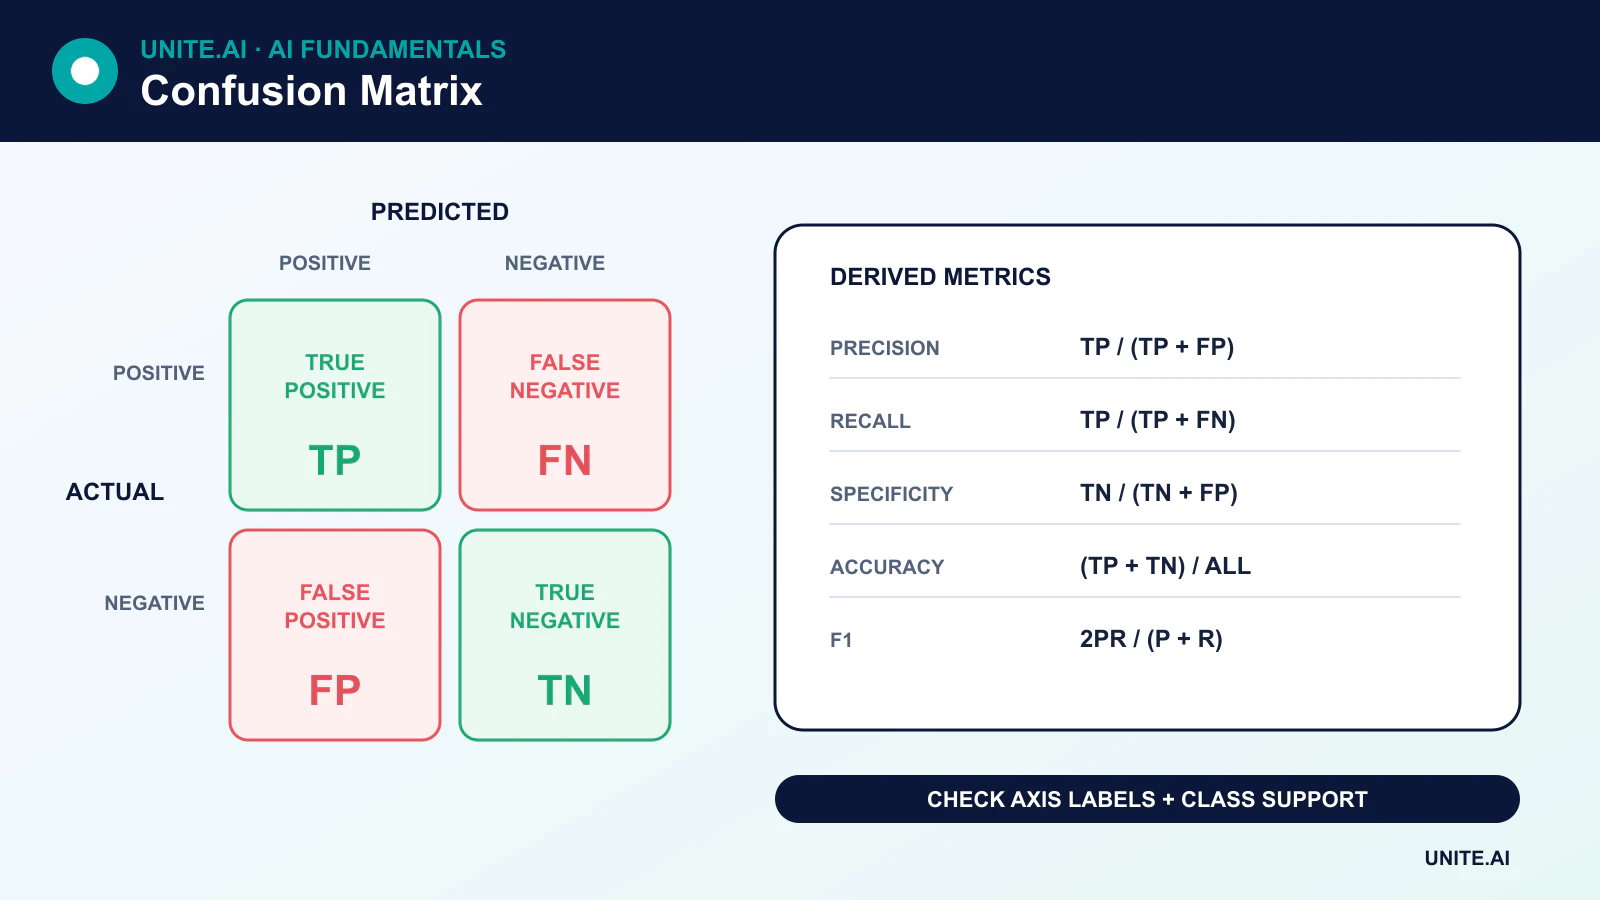
De fyra utfallen för binär klassificering
- Sann positiv (TP): exemplet är positivt och modellen förutsäger positivt.
- Falsk positiv (FP): exemplet är negativt men modellen förutsäger positivt.
- Falsk negativ (FN): exemplet är positivt men modellen förutsäger negativt.
- Sann negativ (TN): exemplet är negativt och modellen förutsäger negativt.
I scikit-learns konvention är raderna sanna klasser och kolumnerna förutsagda klasser. Andra visualiseringar kan transponera denna ordning, så etiketterna – inte hörnpositionerna – bör styra tolkningen.
Mått härledda från en förvirringsmatris
Precision
Precision = TP / (TP + FP)
Precision svarar: bland exempel som förutsägs som positiva, vilken andel var faktiskt positiv?
Återkallelse eller sensitivitet
Recall = TP / (TP + FN)
Återkallelse svarar: bland alla faktiska positiva exempel, vilken andel identifierade modellen? Vid binär klassificering kallas återkallelse för den positiva klassen också för sensitivitet eller sann‑positiv‑frekvens.
Specificitet
Specificity = TN / (TN + FP)
Specificitet är återkallelse för den negativa klassen: bland faktiska negativa, vilken andel avvisade modellen korrekt?
Accuracy
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Noggrannhet är användbart när klasser och felkostnader är rimligt balanserade. Det kan vara missvisande när en klass dominerar.
F1‑poäng
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 sammanfattar precision och återkallelse med ett harmoniskt medelvärde. Den ignorerar sanna negativa, så den är inte den rätta sammanfattningen för varje uppgift.
Ett praktiskt exempel
Anta att ett testset innehåller 1 000 transaktioner. Femtio är bedrägliga. En modell hittar 40 av dessa bedrägerier men flaggar 30 legitima transaktioner:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Modellen har 96 % noggrannhet, men dess precision är omkring 57 % och återkallelse 80 %. Den höga noggrannheten drivs i stor utsträckning av de många legitima transaktionerna. Om modellen är acceptabel beror på kostnaden för missade bedrägerier, undersökningskapacitet och hur kalibrerade dess riskpoäng är.
Trösklar förändrar matrisen
Många klassificerare ger ett poängvärde snarare än ett oundvikligt ja/nej‑svar. Att sänka den positiva tröskeln ökar generellt återkallelse och falska positiva; att höja den ökar generellt precision eller specificitet samtidigt som fler positiva missas. Tröskeln bör väljas med hjälp av valideringsdata och verkliga felkostnader, inte automatiskt fixeras till 0,5.
Precision‑recall‑ och ROC‑kurvor sammanfattar prestanda över trösklar. Precision‑recall‑kurvor är ofta mer informativa när den positiva klassen är sällsynt.
Multiklass‑förvirringsmatriser
För K klasser är matrisen K × K. Korrekt förutsägelser ligger på diagonalen; celler utanför diagonalen visar vilka klasspar som förväxlas. Per‑klass‑mått kan medelvärdesberäknas på olika sätt:
- Makro‑medelvärde: ger varje klass lika vikt.
- Viktat medelvärde: väger varje klass efter antalet exempel.
- Mikro‑medelvärde: aggregerar utfallsräkningar innan måttet beräknas.
Att rapportera endast ett medelvärde kan dölja dålig prestanda på mindre klasser. Inkludera stöd‑räkningar och per‑klass‑resultat där skillnaderna är viktiga.
Vanliga misstag
- Läsa en transponerad matris utan att kontrollera axel‑etiketterna.
- Beräkna mått från träningsdata istället för en lämplig håll‑ut‑uppsättning.
- Ignorera klass‑prevalens, urvalsstrategi eller duplicerade enheter över delningar.
- Jämföra matriser som producerats vid olika trösklar utan att notera förändringen.
- Behandla alla falska positiva och falska negativa som lika kostsamma.
En förvirringsmatris är därför ett diagnostiskt verktyg, inte en fullständig utvärdering. Kalibrering, subgruppsanalys, robusthet och efterföljande konsekvenser bör också ingå i en klassificeringsgranskning.
Läsa varje cell och härleda användbara mått
För binär klassificering räknar förvirringsmatrisen sanna positiva, falska positiva, falska negativa och sanna negativa för en vald positiv klass och tröskel. Noggrannhet delar korrekta förutsägelser med alla fall; precision frågar vilken andel av de förutsagda positiva som var korrekta; återkallelse frågar vilken andel av de faktiska positiva som hittades; specificitet mäter faktiska negativa som korrekt avvisades. F1 är det harmoniska medelvärdet av precision och återkallelse. Inget är i sig bäst: bedrägeridetektion, medicinsk triage och skräppostfiltrering tilldelar olika konsekvenser till samma celler.
För flerklassproblem representerar rader vanligtvis faktiska klasser och kolumner förutsagda klasser, även om konventionerna varierar, så etiketter måste vara tydliga. One‑vs‑rest‑räkningar ger per‑klass‑precision och återkallelse. Makro‑medelvärde väger klasser lika; mikro‑medelvärde aggregerar beslut och gynnar vanliga klasser; viktat medelvärde följer klass‑stöd. Multilabel‑uppgifter tillåter flera etiketter per objekt och kräver etikett‑ eller prov‑specifika definitioner. Normalisera efter rad för att undersöka återkallelsemönster eller efter kolumn för att undersöka förutsägelse‑sammansättning, men behåll råa räkningar så att sällsynta grupper inte förstoras visuellt.
Trösklar, osäkerhet och operativa beslut
En förvirringsmatris sammanfattar hårda beslut vid en tröskel. Använd precision‑recall‑ eller ROC‑kurvor för att jämföra trösklar och välj sedan en driftpunkt baserat på kapacitet, prevalens och felkostnad. Kalibrering frågar om de förutsagda sannolikheterna matchar observerad frekvens och är separat från rangordning. När prevalensen förändras kan precisionen förändras även om sensitivitet och specificitet förblir stabila. Rapportera konfidensintervall eller bootstrap‑variation och undvik att dra slutsatser från ett fåtal fel i en liten subgrupp.
Granska matriser efter tid, plats, enhet, språk och relevanta drabbade grupper för att hitta koncentrerade fel. Jämför modellen med den befintliga beslutsprocessen, inklusive mänsklig granskning. För kedjor, registrera fel i varje steg: hämtning, klassificering, tröskling och åtgärd. Övervaka levande resultat‑etiketter med deras fördröjning och korrigeringsprocess. En till synes förbättrad F1 kan fortfarande öka skadliga falska negativa eller överskrida granskningskapaciteten. Förvirringsmatrisen är en beslutsbok; koppla varje cell till vem som drabbas av felet och vilken respons som följer.
Praktiskt exempel: välja en medicinsk screenings‑tröskel
En maskininlärnings‑screeningsmodell ger ett riskpoäng för ett tillstånd med låg prevalens. Teamet skapar förvirringsmatriser över olika trösklar och rapporterar sensitivitet, specificitet, precision, falska remisser och missade fall med konfidensintervall. Eftersom positivt prediktivt värde beror på prevalens modellerar det den avsedda populationen snarare än att citera en datasets precision. Resultaten segmenteras efter enhet, plats, ålder, kön och andra kliniskt motiverade grupper.
Kliniker väljer en driftspunkt som bevarar erforderlig sensitivitet utan att överbelasta bekräftande tester. Matrisen omvandlas till förväntade räkningar per 10 000 screenade personer så att konsekvenserna blir begripliga. Poäng utanför validerade förhållanden ger ingen automatiserad slutsats. Övervakning jämför förutsägelser med fördröjda bekräftade diagnoser, spårar kapacitet och kalibrering, och utlöser granskning när prevalens eller insamling förändras. Förvirringsmatrisen förblir kopplad till den exakta modellen, tröskeln och populationen.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar grundlinje och en versionshanterad utvärderingsuppsättning innan justering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftens kvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larm‑trösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incident‑lärande, raderings‑ och bevarande‑procedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Vad är en normaliserad förvirringsmatris?
Normalisering delar räkningarna med den sanna klassens total, den förutsagda klassens total eller alla observationer. Det gör att andelar blir lättare att jämföra mellan klasser, men rapporten bör också behålla råa stöd‑räkningar så att små grupper inte misstas för lika stora.
Kan en förvirringsmatris utvärdera regression?
Inte direkt. En förvirringsmatris kräver diskreta klasser. Att gruppera ett kontinuerligt mål i bin innebär att information går förlorad; regression bör normalt använda residualanalys och mått avsedda för kontinuerliga värden, såsom MAE eller RMSE.
Primära referenser












