
Grunderna i AI
Vad är sentimentanalys? Metoder, användningsområden och begränsningar

 Lägg till Unite.AI bland dina föredragna källor på Google
Sentimentanalys uppskattar värderande språk i text, talutskrifter eller annat innehåll. Ett system kan klassificera polaritet såsom positiv, negativ eller neutral; upptäcka åsikter på aspektnivå; uppskatta intensitet; eller identifiera hållning gentemot ett specifikt påstående.
Målet måste definieras noggrant. Sentiment är inte detsamma som känsla, avsikt, toxicitet, tillfredsställelse eller sanning. En positiv mening kan beskriva en skadlig händelse sarkastiskt, medan en negativ produktrecension ändå kan rekommendera produkten som helhet.
Viktiga slutsatser
- Definiera enhet, mål, etiketter och kontext innan exempel samlas in.
- Lexikon är transparenta baslinjer; övervakade modeller och transformer‑modeller kan fånga mer kontext men kräver representativ data.
- Negation, sarkasm, domänspecifikt vokabulär, flerspråkig text och aspektgränser är fortfarande svåra.
- Utvärdera per klass, undergrupp, domän och tidsperiod; inkludera mänsklig granskning för konsekventa användningar.
Nivåer och mål
Analys på dokumentnivå ger en etikett för hela objektet. Analys på meningsnivå separerar påståenden, medan aspektbaserad analys kopplar sentiment till en entitet eller egenskap – till exempel positiv om bildkvalitet men negativ om batteritid.
Ståndpunkt frågar om en talare stödjer ett specifikt påstående, vilket kan skilja sig från den emotionella tonen. Dessa distinktioner bör fastställas i annoteringsguiden innan man använder textklassificering metoder.
Lexikon, klassiska modeller och transformer‑modeller
Ett lexikon tilldelar ord poäng och kombinerar dem med regler för negation eller intensitet. Det är tolkningsbart och billigt men har svårt med kontext. Klassiska övervakade modeller använder ord‑ eller n‑gram‑funktioner, medan transformer‑modeller lär sig kontextuella representationer och kan finjusteras.
Few‑shot‑promptning kan vara bekvämt, men resultaten beror på exempel och formulering. Jämför varje komplex metod med en baslinje och använd few‑shot‑inlärning endast med ett avskilt, versionerat utvärderingsset.
Data‑ och språkutmaningar
Etiketter kan spegla annotatörens perspektiv snarare än en objektiv fakta. Domänskifte är allvarligt: ‘oförutsägbar’ kan vara beröm för en film och kritik för ett fordon. Kodväxling, dialekt, emojis, citerat tal och ironi komplicerar signaler på token‑nivå.
Balansera klasser avsiktligt och förhindra att relaterade författare, produkter eller konversationer läcker mellan tränings‑ och testdata. En modell som memoriserar ett varumärke eller en talare kan verka korrekt utan att lära sig sentiment.
Utvärdering och ansvarsfull användning
Rapportera precision, recall, F1 och en förvirringsmatris snarare än enbart noggrannhet. Granska fel efter aspekt, längd, dialekt och tid, och kalibrera trösklar för den operativa kostnaden för varje misstag.
Aggregata trender kan stödja forskning eller triage, men att dra slutsatser om en individs tillstånd eller fatta beslut om anställning, kredit, hälsa eller polisarbete medför större risk. Tillhandahåll osäkerhet, källkontext, integritetskontroller och mänsklig granskning.
Annotering och dataset‑konstruktion
Skriv en annoteringsguide med mål‑entitet, analysenhet, etikettdefinitioner, hantering av blandade och neutrala fall, citeringsregler, sarkasmpolicy och exempel från domänen. Pilotera med flera annotatörer, beräkna överensstämmelse, diskutera meningsskiljaktigheter och revidera uppgiften innan etiketter skaleras.
Urvalet bestämmer vad modellen lär sig. En sociala‑medier‑ström kan överrepresentera mycket aktiva konton; supportärenden kan utelämna nöjda kunder; stjärnbetyg kanske inte matchar recensionstexten. Bevara källa‑ och tidsmetadata, respektera plattformsvillkor och integritet, och skapa ett testset från den population där beslut ska fattas.
Etikettläckage kan ske via betyg, emojis som införts av insamlingssystemet, mallade signaturer eller produktnamn korrelerade med sentiment. Deduplikera nästan identiska inlägg och gruppera konversationer eller författare så att deras språk inte förekommer på båda sidor av en delning.
Modelleringsval och kalibrering
Lexikonsystem summerar ordpoäng och justerar för negation, förstärkare, interpunktion eller emojis. De ger en användbar sunt‑förnuftskontroll och kan anpassas med domänspecifika termer. Linjära modeller med TF–IDF‑funktioner är fortfarande konkurrenskraftiga på vissa dataset och avslöjar inflytelserika n‑gram.
Kontextuella kodare representerar ord enligt omgivande text och kan finjusteras för polaritet eller aspekter. Långa dokument kan behöva hierarkiska modeller, meningsaggregering eller hämtning av relevanta segment. Flerspråkiga tillvägagångssätt kan träna en gemensam modell, översätta till ett pivot‑språk eller upprätthålla lokala modeller; varje metod har täcknings‑ och kulturella avvägningar.
Sannolikhetskalibrering är viktig när poäng utlöser åtgärder. Tillförlitlighetsdiagram och förväntat kalibreringsfel visar om en rapporterad 0,8‑konfidens motsvarar cirka 80 % korrekthet. Trösklar kan skapa ett avstå‑intervall för mänsklig granskning, och separata trösklar kan vara motiverade när felkostnader skiljer sig – inte för att dölja ojämn kvalitet.
Tillämpningar och vanliga missuppfattningar
Aggregat sentiment kan hjälpa till att prioritera teman, jämföra kampanjreaktioner eller dirigera brådskande servicemeddelanden. Aspektanalys är ofta mer handlingsbar än total polaritet eftersom den identifierar vad människor diskuterar. Trendanalys kräver stabilt urval och konsekventa etikettdefinitioner över tid.
Uppskatta inte förekomsten av negativa inlägg som befolkningens åsikt. Publiceringsbeteende, bots, moderering, plattformsdemografi, kampanjer och insamlingsfrågor formar provet. En sentimentmodell mäter inte den tysta befolkningen, och en förändring i formulering kan se ut som en förändring i attityd.
För individuella beslut kan felaktiga etiketter vara stigmatiserande och svåra att bestrida. Undvik att använda sentiment som en proxy för medarbetarengagemang, mental hälsa, kreditvärdighet, avsikt eller bedrägeri. När människor påverkas, visa källkontext, möjliggör korrigering och kräva en mänsklig beslutsfattare med verkligt omdöme.
Arbetsexempel: sentimentanalys för kundfeedback
Ett företag som analyserar supportkommentarer bör definiera om det behöver dokument‑sentiment, aspekt‑sentiment, känsla, brådska eller ärendeklassificering. ‘Leveransen var snabb men produkten gick sönder’ kan inte på ett trovärdigt sätt representeras av en enda positiv‑eller‑negativ etikett. Skapa en annoteringsguide för mål, negation, sarkasm, blandade påståenden, citerat tal och okända fall, och mät överensstämmelse innan etiketterna behandlas som sanningsgrund.
Jämför ett lexikon eller en linjär baslinje med en finjusterad kodare eller en promptad språkmodell. Dela upp data efter tid eller kund för att förhindra läckage av nästan dubbletter, och bevara klassfördelning. Rapportera precision, recall, F1, kalibrering och förvirring per språk, kanal, produkt och demografiska proxyer endast där det är lagligt och motiverat. Granska fel med hög säkerhet eftersom de är farligare i automatiserad dirigering än osäkra utdata som eskaleras.
Använd sentiment som en signal för aggregering eller prioritering, inte som ett obestridligt mått på en persons tillstånd. Övervaka vokabulär och produktdrift, återträn med granskade exempel och låt agenter korrigera etiketter. Dra aldrig slutsatser om skyddade egenskaper eller disciplinera anställda utifrån ovaliderade sentimentpoäng. För ledningsrapportering, visa urvalsstorlek, osäkerhet, saknade data och de ämnen som driver förändringen så att en svängande poäng leder till undersökning snarare än en förenklad slutsats.
Flerspråkig utrullning bör inte anta att översättning av indata bevarar ton, negation, idiom eller kulturell konvention. Validera varje stödspråk och blandade språkmönster med inhemska granskare, och ge ett okänt resultat när bevisen är svaga. Domänanpassning är också viktigt: ord som låter negativa i vanlig konversation kan vara neutrala tekniska beskrivningar. Behåll separata trösklar eller modeller endast när operativa bevis motiverar den extra komplexiteten och styrningsbördan.
Praktisk implementeringschecklista
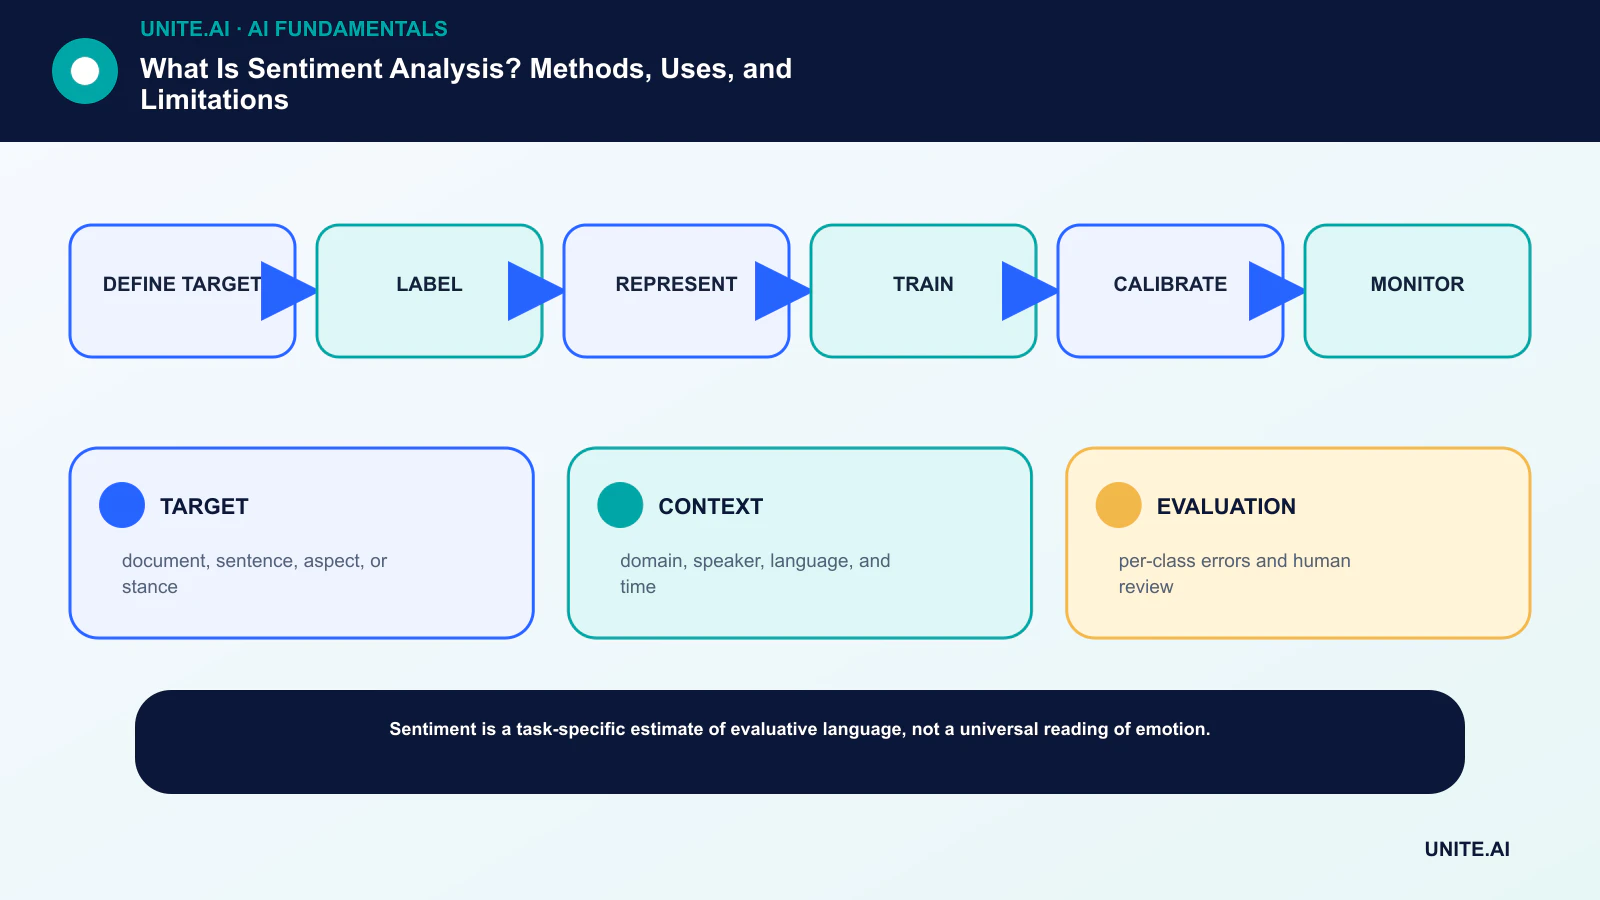
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: definiera mål → etikett → representation → träning → kalibrering → övervakning. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt godkännande‑ och stoppkriterier, testa representativa fel, och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, randvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna utgivning, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- MÅL: dokument, mening, aspekt eller hållning.
- KONTEXT: domän, talare, språk och tid.
- UTVÄRDERING: fel per klass och mänsklig granskning.
Vanliga frågor
Är sentimentanalys objektiv?
Nej. Den uppskattar etiketter som definieras av en uppgift och annoteringsprocess. Vissa texter är faktiskt tvetydiga, blandade, kontextberoende eller tolkas olika av läsare.
Kan sentimentanalys upptäcka sarkasm?
Modeller kan lära sig vissa mönster, men sarkasm beror ofta på talarens historik, gemensam kunskap och kontext utanför texten. Det förblir ett vanligt felscenario.
Primära referenser












