
Grunderna i AI
Vad är gradientnedstigning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Gradientnedstigning är en optimeringsmetod som justerar modellparametrar för att minska en målfunktion. Vid träning av neurala nätverk är målet vanligtvis en förlust som beräknas över exempel. Gradienten pekar i riktning mot den brantaste lokala ökningen, så gradientnedstigning tar ett steg i motsatt riktning.
Gradienten beskriver lokal känslighet; dess magnitud är inte en direkt mätning av hur snabbt en modell “lär sig”. Den faktiska framstegen beror också på inlärningshastigheten, krökning, brus, parametrisering, optimerarens tillstånd och data.
Viktiga slutsatser
- Bakåtspridning beräknar gradienter, medan gradientnedstigning använder dem för att uppdatera parametrar.
- Mini-batch-optimering är den vanliga praktiska metoden för djupinlärning.
- Inlärningshastigheten styr uppdateringsskalan och kan följa ett schema snarare än att krympa efter varje steg.
- Momentum, AdamW, klippning och normalisering hanterar olika optimeringsproblem.
Den grundläggande uppdateringsregeln
För parametervektorn θ, inlärningshastigheten η och förlusten L:
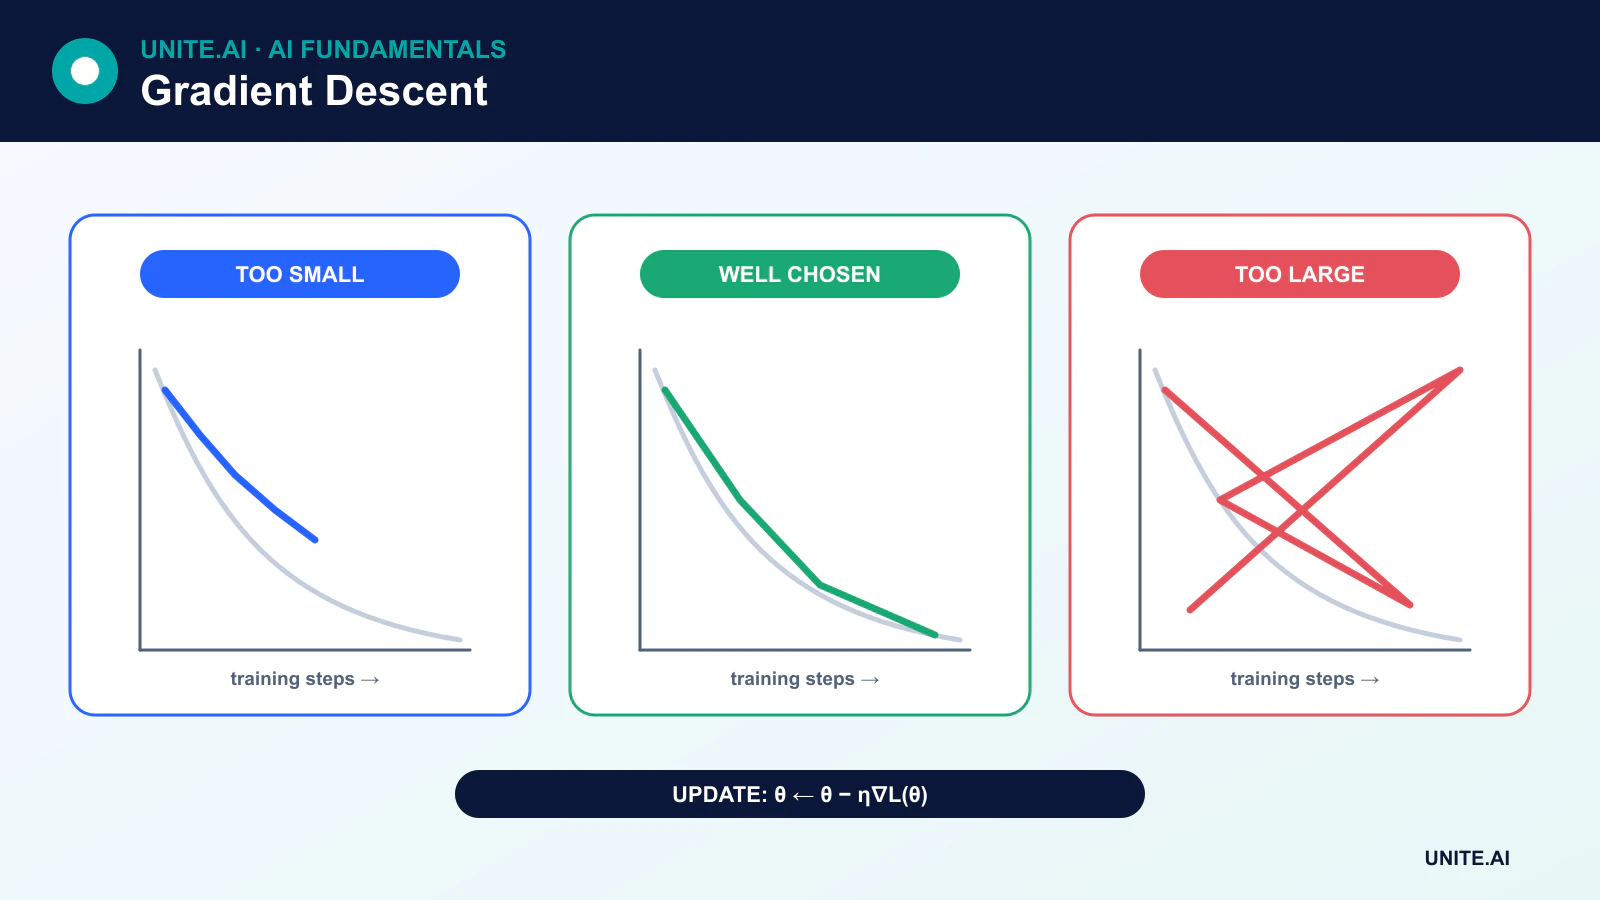
θ ← θ - η∇L(θ)
Gradienten ∇L(θ) innehåller en partiell derivata per parameter. Att subtrahera den rör sig nedför lokalt. En stationär punkt har gradienten noll, men den kan vara ett minimum, maximum, sadelpunkt eller en plan region. Förluster i djupinlärning är icke‑konvexa, så träning garanterar inte att hitta ett unikt globalt minimum eller nollförlust.
Batch-, stokastiska och mini-batch-metoder
Batchgradientnedstigning
Batchgradientnedstigning beräknar en gradient med hela träningssetet för varje uppdatering. Estimatet är stabilt men kan vara tids- och minneskrävande, och en uppdatering kan underutnyttja moderna acceleratorer.
Stokastisk gradientnedstigning
Strikt stokastisk gradientnedstigning använder ett slumpmässigt valt exempel per uppdatering. Dess gradienter är brusiga, vilket kan hjälpa utforskning av förlustytan, men operationer med ett enda exempel kan vara ineffektiva på parallell hårdvara.
Mini-batch gradientnedstigning
Mini-batch-träning uppskattar gradienten från en delmängd av exempel. Den balanserar statistiskt brus med effektiva matrisoperationer och är den vanliga metoden inom djupinlärning. Batchstorlek påverkar minne, genomströmning, gradientbrus, normalisering och ibland generalisering.
Val av inlärningshastighet
En hastighet som är för stor kan hoppa över användbara regioner eller orsaka divergens. En hastighet som är för liten kan göra träningen opraktiskt långsam eller fastna i plana regioner. Den bästa skalan beror på optimeraren, batchstorlek, modell, initiering och mål.
Scheman kan värmas upp gradvis, minska vid milstolpar, följa en cosinuskurva eller reagera på valideringsframsteg. Hastigheten behöver inte krympa monotont efter varje uppdatering. Värma omstarter och cykliska scheman ökar den avsiktligt under delar av träningen.
Momentum
Momentum behåller ett exponentiellt glidande medelvärde av tidigare gradienter. Det kan påskynda framsteg längs konsekventa riktningar och minska oscillationer i branta, smala riktningar. Nesterov‑liknande momentum utvärderar eller approximerar gradienten efter att ha tittat framåt längs momentumriktningen.
Adaptiva optimerare
RMSProp skalar uppdateringar med ett glidande medelvärde av kvadrerade gradienter. Adam kombinerar momentumliknande första moment med skalning av andra momentet. AdamW kopplar loss av vikt från den adaptiva gradientuppdateringen och används i stor utsträckning för transformer‑modeller.
Adaptiva optimerare gör ofta den tidiga träningen enklare, men de är inte automatiskt överlägsna för varje modell eller slutgiltigt generaliseringsmål. Jämförelser av optimerare kräver matchade scheman och noggrann finjustering.
Gradientklippning och ackumulering
Gradientklippning begränsar en gradients norm eller värden för att minska påverkan av exploderande gradienter, särskilt i återkommande eller instabil träning. Gradientackumulering adderar gradienter över flera mindre batchar före en uppdatering, vilket approximerar en större effektiv batch när minnet är begränsat.
Övervakning av optimering
Följ tränings- och valideringsförlust, uppgiftsmått, inlärningshastighet, gradientnormer, parameternormer och numeriska fel. En fallande träningsförlust med försämrad valideringsprestanda indikerar överanpassning, inte en optimeringsframgång som automatiskt bör fortsätta.
Optimering minimerar det givna målet. En låg förlust bevisar inte att data, mått eller verkligt beteende är lämpliga. Läckage, dåliga etiketter och ett felaktigt mål kan producera en väloptimerad men skadlig modell.
Optimeringsgeometri och uppdateringsregler
Gradientnedstigning uppdaterar parametrar i motsatt riktning mot gradienten av en förlust. Full‑batch‑nedstigning använder varje träningsexempel per steg; stokastisk nedstigning använder ett; mini‑batch‑metoder uppskattar gradienten från en delmängd och dominerar djupinlärning. Inlärningshastigheten bestämmer stegs storlek. För liten slösar beräkning eller fastnar; för stor oscillera eller divergerar. Momentum ackumulerar en rörlig riktning, medan adaptiva metoder som Adam skalar koordinater med hjälp av gradientmoment. Deras olika implicita bias kan producera modeller med liknande träningsförlust men olika generalisering.
Förlustytor i neurala nätverk innehåller plana och skarpa regioner, sadelpunkter, symmetrier och dåligt konditionerade riktningar. Feature‑skalning, normalisering, initiering, residualanslutningar och förkonditionering förändrar den geometri som optimeraren ser. Scheman kan värmas upp, minska, cykla eller reagera på platåer. Viktavkling är skilt från att bara lägga till ett L2‑straff i vissa adaptiva optimerare. Batchstorlek påverkar brus, minne, parallellism och inlärningshastighetsregimen, så jämförelser av optimerare kräver matchade träningsbudgetar och noggrann finjustering.
Diagnos, reproducerbarhet och stopp
Följ tränings- och valideringsförlust, uppgiftsmått, gradient‑ och parameternormer, inlärningshastighet, genomströmning och numeriska varningar. Divergens kan bero på korrupta batchar, ogiltiga etiketter, instabil blandad precision eller en felaktig förlustreduktion. Platåer kan indikera underkapacitet, mättade aktiveringar, dåliga funktioner, överdriven regularisering eller ett schemafel. Överanpassning kräver data, augmentation, regularisering eller tidig stoppning – inte ett påstående om att optimeraren misslyckats. Inspektera representativa fel och jämför en enkel baslinje innan du ökar träningskomplexiteten.
Reproducerbarhet kräver frön, dataordning, kod, konfiguration, hårdvara‑ och biblioteks versioner, även om vissa accelerator‑kärnor förblir icke‑deterministiska. Spara checkpoints med optimerarens och schemarets tillstånd så att träning kan återupptas konsekvent. Välj en checkpoint baserat på valideringskriterier som fastställts i förväg och reservera ett orört testset. Vid distribuerad träning, bekräfta effektiv batchstorlek, gradientmedelvärde och hantering av misslyckade arbetare. Optimering minimerar det valda målet på tillgänglig data; den garanterar inte kalibrerade sannolikheter, kausal resonemang, rättvisa, säkerhet eller verklig nytta.
Arbetsexempel: finjustering av en optimerare för en språkmodell
Ett team fastställer tokenizer, dataordning, modell, effektiv batch och tränings‑tokenbudget, och jämför sedan SGD med momentum och AdamW över försvarbara inlärningshastighetsscheman. Uppvärmning, avtagande, viktavkling, klippning och precision loggas. Varje kandidat kör flera frön, och validering använder ett avskalat tidsintervall plus uppgiftsutvärderingar. Genomströmning och energi rapporteras tillsammans med förlust så att en något bättre optimerare inte väljs till en oproportionerlig kostnad.
Diagnostik avslöjar om instabilitet härstammar från en data‑shard, för stor steglängd, underflöde eller modellarkitektur. Checkpoints bevarar optimerarens och schemarets tillstånd och återupptas i ett test. Det slutgiltiga valet baseras på valideringskvalitet och robusthet, inte den lägsta träningsförlusten. Ett slutet testset körs en gång efter urvalet. Produktionsinferenz kalibreras och övervakas separat eftersom optimerarens framgång under förträning inte garanterar säkert eller sanningsenligt beteende.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och ett versionshanterat utvärderingsset innan finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incidentlärande, raderings‑ och bevarandeprocesser samt en tydlig punkt där det ska inaktiveras eller ersättas.
Vanliga frågor
Kommer gradientnedstigning alltid att nå det globala minimumet?
Nej. För konvexa mål ger lämpliga villkor starka garantier. Målen för djupa nätverk är icke‑konvexa, och praktiska optimerare söker vanligtvis en användbar lösning snarare än att bevisa att de hittat det unika globala minimumet.
Varför kan en nollgradient vara missvisande?
En noll- eller mycket liten gradient kan indikera ett minimum, maximum, en sadelpunkt, mättnad eller en plan platå. Träningsdiagnostik måste beakta förlusthistorik, krökning, parameter‑skala och valideringsprestanda.
Primära referenser












