Fundamentos de IA
O que é Aprendizado de Máquina?

 Adicione Unite.AI às suas fontes preferidas no Google
Aprendizado de máquina (ML) é um ramo da inteligência artificial no qual um sistema aprende padrões a partir de dados para fazer previsões, classificações, recomendações ou decisões sem que um desenvolvedor escreva uma regra separada para cada caso possível. O resultado não é uma máquina que “pensa” como uma pessoa. É um modelo estatístico que mapeia entradas para saídas úteis e pode ser avaliado em dados que não viu durante o treinamento.
O aprendizado de máquina está inserido no campo mais amplo da IA, enquanto deep learning é uma família de métodos de aprendizado de máquina construídos em torno de redes neurais de múltiplas camadas. Essa distinção importa: nem todo sistema de IA usa ML, e nem todo problema de ML requer uma rede neural.
Principais pontos
- ML aprende uma relação a partir de exemplos, em vez de depender apenas de regras escritas à mão.
- Um modelo útil deve generalizar para novos dados, não apenas memorizar seu conjunto de treinamento.
- Aprendizado supervisionado, não supervisionado, semi-supervisionado, auto-supervisionado e por reforço resolvem diferentes tipos de problemas.
- Qualidade dos dados, design da avaliação e monitoramento são tão importantes quanto o algoritmo.
Como funciona o aprendizado de máquina
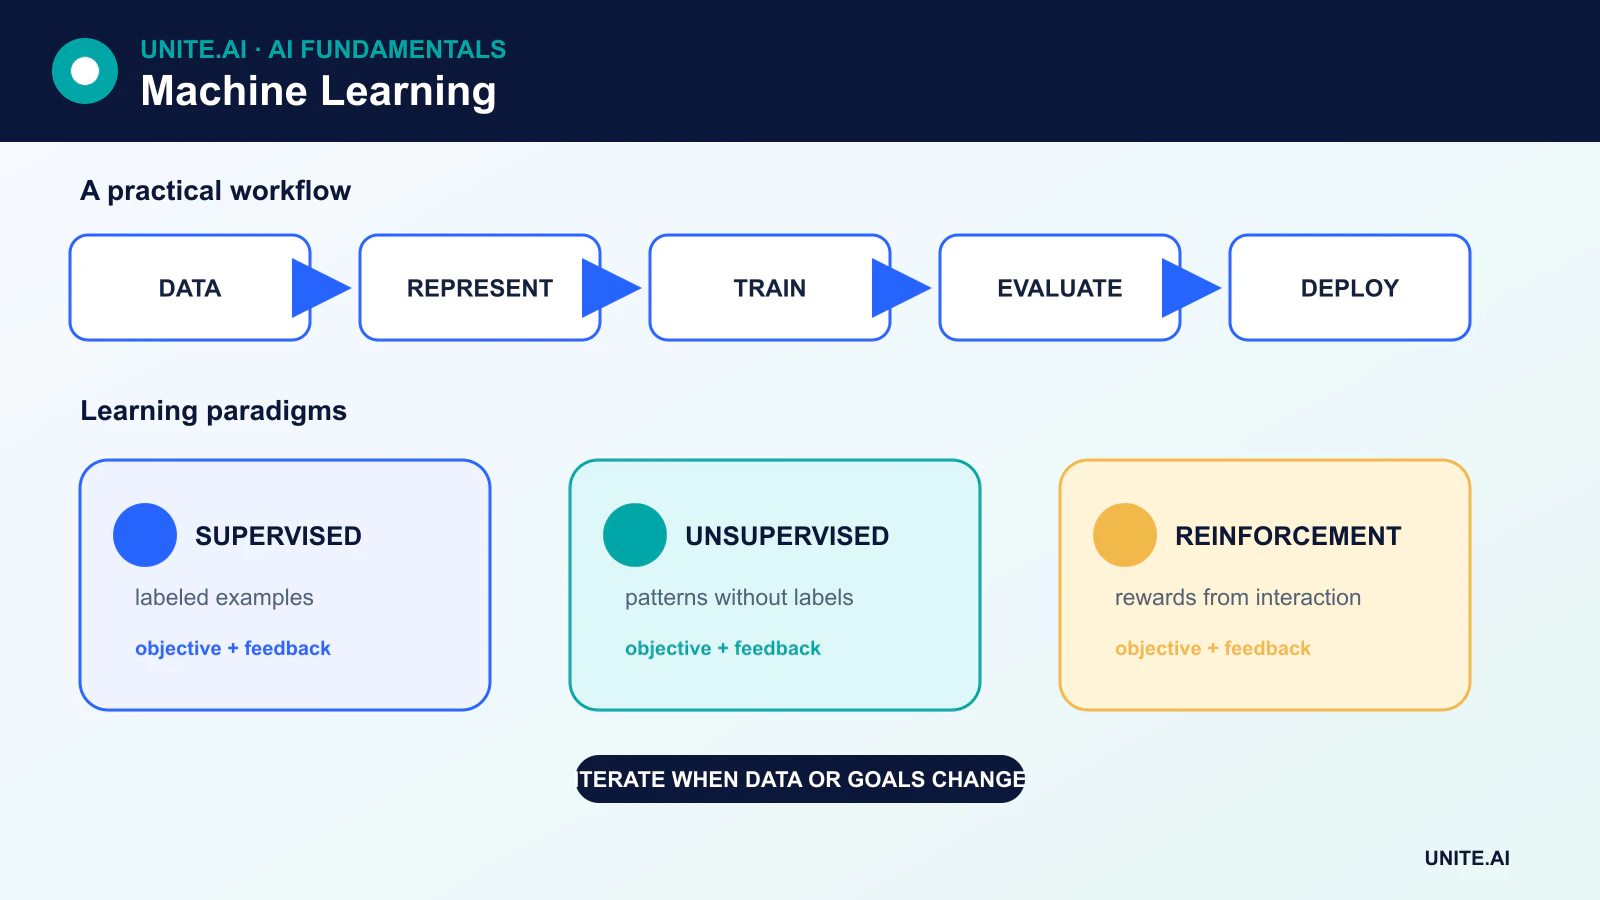
A maioria dos projetos de ML pode ser compreendida como uma sequência de seis etapas:
- Definir a tarefa. Decida o que o sistema deve prever ou descobrir e o que significa sucesso na aplicação real.
- Coletar e preparar os dados. Limpe registros, trate valores ausentes, crie recursos úteis e documente a origem dos dados.
- Dividir os dados. Um conjunto de treinamento é usado para ajustar o modelo, um conjunto de validação ajuda a selecionar configurações e um conjunto de teste fornece uma estimativa final em dados não utilizados.
- Treinar o modelo. Um algoritmo ajusta os parâmetros do modelo para reduzir uma função de perda ou atender a outro objetivo de aprendizado.
- Avaliar a generalização. Métricas devem refletir a tarefa, o equilíbrio de classes, os custos de erro e a população na qual o modelo operará.
- Implantar e monitorar. Dados do mundo real podem mudar, portanto as equipes observam deriva, degradação de desempenho, viés e falhas operacionais.
As variáveis fornecidas a um modelo são comumente chamadas de características. No aprendizado supervisionado, a resposta desejada é chamada de rótulo ou alvo. Os parâmetros aprendidos de um modelo codificam uma relação entre as características e a saída; eles não são um banco de regras explícitas.
Os principais paradigmas de aprendizado
Aprendizado supervisionado
No aprendizado supervisionado, os exemplos incluem tanto entradas quanto alvos conhecidos. Um modelo de classificação prevê categorias, como se uma transação é fraudulenta. Um modelo de regressão prevê um valor contínuo, como a demanda de energia esperada.
Algoritmos supervisionados comuns incluem árvores de decisão, máquinas de vetor de suporte, K-vizinhos mais próximos, regressão linear e logística, árvores de gradiente aumentada e redes neurais. Um limiar de classificação, como 0,5, é uma decisão escolhida após o modelo gerar uma pontuação ou probabilidade; não é uma propriedade imutável da regressão logística.
Aprendizado não supervisionado
O aprendizado não supervisionado trabalha com dados que não incluem rótulos de alvo. O objetivo pode ser encontrar grupos, detectar observações incomuns, estimar uma distribuição ou criar uma representação de dimensionalidade menor. Um cluster é um grupo sugerido por uma regra de similaridade; não é automaticamente uma classe significativa do mundo real.
Exemplos incluem agrupamento K-means, análise de componentes principais, estimativa de densidade e algumas formas de autoencoders. Um autoencoder aprende a reconstruir sua entrada por meio de uma representação comprimida. Ele não cria automaticamente rótulos de verdade.
Aprendizado semi-supervisionado e auto-supervisionado
Aprendizado semi-supervisionado combina um pequeno conjunto de dados rotulado com um conjunto maior não rotulado. Aprendizado auto-supervisionado cria um sinal de treinamento a partir dos próprios dados — por exemplo, prever palavras mascaradas ou combinar duas visualizações transformadas da mesma imagem. A auto-supervisão é central em muitas pipelines modernas de transformers e modelos de base porque pode usar grandes coleções de texto, imagens, áudio ou vídeo sem que uma pessoa rotule cada exemplo.
Aprendizado por reforço
No aprendizado por reforço, um agente realiza ações em um ambiente e recebe recompensas ou custos. O objetivo é aprender uma política que maximize a recompensa cumulativa esperada. Isso difere do aprendizado supervisionado porque a ação correta não é fornecida para cada estado, e uma ação pode influenciar quais dados o agente encontrará a seguir.
Treinamento, validação e generalização
Um modelo que tem bom desempenho em seus exemplos de treinamento ainda pode falhar em novos dados. Essa falha é conhecida como overfitting. As equipes a reduzem por meio de capacidade de modelo adequada, regularização, validação cruzada, aumento de dados, prevenção de vazamento e um conjunto de teste realmente independente.
Não existe uma métrica única para cada tarefa de ML. Classificação pode exigir precisão, recall, F1, calibração ou uma medida ponderada por custo em vez de acurácia bruta. Regressão pode usar erro absoluto médio, raiz do erro quadrático médio ou uma perda específica do domínio. Agrupamento requer diferentes formas de avaliação interna ou validada externamente. A métrica deve refletir o que um erro significa para o usuário ou organização.
Algoritmos de aprendizado de máquina são ferramentas, não garantias
Um algoritmo carrega suposições. Modelos lineares assumem uma forma particular de relação. K-vizinhos mais próximos assume que a distância selecionada representa similaridade significativa. Naive Bayes assume que as características são condicionalmente independentes dado a classe. Árvores de decisão particionam o espaço de características usando regras de divisão aprendidas; suas folhas contêm previsões baseadas em grupos de observações de treinamento, e não necessariamente em uma única observação cada.
Portanto, a escolha do modelo depende do tamanho dos dados, tipos de características, requisitos de latência, necessidades de interpretabilidade e custo dos erros. Um modelo mais simples pode superar um modelo maior quando os dados são limitados ou as restrições operacionais favorecem velocidade e transparência.
Onde o aprendizado de máquina é usado
ML suporta classificação de busca, recomendações, previsões, detecção de anomalias, tradução, reconhecimento de fala, visão computacional, manutenção preditiva, detecção de fraude e análise científica. As mesmas técnicas também podem amplificar vieses históricos, expor informações sensíveis ou comportar-se de forma imprevisível sob mudança de distribuição. A implantação responsável requer documentação, supervisão humana quando apropriado, testes de segurança e monitoramento contínuo.
Da definição do problema a um experimento válido de aprendizado de máquina
Um projeto de aprendizado de máquina deve começar com uma decisão e um resultado mensurável, não com um algoritmo. Defina a unidade de previsão, o alvo, o tempo de observação, o tempo de decisão, as características disponíveis e o custo de cada erro. Para um modelo de churn, por exemplo, usar eventos registrados após o cancelamento vazaria a resposta. Estabeleça uma regra simples ou linha de base estatística, então divida os dados por tempo, cliente, localização ou outra fronteira que reflita a implantação. Divisões aleatórias de linhas podem colocar observações quase idênticas nos conjuntos de treinamento e teste e gerar uma pontuação enganosa.
Engenharia de características converte registros brutos em representações que o modelo pode usar, mas cada característica precisa de procedência e garantia de disponibilidade. Ajuste normalização, vocabulário, imputação e redução de dimensionalidade apenas nos dados de treinamento, depois aplique a transformação aprendida aos dados de validação e teste. Validação cruzada estima variação entre amostras; um conjunto de teste final não usado apoia a decisão de lançamento. Selecione métricas a partir das consequências: precisão e recall para erros de classificação desiguais, calibração quando probabilidades conduzem ações, e medidas ponderadas por custo ou utilidade quando os erros têm efeitos operacionais diferentes.
Implantação, monitoramento e operação responsável
A inferência em produção repete a transformação completa feita durante o treinamento e devolve uma previsão dentro de restrições de latência, taxa de transferência e disponibilidade. Empacote o pré-processamento com o modelo, valide esquemas de entrada, versionamento de artefatos e compare resultados entre implementações offline e de serviço. Escolha um limiar usando a capacidade operacional e o trade‑off de erro em vez de usar o padrão 0,5. Desdobre por meio de avaliação sombra, uma coorte limitada ou um experimento com métricas de segurança. Mantenha um fallback determinístico e um caminho de rollback para falha de dependência ou comportamento inaceitável.
Monitore a qualidade da entrada, deriva de características, distribuição das previsões, calibração, resultados de subgrupos, latência, custo e rótulos confirmados quando eventualmente chegarem. Deriva é um sinal para investigar, não prova automática de que o re‑treinamento ajudará. O re‑treinamento requer dados revisados, testes repetíveis, aprovação e comparação com o modelo atual vencedor. Documente usos pretendidos e inválidos, direitos de dados, privacidade, segurança, intervenção humana e recurso onde as pessoas são afetadas. Aprendizado de máquina é um sistema de decisão mantido; o arquivo do modelo é apenas um componente substituível.
Exemplo prático: previsão de falha de equipamento
Um fabricante define uma previsão por máquina‑dia: se uma falha verificada ocorrerá dentro de sete dias usando apenas telemetria disponível no início desse dia. Ele divide por máquina e tempo, compara com regras baseadas em idade e limiar, ajusta o pré‑processamento nos dados de treinamento e avalia recall de eventos, alertas falsos, tempo de antecedência de aviso, calibração e capacidade de manutenção. Substituição de sensores e paralizações planejadas são modeladas como contexto operacional, em vez de serem tratadas como observações ordinárias.
O modelo primeiro roda em modo sombra. Alertas exibem telemetria contributiva e incerteza, mas os mantenedores decidem se inspecionam. Descobertas e causas confirmadas tornam‑se rótulos governados; a ausência de uma ordem de serviço não é presumida como ausência de falha. Um lançamento em etapas usa limites de alerta e um fallback manual, enquanto o monitoramento acompanha a saúde dos sensores, deriva de entrada, precisão revisada, tempo de inatividade e manutenção desnecessária. O re‑treinamento ocorre somente após revisão de dados e limiares demonstrar provável melhoria em relação ao sistema atualmente implantado.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um lançamento em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Referências principais