
Fundamentos de IA
O que é Deep Learning?

 Adicione Unite.AI às suas fontes preferidas no Google
Deep learning é uma família de métodos de aprendizado de máquina que utiliza redes neurais com múltiplas camadas de processamento para aprender representações úteis dos dados. Esses modelos alimentam muitos sistemas modernos de linguagem, imagens, áudio, recomendações, previsão científica e IA generativa.
A palavra deep refere‑se ao número de transformações entre a entrada e a saída, não a uma máquina que possua compreensão mais profunda. Um modelo deep aprende relações numéricas úteis para seu objetivo de treinamento, e seu desempenho ainda deve ser testado em novos dados.
Principais pontos
- Deep learning é um subconjunto de aprendizado de máquina.
- Camadas transformam tensores usando parâmetros aprendidos, ativações não lineares, normalização e outras operações.
- A retropropagação calcula gradientes; um otimizador usa esses gradientes para atualizar parâmetros treináveis, incluindo pesos e vieses.
- CNNs, redes recorrentes, transformers, autoencoders e modelos de difusão têm estruturas e pontos fortes diferentes.
Como uma rede neural profunda aprende
Uma rede neural recebe dados como tensores, ou arrays multidimensionais de números. Um tensor de imagem pode codificar canais de pixels, enquanto um modelo de linguagem usa vetores que representam tokens. Cada camada realiza uma transformação diferenciável e passa o resultado para a camada seguinte.
Em uma camada densa básica, o modelo calcula uma soma ponderada de suas entradas, adiciona um viés treinável e, em seguida, aplica uma função de ativação:
output = activation(Wx + b)
A função de ativação introduz não linearidade. Sem ela, empilhar camadas lineares ordinárias ainda representaria apenas uma transformação linear. ReLU e suas variantes são comuns em camadas ocultas, enquanto as ativações de saída dependem da tarefa.
O treinamento normalmente segue quatro etapas:
- Uma passagem forward produz previsões.
- Uma função de perda mede como as previsões diferem do objetivo.
- A retropropagação aplica a regra da cadeia para calcular o gradiente da perda em relação a cada parâmetro treinável.
- Um otimizador, como gradiente estocástico descendente ou AdamW, atualiza os parâmetros.
Repetir essas etapas em muitas lotes pode melhorar o modelo, mas uma perda de treinamento menor não garante um comportamento confiável no mundo real. Validação, regularização, dados representativos e monitoramento permanecem essenciais.
Principais arquiteturas de deep learning
Perceptrons multicamadas
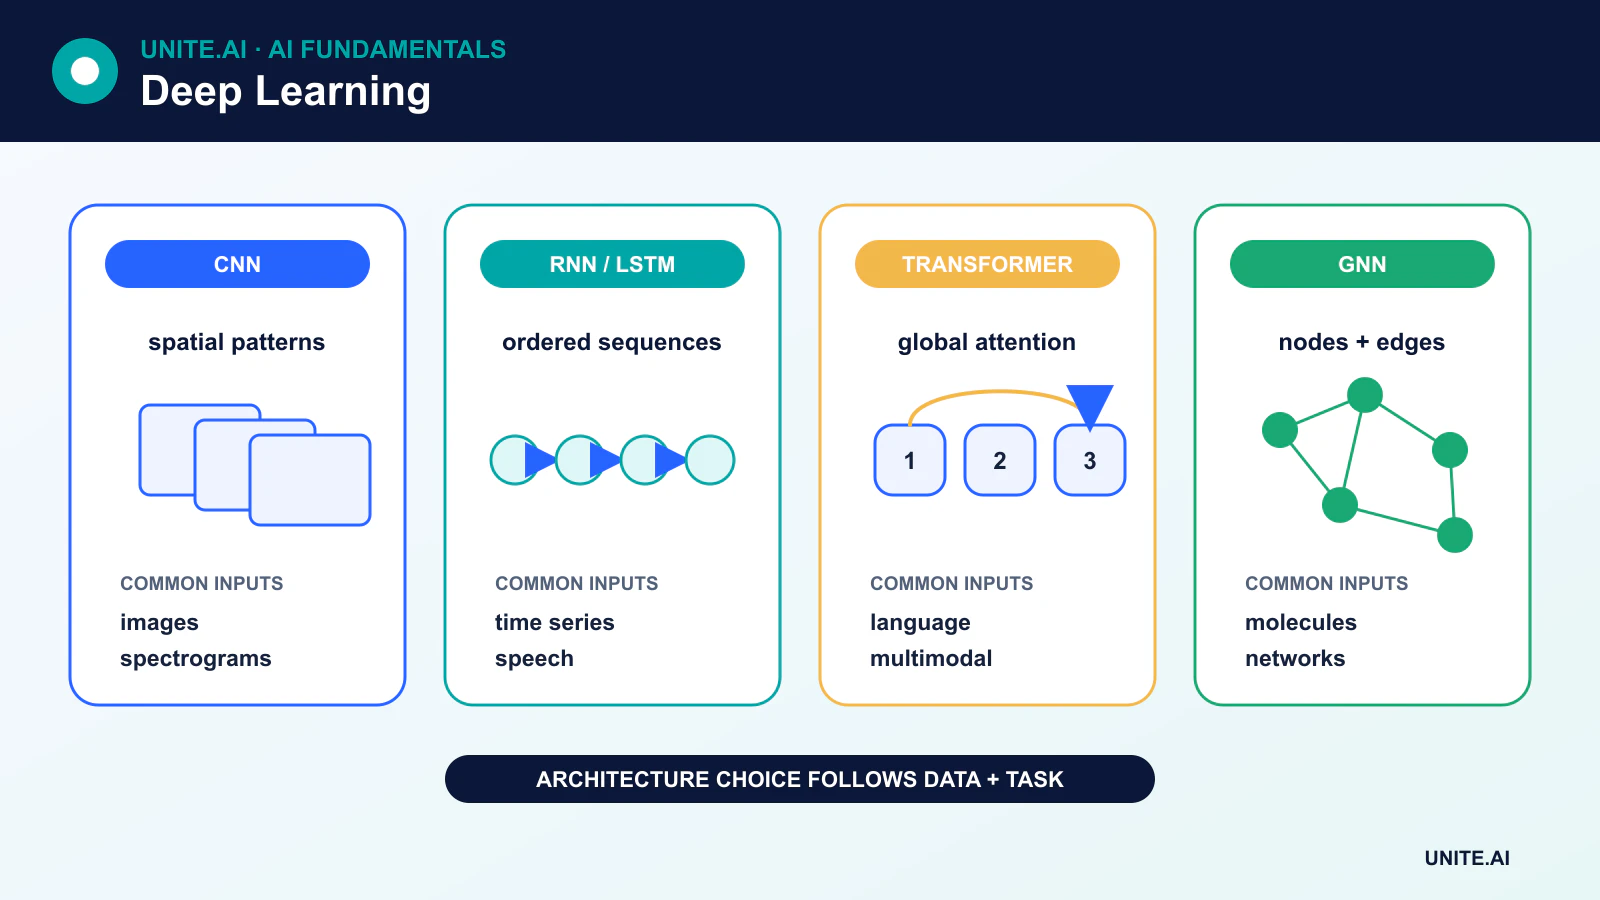
Um perceptron multicamadas (MLP) usa camadas totalmente conectadas nas quais cada unidade de saída depende de todas as entradas da camada anterior. MLPs são úteis para recursos tabulares e como componentes dentro de sistemas maiores, mas não incorporam suposições sobre a localidade de imagens ou a ordem de sequências.
Redes neurais convolucionais
Redes neurais convolucionais (CNNs) aplicam filtros aprendidos em regiões locais. O compartilhamento de pesos as torna eficientes para grades como imagens e espectrogramas. As CNNs continuam importantes para visão e implantação em dispositivos de borda, embora transformers de visão e modelos híbridos também sejam amplamente utilizados.
Redes recorrentes, LSTMs e GRUs
Redes neurais recorrentes (RNNs) atualizam um estado oculto à medida que uma sequência é processada. LSTMs e unidades recorrentes com portas ajudam a preservar informações e a reduzir o problema do gradiente que desaparece, que faz com que RNNs básicos tenham dificuldade com dependências longas. Elas não eliminam todas as limitações de longo contexto, mas continuam úteis para sinais em fluxo, dados de séries temporais e modelos sequenciais compactos.
Transformers
Transformers utilizam atenção para modelar relacionamentos entre elementos de uma sequência ou conjunto. Sua capacidade de processar muitas posições em paralelo ajudou a substituir a recorrência na maioria dos sistemas de linguagem em larga escala, e variantes de transformers agora processam imagens, áudio, vídeo, proteínas e dados multimodais.
Autoencoders e modelos generativos
Um autoencoder comprime uma entrada em uma representação e reconstrói a entrada a partir dela. Isso cria um objetivo de reconstrução auto‑supervisionado; não converte automaticamente dados não rotulados em exemplos rotulados.
Redes adversariais generativas treinam um gerador e um discriminador em competição. Modelos de difusão aprendem a reverter um processo gradual de adição de ruído. Transformers autoregressivos geram um token ou unidade de cada vez. Essas abordagens têm dinâmicas de treinamento, controlabilidade e requisitos computacionais diferentes.
Por que a profundidade ajuda — e por que a arquitetura importa
Múltiplas camadas permitem que um modelo componha transformações mais simples em outras mais complexas. Na visão, alguns recursos aprendidos podem evoluir de texturas locais para padrões específicos da tarefa. Na linguagem, camadas de atenção constroem representações de tokens dependentes de contexto. Essas descrições são intuições úteis, não regras fixas sobre o que cada camada deve aprender.
Redes modernas também dependem de conexões residuais, normalização, inicialização cuidadosa, regularização e hardware otimizado. Simplesmente adicionar camadas ou parâmetros pode tornar um modelo mais difícil de treinar, mais lento ou mais propenso a overfitting. A escala do modelo ajuda apenas quando os dados, objetivo, otimização e ambiente de implantação o suportam.
Treinamento versus inferência
O treinamento ajusta parâmetros e geralmente é a fase que mais consome computação. A inferência executa o modelo treinado para produzir uma saída. A inferência ainda pode ser cara para modelos grandes, por isso as equipes utilizam quantização, destilação, lotes, cache, esparsidade e hardware especializado, como unidades de processamento neural.
Limitações e uso responsável
Modelos profundos podem herdar vieses, memorizar informações sensíveis, falhar sob mudança de distribuição e gerar resultados convincentes, porém incorretos. Eles também podem ser difíceis de interpretar e custosos de treinar. A avaliação deve abranger mais do que a média de um benchmark: as equipes precisam de desempenho em nível de classe ou subgrupo, robustez, calibração, segurança, latência, consumo de energia e as consequências de falhas.
Representações, otimização e escolhas de arquitetura
Redes profundas aprendem representações sucessivas por meio de camadas parametrizadas. Transformações lineares misturam entradas; ativações não lineares permitem que a rede aproxime funções complexas; normalização e conexões residuais ajudam na otimização; atenção, convolução, recorrência ou operações de espaço de estado codificam diferentes suposições estruturais. A profundidade aumenta o número de transformações, não garante inteligência. A arquitetura deve refletir a modalidade, volume de dados, latência, memória e invariâncias da tarefa. Um modelo convolucional menor pode superar um transformer quando os dados são limitados e a estrutura espacial local domina.
O treinamento calcula uma perda, diferencia‑a com retropropagação e atualiza os parâmetros com um otimizador como gradiente estocástico descendente ou Adam. Tamanho de lote, taxa de aprendizado, agenda, inicialização, regularização e precisão numérica interagem. Curvas de perda de treinamento e validação ajudam a distinguir underfitting, overfitting, instabilidade e vazamento, mas não estabelecem utilidade no mundo real. Use dados de avaliação independentes, execuções repetidas onde a variância importa, ablações e comparação com linhas de base mais simples. Contagens grandes de parâmetros também aumentam a necessidade de governança de dados, planejamento de computação e configuração reproduzível.
Implantando modelos profundos de forma segura e eficiente
A implantação pode usar um endpoint hospedado, acelerador dedicado, navegador, telefone ou dispositivo embarcado. Exportação e compilação podem fundir operadores, quantizar pesos e ativações ou alterar o comportamento numérico, portanto valide o artefato implantado em vez de apenas o checkpoint de treinamento. Meça início a frio, latência estável, taxa de transferência, memória, energia e qualidade em tamanhos realistas de lote e sequência. Métodos de compressão — podagem, destilação, quantização e adaptação de baixa rank — trocam tamanho ou velocidade por precisão e complexidade de engenharia e devem ser avaliados em classes sensíveis e casos extremos.
Modelos profundos podem falhar de forma confiante sob mudança de distribuição, entrada adversária, correlação espúria e grupos mal representados. Monitore distribuições de entrada e saída, resultados da tarefa, calibração, uso de recursos e versões de dependências. Use controle de acesso, artefatos assinados, dados de treinamento protegidos, red teaming e limites de taxa adequados ao modelo de ameaça. Explicações como mapas de saliência ou visualizações de atenção são evidências diagnósticas, não prova de causalidade. Combine-as com testes comportamentais, contrafactuais, revisão humana, resposta a incidentes e limites explícitos em decisões automatizadas.
Exemplo prático: treinamento de um detector de defeitos em imagens
Uma fábrica coleta imagens de produtos de diferentes câmeras, turnos, materiais e classes de defeitos conhecidas, depois divide por lote de produção para que itens quase duplicados não cruzem partições. Uma linha de base convolucional pequena é comparada com uma rede profunda pré‑treinada. Aumento reproduz variações validadas de iluminação e ponto de vista sem apagar defeitos. A avaliação relata recall por defeito, taxa de falsos rejeitos, calibração, latência de inferência e robustez a desfoque, brilho, substituição de câmera e cores raras de material.
O modelo exportado e o código exato de redimensionamento, cor e normalização são testados no hardware da linha para taxa de transferência sustentada e comportamento térmico. Casos de baixa confiança vão para inspetores; uma regra independente interrompe a linha em caso de falha de sensor crítico. As imagens são mantidas apenas conforme permitido e os artefatos do modelo são assinados. O monitoramento conecta previsões a resultados de inspeções posteriores e lotes de produção. Uma nova câmera ou material aciona uma reavaliação controlada em vez de aprendizado online silencioso a partir de rótulos não revisados.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Referências principais












