
Fundamentos de IA
O que são CNNs (Redes Neurais Convolucionais)?

 Adicione Unite.AI às suas fontes preferidas no Google
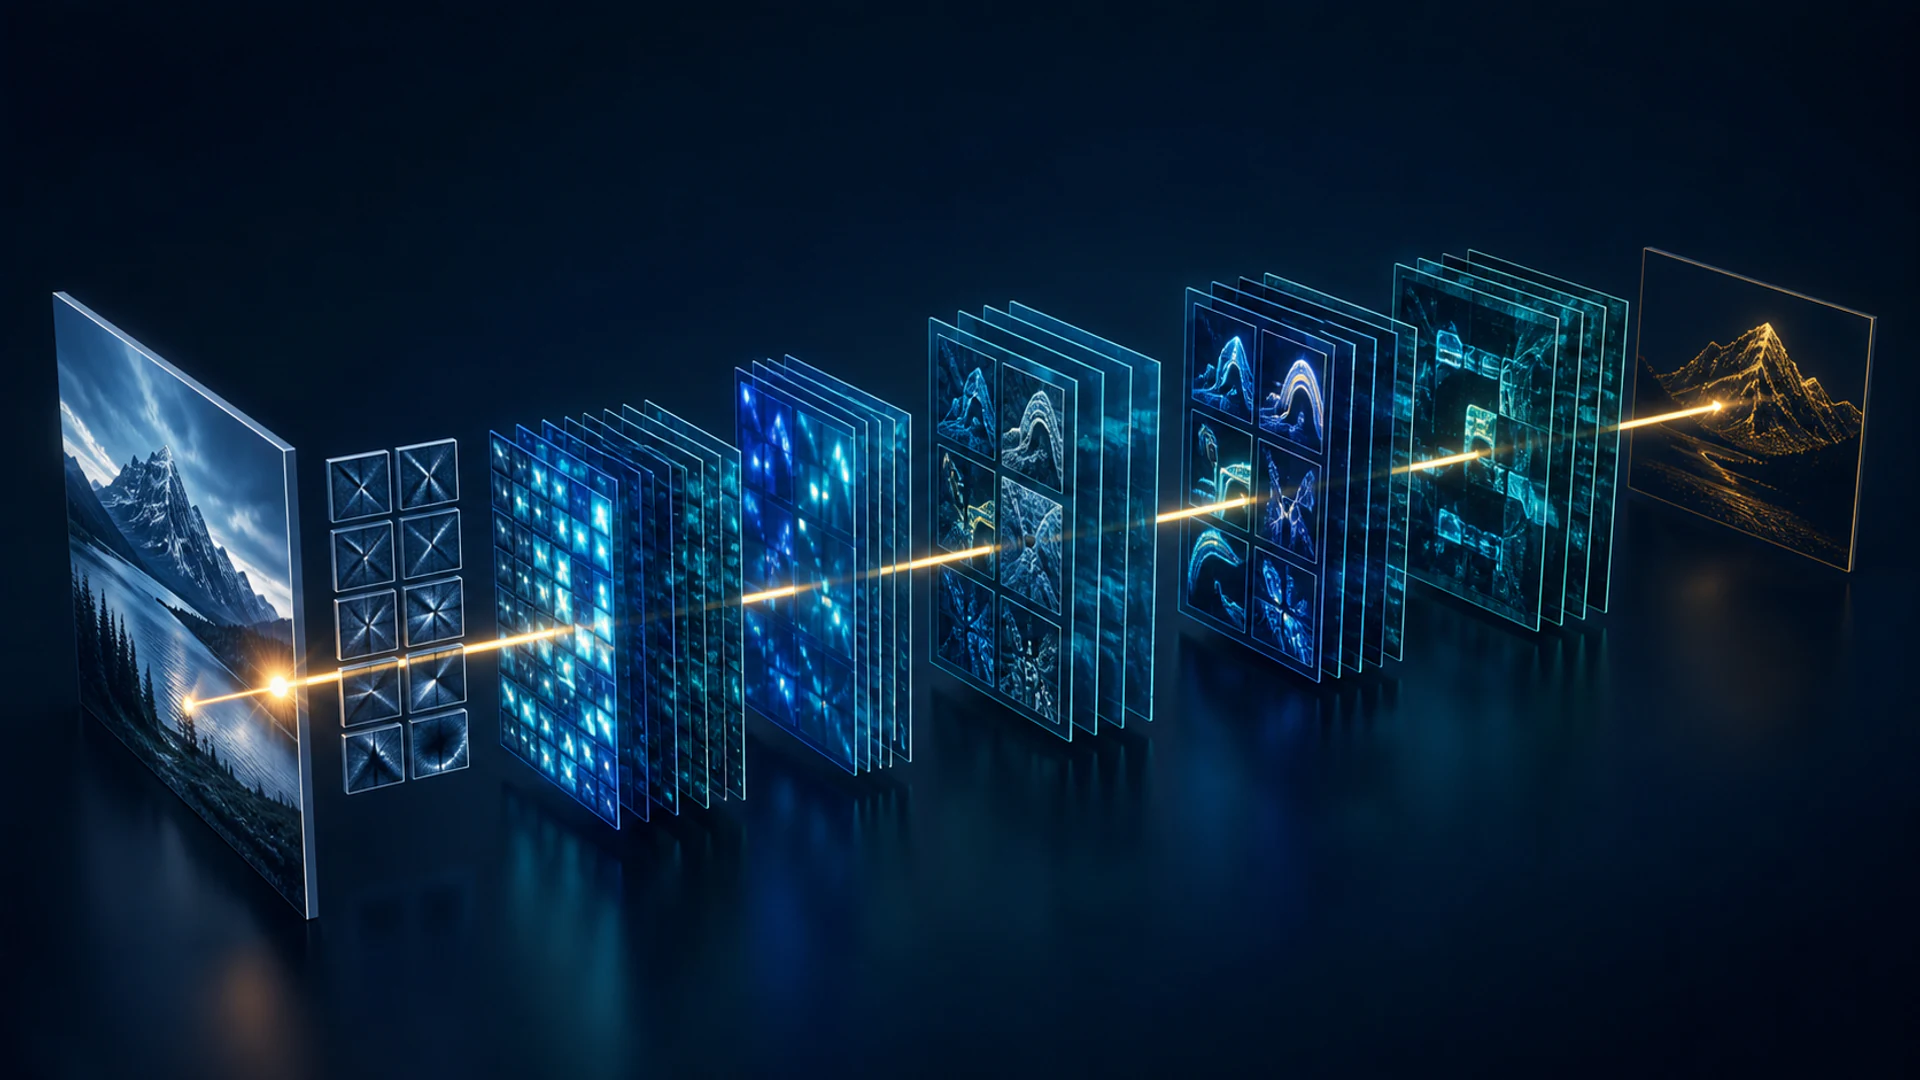
Uma rede neural convolucional (CNN) é uma arquitetura de rede neural que usa filtros aprendidos em regiões locais de uma entrada. As CNNs tornaram‑se fundamentais para a visão computacional moderna porque podem detectar padrões independentemente de onde esses padrões apareçam e reutilizar os mesmos parâmetros em toda a imagem.
Uma CNN não converte uma imagem de forma não numérica para numérica — a imagem já chega como um tensor de valores de pixels. Seu objetivo é transformar esse tensor em mapas de características úteis para classificação, detecção, segmentação ou outra tarefa.
Principais pontos
- Uma convolução combina valores de entrada locais com um kernel aprendido para produzir um mapa de características.
- Stride, padding, dilatação e pooling controlam a resolução espacial e o campo receptivo.
- O compartilhamento de pesos torna as CNNs mais eficientes em parâmetros do que uma rede totalmente conectada sobre pixels brutos.
- Transformadores de visão oferecem uma alternativa, mas as CNNs continuam fortes para sistemas eficientes e com restrição de dados.
Como a convolução funciona
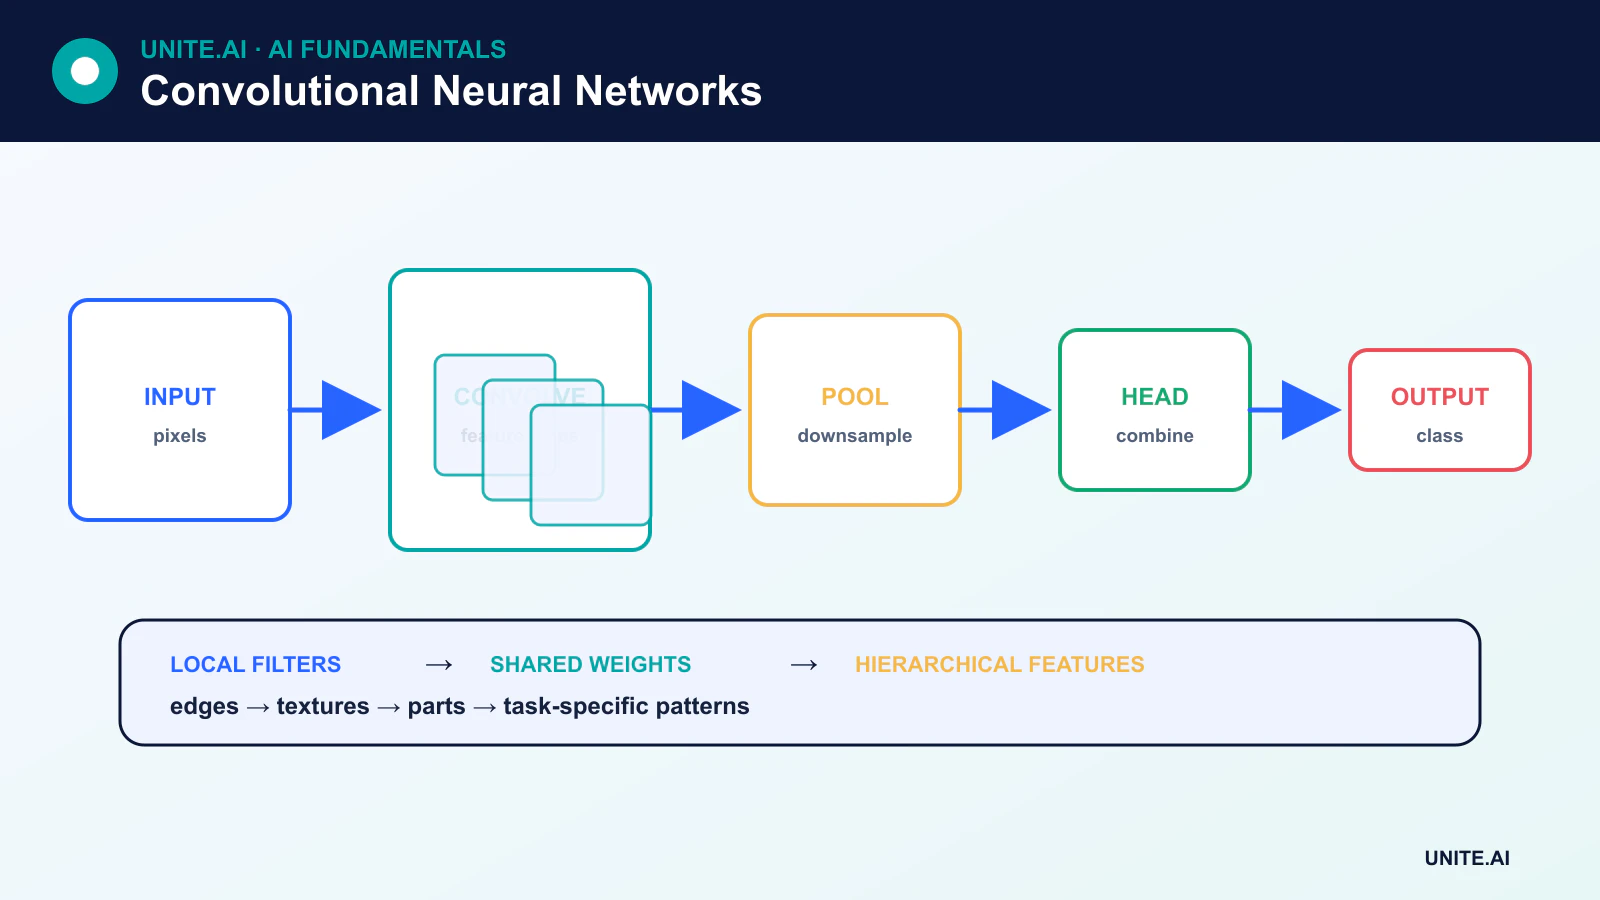
Um kernel é uma pequena grade de pesos treináveis. Em cada posição, a CNN multiplica os valores do kernel pelos valores de entrada correspondentes, soma os resultados e geralmente adiciona um viés. Repetindo isso ao longo da entrada produz um mapa de características.
Para uma imagem colorida, um kernel abrange todos os canais de entrada. Uma camada usa múltiplos kernels para criar múltiplos canais de saída. Durante o treinamento, backpropagation calcula os gradientes desses pesos de kernel; a operação de convolução não fabrica um novo conjunto fixo de pesos a partir de cada imagem.
Stride, padding e dilatação
- Stride controla o quão longe o kernel se desloca. Um stride maior que um reduz a resolução espacial.
- Padding adiciona valores ao redor de uma entrada para que a informação da borda possa ser processada e o tamanho da saída possa ser controlado.
- Dilation espaça os elementos do kernel, expandindo o campo receptivo sem aumentar proporcionalmente os parâmetros.
O campo receptivo é a região da entrada original que pode influenciar uma unidade. Empilhar convoluções o expande, permitindo que características posteriores combinem informações de áreas mais amplas.
Ativação, normalização e pooling
Camadas convolucionais são tipicamente seguidas por ativações não lineares e normalização. O pooling resume regiões locais usando uma operação como máximo ou média. Convoluções com stride aprendidas também podem fazer downsample.
Pooling não é obrigatório. Muitas redes modernas usam pooling global de média próximo à saída em vez de achatar um grande mapa de características em uma pilha totalmente conectada. Isso reduz parâmetros e permite que a rede agregue evidências espaciais.
Uma arquitetura moderna de CNN
Um modelo de visão típico contém um stem, uma sequência de blocos de características, estágios de downsampling e uma cabeça de tarefa. Conexões residuais permitem que um bloco aprenda uma modificação em sua entrada e forneçam uma rota direta para informações e gradientes. O sucesso das redes residuais tornou prático treinar CNNs muito mais profundas.
Cabeças de classificação produzem pontuações de classes. Cabeças de detecção preveem categorias e caixas. Arquiteturas de segmentação adicionam caminhos decodificadores que recuperam detalhes espaciais. O mesmo backbone de CNN pode ser reutilizado por meio de transfer learning.
O que as camadas de CNN aprendem
É comum visualizar filtros iniciais que respondem a bordas ou texturas e representações posteriores que se correlacionam com partes ou objetos. Essa é uma intuição útil, mas não é uma regra fixa. As características dependem da tarefa, arquitetura, dados, objetivo e processo de treinamento, e algumas unidades combinam informações que não se mapeiam claramente para um conceito humano.
CNNs versus transformadores de visão
Transformadores de visão dividem imagens em patches e usam atenção para modelar relações entre eles. Eles podem escalar efetivamente com grandes conjuntos de dados de pré‑treinamento. As CNNs incorporam localidade e suposições relacionadas à translação diretamente na arquitetura, o que pode torná‑las mais eficientes e eficazes em termos de dados em ambientes menores.
Muitos sistemas práticos combinam convolução e atenção. A arquitetura correta depende de precisão, latência, memória, dados de treinamento, hardware e implantação — não de qual família é a mais recente.
Limitações e considerações práticas
As CNNs podem ser sensíveis a mudanças de distribuição, perturbações adversariais, atalhos de fundo e dados de treinamento tendenciosos. Elas não são perfeitamente invariantes a posição, rotação, escala ou ponto de vista. Aumento de dados e escolhas de arquitetura podem melhorar a robustez, mas não a garantem.
Para implantação, meça latência de ponta a ponta, memória, taxa de transferência e comportamento de subgrupos. Quantização e poda podem reduzir custos, especialmente para edge AI, mas modelos comprimidos precisam ser revalidados.
Convolução, campos receptivos e blocos modernos de CNN
Uma camada convolucional desliza kernels aprendidos sobre uma grade e compartilha pesos entre posições. Tamanho do kernel, stride, dilatação e padding determinam a forma da saída e o campo receptivo. Camadas iniciais frequentemente respondem a bordas ou texturas locais; camadas mais profundas combinam informações em regiões maiores, embora as representações aprendidas não precisem mapear claramente para conceitos humanos. Pooling ou convolução com stride reduz a resolução espacial. Canais transportam mapas de características, enquanto convoluções agrupadas e separáveis em profundidade trocam a mistura entre canais por menor custo computacional. Conexões residuais tornam redes muito profundas mais fáceis de otimizar.
Para uma altura e largura de entrada, o padding controla o tratamento das bordas e o stride controla a amostragem. Downsampling agressivo pode apagar objetos pequenos; padding zero pode criar artefatos nas bordas; dilatação expande o contexto sem o mesmo crescimento de parâmetros, mas pode gerar gradeamento. A normalização em lote depende das estatísticas de treinamento, enquanto alternativas podem se comportar melhor em tamanhos de lote pequenos. Arquiteturas modernas combinam gargalos, recursos multiescala, atenção ou residuais invertidos. Selecione a arquitetura usando a resolução da tarefa, largura de banda de memória, latência e hardware alvo, em vez de apenas a precisão em classificação de imagens.
Treinamento, interpretação e implantação
Use aumentos que preservem rótulos e reflitam variações reais, e divida por sujeito ou cena antes do aumento. Transfer learning é comum: substitua a cabeça da tarefa, treine‑a e então descongele cautelosamente o backbone. Avalie desempenho específico por classe, calibração, robustez a desfoque, compressão, iluminação, escala, recorte e perturbação adversarial. Métodos de visualização como mapas de características e saliência podem revelar atalhos, mas são sensíveis ao método e à linha de base. Confirme a dependência suspeita com imagens contrafactuais, testes de oclusão ou mudanças no conjunto de dados.
CNNs exportadas podem ser fundidas, quantizadas ou compiladas para GPU, NPU, navegador ou microcontrolador. Valide o grafo implantado, incluindo pré‑processamento e pós‑processamento, nos dispositivos exatos. Meça latência de ponta a ponta, memória, energia e comportamento térmico; a decodificação de entrada pode dominar um modelo pequeno. Monitore estatísticas da câmera e da imagem, distribuição da saída e erros confirmados. Artefatos de modelo assinados, canais de atualização protegidos e falhas graciosas de sensores fazem parte do design de produção. As CNNs codificam um viés de localidade útil, mas não compreendem automaticamente objetos ou cenas causais.
Exemplo prático: implantando uma CNN em uma câmera de inspeção
Uma CNN classifica defeitos de superfície a partir de imagens de varredura linear de alta resolução. Engenheiros segmentam as imagens com sobreposição para que pequenos defeitos sobrevivam ao downsampling, preservem coordenadas para revisão e validem aumentos contra variações ópticas reais. Uma CNN residual e um modelo depthwise mais leve são comparados com recall igual. Os testes incluem defeitos de borda, reflexos, compressão, movimento, lotes de material e substituições de câmera, com lotes de produção independentes reservados para avaliação final.
A compilação funde e quantiza o modelo para um acelerador de borda, mas o grafo implantado é comparado com a referência em casos sensíveis de defeitos. Decodificação, segmentação, inferência e latência de mesclagem são medidos de ponta a ponta. O sistema sinaliza pixels mortos e deriva de exposição separadamente dos defeitos do produto. Operadores podem inspecionar os tiles de origem e sobrescrever resultados. Alterações no modelo e na câmera são lançadas gradualmente, e a linha mantém um procedimento seguro de inspeção manual quando o pipeline de visão está indisponível.
Evidências de implementação e prontidão operacional
Uma decisão de produção precisa de mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e descontinuação. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Uma CNN sempre precisa de pooling?
Não. Uma CNN pode fazer downsample com convolução de stride e pode preservar a resolução para predição densa. O pooling é uma ferramenta de design, não um requisito definidor.
Os filtros de CNN são projetados manualmente?
Em uma CNN treinada, os valores do kernel são normalmente aprendidos a partir dos dados. Isso difere dos filtros de visão clássicos cujos coeficientes são escolhidos previamente para operações como detecção de bordas.
Referências principais












