
Fundamentos de IA
O que é Aprendizado Few-Shot?

 Adicione Unite.AI às suas fontes preferidas no Google
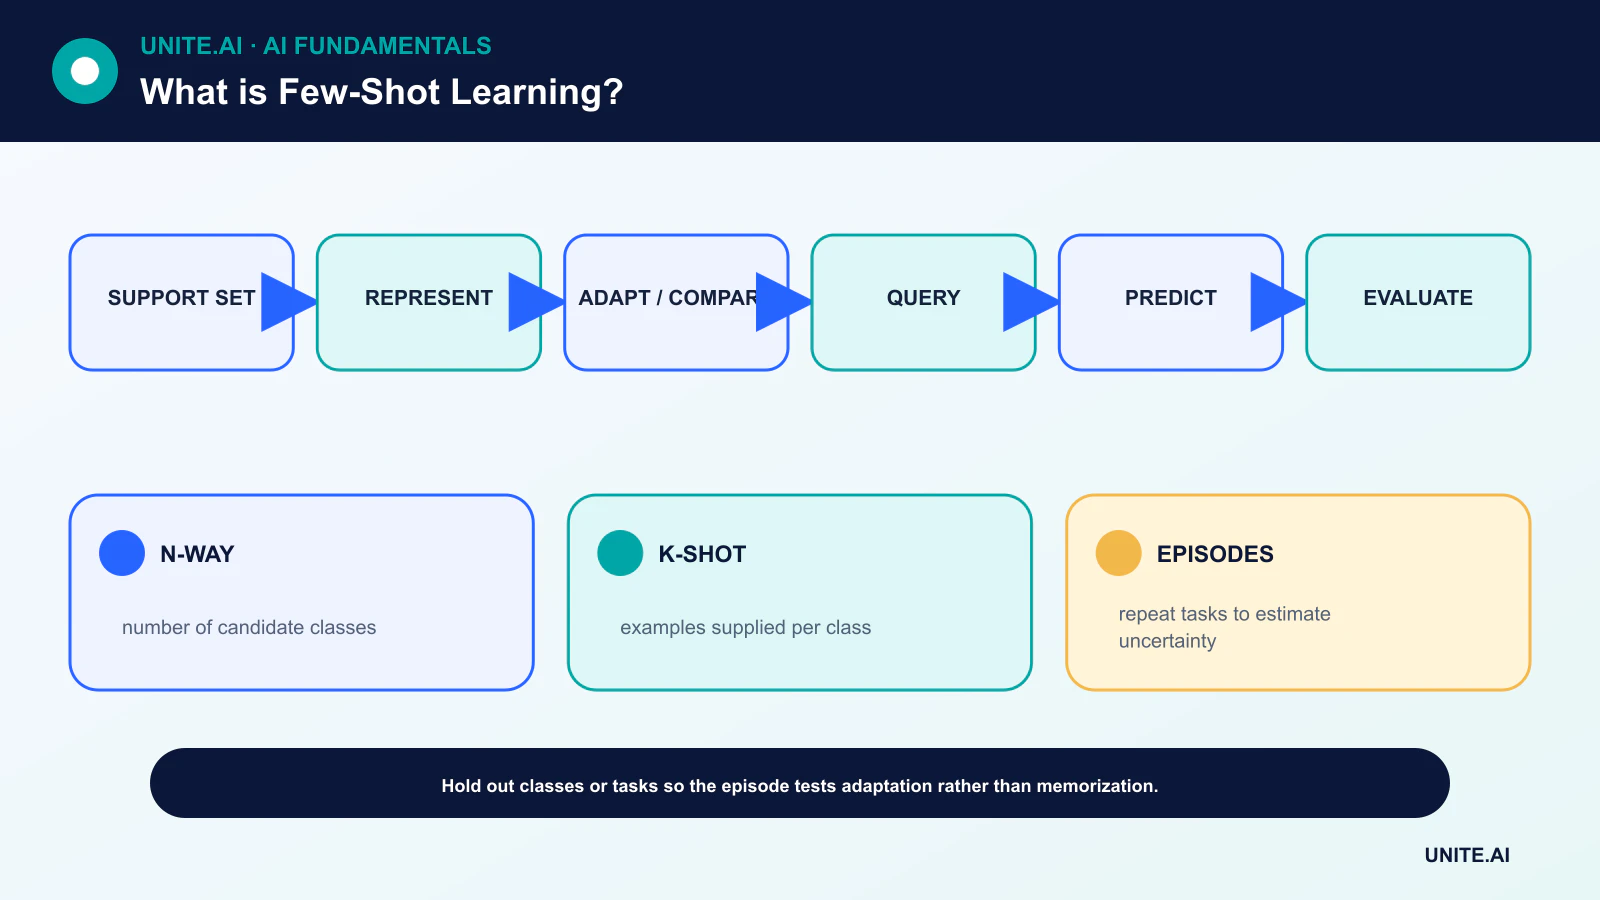
Few-shot learning estuda como um modelo pode se adaptar a uma nova tarefa ou classe a partir de apenas um pequeno número de exemplos rotulados. Em benchmarks clássicos, um episódio fornece um conjunto de suporte — como cinco classes com um ou cinco exemplos por classe — e pede ao modelo que classifique consultas não vistas.
O termo também é usado para aprendizado em contexto, onde um modelo de linguagem pré-treinado recebe algumas demonstrações em seu prompt sem atualizar parâmetros. Esses cenários compartilham o objetivo de poucos exemplos, mas utilizam diferentes mecanismos de adaptação e exigem diferentes projetos de avaliação.
Principais pontos
- N-way K-shot descreve N classes e K exemplos de suporte rotulados por classe.
- Métodos de aprendizado métrico comparam consultas com representações aprendidas dos exemplos de suporte.
- Meta-aprendizado otimiza através de muitas tarefas para que uma nova tarefa possa ser aprendida rapidamente.
- Poucos exemplos ampliam erros de rotulagem, vazamento, ambiguidade de classe e incerteza, portanto linhas de base e relatórios de confiança são importantes.
Episódios, conjuntos de suporte e conjuntos de consulta
Um episódio few-shot separa um pequeno conjunto de suporte rotulado de um conjunto de consulta usado para avaliação. Durante o meta-treinamento, o modelo vê muitos desses episódios. Uma avaliação robusta reserva classes, tarefas ou domínios inteiros, de modo que o episódio de teste mensure a adaptação em vez da memorização.
Relate distribuições de acurácia ao longo de muitos episódios, em vez de uma única amostra conveniente. Compare com linhas de base simples de vizinho mais próximo e lineares; um método sofisticado que não supera uma representação bem treinada somada a um classificador básico pode não justificar sua complexidade.
Aprendizado métrico e protótipos
Redes de correspondência (matching networks) e métodos relacionados incorporam exemplos de suporte e consulta em um espaço onde vetores próximos devem compartilhar o mesmo rótulo. Redes prototípicas (prototypical networks) calculam a média das incorporações de suporte para cada classe e classificam uma consulta de acordo com a distância desses protótipos de classe.
Isso conecta o aprendizado few-shot à qualidade da representação. Um modelo deep-learning pré-treinado pode já organizar bem as características relevantes, enquanto uma representação incompatível pode tornar cada distância enganosa.
Meta-aprendizado baseado em otimização
Model-Agnostic Meta-Learning (MAML) busca parâmetros que podem se adaptar com um pequeno número de passos de gradiente. Outros métodos aprendem um otimizador, uma inicialização ou uma regra de atualização de parâmetros. O loop externo avalia o desempenho pós-adaptação em várias tarefas.
Meta-aprendizado assume que estruturas úteis são compartilhadas entre tarefas de treinamento e de destino. Quando a distribuição de destino difere drasticamente, a adaptação rápida pode falhar. A validação deve variar o número de exemplos (shots), classes, domínios e dificuldade das tarefas, em vez de tratar um benchmark como universal.
Aprendizado por transferência e estratégias ao nível de dados
Transfer learning costuma ser o ponto de partida prático mais forte: congelar um codificador pré-treinado, treinar uma pequena camada final e, então, ajustar finamente de forma seletiva se houver dados suficientes. Aumento de dados pode introduzir invariâncias, mas exemplos sintéticos irrealistas podem amplificar vieses ou criar atalhos.
Aprendizado ativo pode priorizar quais exemplos rotular, enquanto aprendizado semi-supervisionado pode usar dados não rotulados adicionais. Essas são estratégias complementares, não sinônimos de aprendizado few-shot.
Prompting few-shot é diferente
Um transformer pode inferir um padrão a partir de demonstrações inseridas em seu contexto. Nenhuma atualização persistente de parâmetros é necessária. A ordem, a formulação e o balanceamento de rótulos podem mudar materialmente a saída, e os exemplos podem consumir grande parte da janela de contexto.
Utilize um conjunto de avaliação representativo, versione cada prompt e demonstração, e teste alternativas zero-shot, few-shot e finamente ajustadas. Um conjunto de suporte diminuto não sustenta afirmações fortes para toda a população, especialmente em casos raros ou críticos de segurança.
Paradigmas de aprendizado few-shot e construção de tarefas
O aprendizado few-shot tem como objetivo executar uma tarefa a partir de muito poucos exemplos rotulados. Em métodos baseados em métricas, um codificador mapeia exemplos para um espaço onde protótipos ou vizinhos mais próximos representam as classes. Meta-aprendizado baseado em otimização treina uma inicialização ou regra de atualização para adaptação rápida. Aprendizado por transferência ajusta finamente um modelo pré-treinado em um pequeno conjunto alvo. Aprendizado em contexto fornece exemplos em um prompt sem atualizar pesos. Esses mecanismos diferem, portanto as alegações devem especificar se os parâmetros mudam, qual treinamento prévio ocorreu e como os exemplos são selecionados.
A avaliação deve separar classes, tarefas, sujeitos ou domínios de treinamento e teste de acordo com a generalização alegada. Um episódio N-way K-shot contém N classes e K exemplos de suporte por classe, além de exemplos de consulta para pontuação. Episódios repetidos estimam a variância decorrente da seleção de suporte. Para prompting, a ordem dos exemplos, a formulação dos rótulos, o formato e a similaridade das demonstrações podem mudar materialmente os resultados. Compare com linhas de base zero-shot, vizinho mais próximo, linear-probe e ajuste fino ordinário usando a mesma representação e orçamento de dados.
Qualidade dos dados, incerteza e transferência negativa
Com poucos exemplos, casos rotulados incorretamente ou atípicos exercem influência desproporcional. Defina regras de anotação, inspecione cada item de suporte e preserve um resultado desconhecido ou de abstenção. Aumento de dados e exemplos sintéticos podem ajudar apenas quando preservam a tarefa e adicionam variação realista. Um modelo pré-treinado pode transferir atalhos ou vieses de seu domínio de origem. Teste casos fora do domínio, grupos raros e a sensibilidade à remoção de um exemplo de suporte. Relate intervalos de confiança entre tarefas e sementes aleatórias, não um único prompt favorável.
Aprendizado ativo pode solicitar rótulos para casos informativos, enquanto métodos semi-supervisionados utilizam dados não rotulados sob suposições adicionais. Recuperação pode selecionar demonstrações relevantes dinamicamente, mas deve evitar vazamento de rótulos de teste. A adaptação pode sobreajustar rapidamente, portanto restrinja atualizações, use regularização e valide em exemplos separados. Para tarefas críticas, poucos rótulos raramente justificam decisões autônomas; use o modelo para priorizar ou auxiliar a revisão até que haja evidência de resultado suficiente.
Operação em produção
Versione o modelo base, a incorporação ou o modelo de prompt, as demonstrações, o esquema de rótulos e os parâmetros de adaptação. Proteja os exemplos, pois prompts ou gradientes podem expor registros sensíveis. Monitore o desempenho à medida que classes e linguagem mudam, e atualize os exemplos de suporte por meio de revisão governada em vez de rotulagem automática. O aprendizado few-shot reduz a necessidade de rótulos alvo ao explorar estruturas prévias; porém não elimina a necessidade de avaliação representativa, definição cuidadosa de tarefa, expertise de domínio ou um fallback seguro quando a nova tarefa está fora desse contexto.
Exemplo prático: classificação few-shot para um novo produto
Uma equipe de suporte precisa de rótulos de encaminhamento para um produto com apenas cinco exemplos revisados por problema. Ela compara protótipos mais próximos em uma incorporação pré-treinada, uma camada linear, ajuste fino eficiente em parâmetros e prompting em contexto. Famílias de produtos, clientes e mensagens posteriores são mantidos fora do meta-treinamento e da seleção de modelo. Amostragem repetida do conjunto de suporte relata recall por classe, calibração, variância e sensibilidade a uma demonstração rotulada incorretamente.
Mensagens de baixa confiança e sem suporte são encaminhadas ao suporte geral, e revisores corrigem rótulos por meio de uma fila governada. Os exemplos são desidentificados, versionados e nunca selecionados do conjunto de teste final. O monitoramento acompanha novo vocabulário, taxas de classe, correções e divergências. Quando houver rótulos suficientes, o sistema few-shot é comparado ao treinamento supervisionado convencional. Configuração rápida é útil, mas não justifica automação se o desempenho permanecer instável ou se o novo produto diferir substancialmente das famílias de tarefas anteriores.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem-sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas inseridas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também necessita de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O aprendizado one-shot é o mesmo que aprendizado few-shot?
O aprendizado one-shot é o caso especial com um exemplo de suporte rotulado por classe ou tarefa. O aprendizado zero-shot usa nenhum exemplo rotulado de destino.
O aprendizado few-shot elimina a necessidade de dados?
Não. Ele desloca a dependência para dados de pré-treinamento, tarefas relacionadas, representações e suposições. Os rótulos alvo são poucos; o histórico total de aprendizado costuma ser grande.
Referências principais












