
Fundamentos de IA
O que é Aprendizado por Transferência?

 Adicione Unite.AI às suas fontes preferidas no Google
Transfer learning reutiliza o conhecimento aprendido para um problema a fim de melhorar o aprendizado em um problema relacionado. Em vez de inicializar cada parâmetro aleatoriamente, o praticante parte de um modelo ou representação pré‑treinados e o adapta a uma tarefa alvo.
Essa abordagem é especialmente útil quando o conjunto de dados alvo é pequeno, a rotulagem é cara ou o pré‑treinamento requer mais poder computacional do que a equipe alvo pode justificar. Treinar um modelo do zero é a alternativa ao aprendizado por transferência — não um tipo de aprendizado por transferência.
Principais pontos
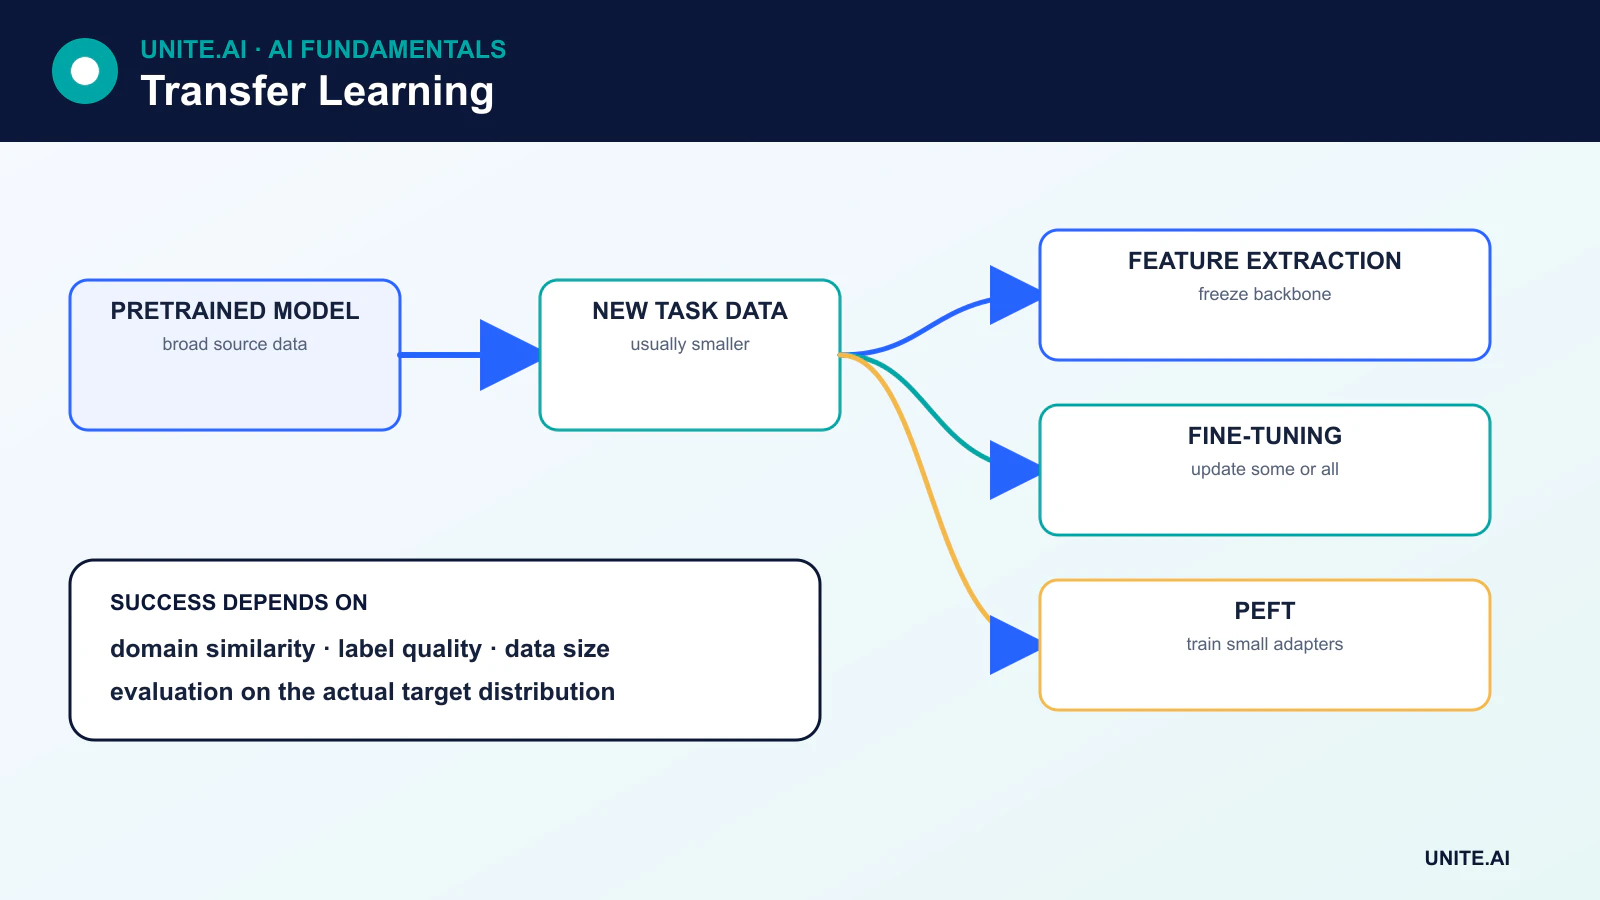
- A extração de características mantém a base pré‑treinada congelada e treina uma nova cabeça específica da tarefa.
- O ajuste fino atualiza alguns ou todos os parâmetros pré‑treinados usando dados do domínio alvo.
- Métodos eficientes em parâmetros, como adapters e LoRA, atualizam uma pequena fração do modelo.
- A transferência pode falhar quando os domínios de origem e alvo diferem, licenças entram em conflito ou o modelo de origem contém viés inadequado.
Por que o aprendizado por transferência funciona
Os modelos frequentemente aprendem representações úteis além dos dados exatos nos quais foram treinados. As camadas iniciais de um modelo de imagem podem capturar padrões locais reutilizáveis; um modelo de linguagem pode aprender sintaxe, semântica e associações amplas a partir de predição auto‑supervisionada. Uma tarefa alvo pode construir sobre essas representações em vez de reaprender tudo a partir de exemplos limitados.
O benefício depende da similaridade entre as tarefas de origem e alvo, da escala e qualidade do pré‑treinamento e da forma como o modelo é adaptado. A reutilização não é garantida: características transferidas podem ser irrelevantes ou até prejudiciais.
Extração de características
Na extração de características, a base pré‑treinada é congelada, de modo que seus parâmetros não mudam. Sua saída torna‑se a entrada para um novo classificador, regressor ou outra cabeça específica da tarefa. Apenas a nova cabeça é treinada.
Isso é rápido e eficiente em dados, e reduz o risco de destruir representações pré‑treinadas úteis. Também pode apresentar subajuste quando o domínio alvo difere substancialmente do pré‑treinamento. Camadas como normalização em lote exigem cuidados especiais, pois suas estatísticas armazenadas e comportamento de treinamento podem afetar a adaptação mesmo quando a maioria dos pesos está congelada.
Ajuste fino
Fine-tuning atualiza os parâmetros pré‑treinados com dados alvo. Um fluxo de trabalho comum é:
- Carregar o modelo pré‑treinado e substituir ou adicionar a cabeça de saída.
- Congelar a base e treinar a nova cabeça.
- Descongelar camadas selecionadas — ou o modelo completo — e continuar com uma taxa de aprendizado menor.
- Validar quanto a overfitting, esquecimento e desempenho no domínio alvo.
Não existe uma regra universal de que apenas as camadas finais devem ser ajustadas. A melhor escolha depende da arquitetura, tamanho dos dados alvo, similaridade de domínio, camadas de normalização, memória e capacidade computacional. O ajuste fino completo pode oferecer mais capacidade, mas requer mais recursos e pode causar esquecimento catastrófico.
Ajuste fino eficiente em parâmetros
Grandes transformers tornam o ajuste fino completo caro. O ajuste fino eficiente em parâmetros (PEFT) modifica ou adiciona um pequeno conjunto de parâmetros enquanto deixa a maior parte do modelo base congelada.
- Adapters inserem pequenos módulos treináveis na rede.
- LoRA representa atualizações de pesos com matrizes de baixa classificação, reduzindo parâmetros treináveis e memória do otimizador.
- Prompt e prefix tuning aprendem entradas contínuas específicas da tarefa ou prefixos internos.
O PEFT pode armazenar muitas adaptações de tarefas em torno de um modelo base, embora a implantação em inferência, a compatibilidade de adapters e a gestão de pesos mesclados ainda exijam engenharia cuidadosa.
Aprendizado por transferência entre tipos de dados
Classificadores de imagem normalmente começam a partir de modelos pré‑treinados em grandes conjuntos de dados de imagens. Sistemas de linguagem partem de um modelo de base e o adaptam por meio de ajuste fino supervisionado, otimização de preferência, recuperação ou uso de ferramentas. Modelos de fala, áudio, proteína e multimodais seguem padrões semelhantes.
A transferência também pode ocorrer sem alterar o modelo original. Um modelo congelado pode gerar embeddings para um classificador subsequente, um sistema de busca por similaridade vetorial ou um pipeline de recuperação.
Deslocamento de domínio e transferência negativa
Deslocamento de domínio ocorre quando as entradas alvo diferem dos dados de origem. Um modelo de imagem médica, por exemplo, pode encontrar equipamentos, populações ou protocolos de aquisição ausentes no pré‑treinamento. Transferência negativa significa que a reutilização piora o desempenho alvo em comparação com uma linha de base adequada treinada do zero.
As equipes devem comparar estratégias de adaptação, avaliar subgrupos significativos e manter um conjunto de teste do domínio alvo. Se a tarefa de origem for mal correspondida, um modelo menor e específico de domínio pode superar um modelo geral maior.
Licenciamento, procedência e segurança
Um modelo baixável não é automaticamente seguro para implantação. Revise a licença, usos permitidos, divulgações dos dados de treinamento, limitações da model‑card e cadeia de dependências. Modelos podem reproduzir vieses, memorizar dados sensíveis ou conter código serializado malicioso. Use formatos confiáveis, escaneie artefatos e carregue pesos não confiáveis em um ambiente isolado.
Quando usar aprendizado por transferência
O aprendizado por transferência é uma escolha padrão forte quando existe um modelo pré‑treinado relevante e os dados alvo são limitados. Treinar do zero pode ser preferível quando o domínio é altamente especializado, a licença é incompatível, o tamanho do modelo excede os limites de implantação ou uma tarefa simples não se beneficia de uma grande representação pré‑treinada. A decisão deve ser validada empiricamente, em vez de presumida a partir da escala do modelo.
O que é transferido e como adaptá‑lo
Aprendizado por transferência reutiliza representações aprendidas em uma tarefa ou conjunto de dados de origem para uma tarefa alvo. Em visão, as características iniciais costumam capturar bordas e texturas; em linguagem, modelos pré‑treinados codificam padrões estatísticos entre tokens e contextos. A transferência funciona quando as representações de origem contêm informação relevante para o alvo, mas diferenças de domínio, rótulo, modalidade e aquisição podem gerar transferência negativa. Comece com uma linha de base pré‑treinada, examine sua licença de treinamento e documentação, e compare‑a com o treinamento de um pequeno modelo específico para o alvo do zero.
A extração de características congela a espinha dorsal e treina uma nova cabeça; o ajuste fino parcial descongela camadas selecionadas; o ajuste fino completo atualiza todo o modelo. Métodos eficientes em parâmetros adicionam adapters ou atualizações de baixa classificação, reduzindo parâmetros treináveis, mas não necessariamente a memória de inferência. Use uma taxa de aprendizado menor para os pesos pré‑treinados, preserve o comportamento de normalização e evite esquecimento catastrófico com agendas, regularização, rehearson ou atualizações restritas quando necessário. Selecione checkpoints com base nos dados de validação alvo e teste várias sementes, pois pequenos conjuntos de dados alvo produzem alta variância.
Dados, avaliação e trade‑offs de implantação
Os dados alvo devem representar as condições de implantação e subgrupos importantes, não apenas ser uma amostra rotulada conveniente. Divida por sujeito, origem, tempo ou localização para impedir que exemplos relacionados cruzem partições. Teste tanto em condições dentro do domínio quanto em condições deslocadas. Compare variantes congeladas, parcialmente ajustadas e totalmente ajustadas quanto à qualidade, calibração, custo de treinamento, latência e robustez. Uma melhoria na pontuação média pode ocultar uma perda em classes raras herdadas do viés de origem. Revise exemplos de falha em busca de atalhos específicos da origem, lacunas de vocabulário ou diferenças de sensores.
Rastreie o modelo base, pesos, tokenizador ou pré‑processamento, adapter, dados e licença como um único grafo de dependências. Modelos base hospedados podem mudar de comportamento; pesos abertos podem introduzir responsabilidades de cadeia de suprimentos e correções. Valide o artefato mesclado ou exportado e escaneie arquivos de modelo de fontes não confiáveis. Em produção, monitore o drift do alvo e o desempenho, e mantenha a capacidade de reverter tanto a adaptação quanto a versão base. A transferência reduz a quantidade de dados alvo necessária; não elimina a rotulagem, avaliação, privacidade ou expertise de domínio.
Exemplo prático: adaptando um modelo de visão a uma nova clínica
Uma clínica adapta um codificador de imagens pré‑treinado para classificar a qualidade da imagem antes da revisão diagnóstica. Verifica a licença do modelo de origem e a modalidade pretendida, coleta dispositivos locais e condições de aquisição, e divide por paciente. Variantes de recurso congelado, adapter, ajuste parcial e ajuste completo são comparadas com uma pequena linha de base local. As métricas incluem recall por classe, calibração, comportamento de subgrupos, custo computacional e sensibilidade a dispositivo, local e artefatos raros.
O modelo adaptado não pode fazer um diagnóstico e encaminha imagens de baixa confiança ou não suportadas para os tecnólogos. A validação de exportação confirma o pré‑processamento local e a equivalência numérica. Versões do modelo, adapter, dispositivo e conjunto de dados são vinculadas no registro. A monitoração detecta novos scanners, mudanças de protocolo e drift de saída, enquanto amostras revisadas periodicamente estimam o desempenho real. Uma atualização do modelo de origem é tratada como uma nova dependência que requer validação; o aprendizado por transferência não justifica a reutilização automática de evidências antigas.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, deslocamento de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, reversões e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique a monitoração com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Referências principais











