
Fundamentos de IA
O que é Metaaprendizagem?

 Adicione Unite.AI às suas fontes preferidas no Google
Metaaprendizagem treina um sistema ao longo de uma distribuição de tarefas para que ele possa se adaptar a uma nova tarefa relacionada usando dados ou computação limitados. costuma ser resumida como “aprender a aprender”, mas o objetivo técnico é mais preciso: otimizar o aprendiz de modo que a experiência em tarefas anteriores melhore a adaptação a uma tarefa posterior.
Metaaprendizagem se sobrepõe ao few-shot learning e ao transfer learning, mas os termos não são intercambiáveis. Few-shot descreve a quantidade de dados-alvo; transfer descreve reutilização; metaaprendizagem explicitamente torna a adaptação entre tarefas parte do treinamento.
Principais pontos
- Meta-treinamento usa muitas tarefas, não apenas muitos exemplos independentes.
- Um episódio N-way K-shot contém N classes e K exemplos de suporte rotulados por classe.
- Métodos baseados em gradiente, baseados em métrica, baseados em memória e otimizadores aprendidos adaptam-se de maneiras diferentes.
- O desempenho depende fortemente de as tarefas de meta-treinamento se assemelharem à tarefa-alvo.
Tarefas, conjuntos de suporte e conjuntos de consulta
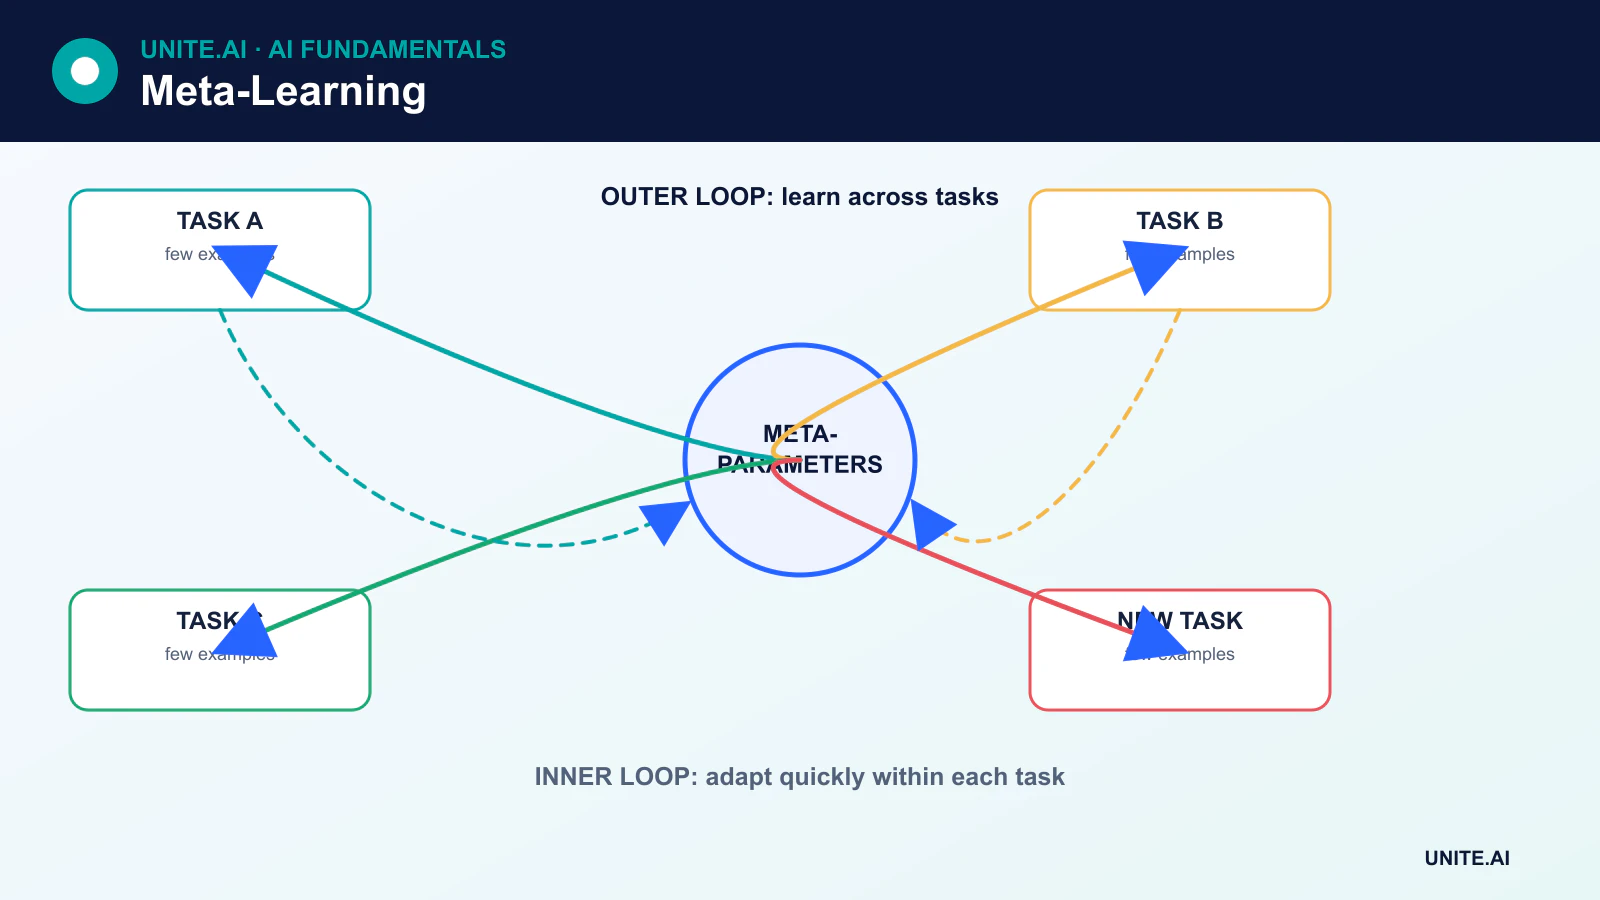
Um conjunto de dados de metaaprendizagem é organizado como tarefas. Na classificação few-shot, um episódio pode ser 5-way 1-shot: cinco classes, um exemplo de suporte rotulado por classe, e exemplos de consulta adicionais usados para avaliar a adaptação. Uma tarefa 5-way 5-shot tem cinco exemplos de suporte para cada uma das cinco classes — não cinco exemplos no total.
Durante o meta-treinamento, o aprendiz adapta repetidamente em um conjunto de suporte e é avaliado em um conjunto de consulta. O objetivo externo melhora o desempenho futuro nas consultas entre tarefas. A meta-validação ajusta escolhas em tarefas separadas, e a meta-testagem avalia tarefas ou classes realmente inéditas.
Metaaprendizagem baseada em gradiente
Model-Agnostic Meta-Learning (MAML) aprende uma inicialização a partir da qual um pequeno número de passos de gradiente produz bom desempenho em uma nova tarefa. O loop interno adapta os parâmetros do modelo usando os dados de suporte. O loop externo atualiza a inicialização compartilhada usando a perda de consulta em tarefas amostradas.
MAML não se limita à classificação; pode ser aplicada à regressão e ao reinforcement learning quando o modelo e a tarefa são diferenciáveis. Reptile oferece uma abordagem de primeira ordem mais simples que move os parâmetros em direção a soluções adaptadas à tarefa sem calcular o meta-gradiente completo do MAML.
Metaaprendizagem baseada em métrica
Métodos baseados em métrica aprendem um embedding no qual exemplos da mesma classe são próximos e classes diferentes são separadas. Uma rede prototípica faz a média dos embeddings de suporte para formar um protótipo por classe e, em seguida, classifica consultas pela distância a esses protótipos.
Redes do tipo Matching e Siamese utilizam mecanismos de similaridade relacionados. Esses métodos não verificam apenas se um modelo “atinge uma métrica-alvo”; a distância ou representação aprendida faz parte do procedimento de predição.
Métodos baseados em memória e otimizadores aprendidos
Sistemas baseados em memória utilizam estado recorrente ou baseado em atenção para armazenar informações sobre a tarefa atual. Otimizadores aprendidos recebem gradientes ou sinais de treinamento como entradas e aprendem como atualizar outro modelo. Esses métodos podem descobrir regras de adaptação, mas adicionam parâmetros, custo computacional e mais um nível de risco de overfitting.
Metaaprendizagem e aprendizado em contexto
Grandes transformers podem adaptar sua saída a partir de exemplos fornecidos em um prompt sem atualizar os pesos. Isso é chamado de aprendizado em contexto. Assemelha‑se ao comportamento da metaaprendizagem, e os dados de treinamento podem incentivar a inferência de tarefa, mas um aprendiz em contexto não é treinado automaticamente com um objetivo clássico de metaaprendizagem episódica.
Onde a metaaprendizagem é útil
Aplicações potenciais incluem personalização, robótica, reconhecimento com poucos recursos, tarefas científicas com poucas medições e adaptação rápida a novos ambientes. A metaaprendizagem é mais atraente quando muitas tarefas‑fonte relacionadas estão disponíveis, mas os dados da tarefa‑alvo são escassos.
Limitações
A metaaprendizagem pode ser computacionalmente cara porque o treinamento aninha a adaptação dentro da otimização. Os resultados são sensíveis à construção das tarefas, vazamento entre suporte/consulta, arquitetura e mudança de domínio. Um modelo treinado em tarefas estreitas e homogêneas pode adaptar‑se mal fora dessa distribuição.
Comparações devem incluir transfer‑learning convencional e linhas de base multitarefa. Uma representação pré‑treinada robusta seguida de fine‑tuning padrão pode ser mais simples e eficaz do que um algoritmo dedicado de metaaprendizagem.
Tarefas, adaptação e a estrutura de otimização interno‑externo
Metaaprendizagem treina sobre uma distribuição de tarefas para que um aprendiz possa adaptar‑se a uma nova tarefa com dados ou atualizações limitados. Cada episódio amostra uma tarefa, divide os exemplos em um conjunto de suporte usado para adaptação e um conjunto de consulta usado para avaliação, e atualiza o conhecimento compartilhado entre episódios. Métodos baseados em métrica aprendem um embedding e uma regra de comparação; métodos baseados em otimização aprendem inicialização ou comportamento de atualização; métodos baseados em memória e modelo condicionam‑se a exemplos da tarefa. A distribuição de tarefas é o dado de treinamento real e deve assemelhar‑se aos problemas de adaptação futuros.
Na meta‑aprendizagem agnóstica ao modelo, um loop interno adapta os parâmetros nos exemplos de suporte e um loop externo otimiza o desempenho nos exemplos de consulta após a adaptação. Gradientes de ordem superior podem ser caros; aproximações de primeira ordem trocam fidelidade por custo. Redes prototípicas representam cada classe por um centróide do conjunto de suporte e classificam por distância. Esses métodos assumem que a geometria das classes, os passos de adaptação e a construção dos episódios refletem o ambiente de implantação. Um método pode parecer aprender rapidamente ao explorar rótulos fixos, artefatos de aquisição ou sobreposição entre conjuntos de dados‑fonte.
Avaliação, linhas de base e limitações do mundo real
Use tarefas de treinamento, validação e teste separadas — não apenas exemplos — para medir a adaptação a tarefas realmente inéditas. Relate acurácia ou perda como função de shots e passos de adaptação, intervalos de confiança entre tarefas, custo computacional, memória e sensibilidade à composição do conjunto de suporte. Compare com transfer learning, fine‑tuning de um modelo pré‑treinado, vizinhos mais próximos e um modelo treinado conjuntamente em todos os dados‑fonte. Muitos ganhos aparentes da metaaprendizagem diminuem quando as linhas de base recebem backbones, aumentação e ajuste equivalentes.
As implantações reais precisam de um meio de reconhecer quando uma nova tarefa está fora da distribuição de meta‑treinamento. Exemplos de suporte pobres ou rotulados incorretamente podem causar falhas rápidas e confiantes. Limite a magnitude das atualizações, valide os modelos adaptados, preserve uma alternativa de segurança e proteja os dados de adaptação contra envenenamento. Monitore o modelo base, o amostrador de tarefas, as sementes dos episódios e o código de adaptação. A metaaprendizagem é útil para famílias recorrentes de problemas com poucos dados, mas não cria capacidade de aprendizado geral a partir de exemplos arbitrários e não elimina a necessidade de avaliação específica de domínio.
Exemplo prático: adaptação few-shot entre máquinas
Um fabricante trata cada tipo de máquina como uma tarefa e meta‑treina uma representação de anomalia em muitas máquinas com resultados de manutenção verificados. Máquinas de teste são totalmente excluídas do treinamento de tarefas. Para uma nova máquina, um pequeno conjunto de suporte cobre os modos operacionais normais em vez de minutos arbitrários de dados. A metaaprendizagem é comparada com um codificador pré‑treinado congelado, vizinhos mais próximos e fine‑tuning convencional usando os mesmos exemplos de suporte e o mesmo custo computacional.
A avaliação repete muitas seleções de suporte e relata recall de eventos, falsos alarmes, tempo de adaptação e variância. O sistema abstém‑se quando o conjunto de sensores ou a dinâmica da nova máquina ficam fora da distribuição de tarefas. As atualizações de adaptação são limitadas e revisadas antes de influenciar a manutenção. Rótulos de suporte e a identidade da máquina são protegidos contra envenenamento, e cada modelo adaptado mantém sua versão base e exemplos. A adaptação rápida é aceita somente se superar consistentemente a transferência mais simples sob mudanças realistas de tarefa.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um rollout em etapas, preserve uma alternativa segura e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise as evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O prompting few-shot é metaaprendizagem?
O prompting few-shot é uma técnica de adaptação em contexto. Pode exibir comportamento associado ao aprendizado entre tarefas, mas não é treinado automaticamente com episódios de suporte/consulta ou um loop de meta‑otimização explícito.
Qual é o maior risco da metaaprendizagem?
Um descompasso entre as tarefas de meta‑treinamento e a tarefa‑alvo pode fazer com que a adaptação rápida pareça forte em um benchmark, mas falhe na implantação. Divisões de tarefas e a proveniência das fontes devem ser auditadas com o mesmo rigor das divisões tradicionais de treino/teste.
Referências principais











