
Fundamentos de IA
O que é Descida do Gradiente?

 Adicione Unite.AI às suas fontes preferidas no Google
Descida do gradiente é um método de otimização que ajusta os parâmetros do modelo para reduzir uma função objetivo. No treinamento de redes neurais, esse objetivo costuma ser uma perda calculada sobre os exemplos. O gradiente aponta na direção do maior aumento local, portanto a descida do gradiente dá um passo na direção oposta.
O gradiente descreve a sensibilidade local; sua magnitude não é uma medida direta de quão rápido um modelo está “aprendendo”. O progresso real também depende da taxa de aprendizado, curvatura, ruído, parametrização, estado do otimizador e dos dados.
Principais pontos
- Backpropagation calcula gradientes, enquanto a descida do gradiente os usa para atualizar os parâmetros.
- A otimização por mini-batch é a abordagem prática padrão para deep learning.
- A taxa de aprendizado controla a escala da atualização e pode seguir um cronograma ao invés de diminuir após cada passo.
- Momentum, AdamW, clipping e normalização abordam diferentes problemas de otimização.
A regra básica de atualização
Para o vetor de parâmetros θ, taxa de aprendizado η e perda L:
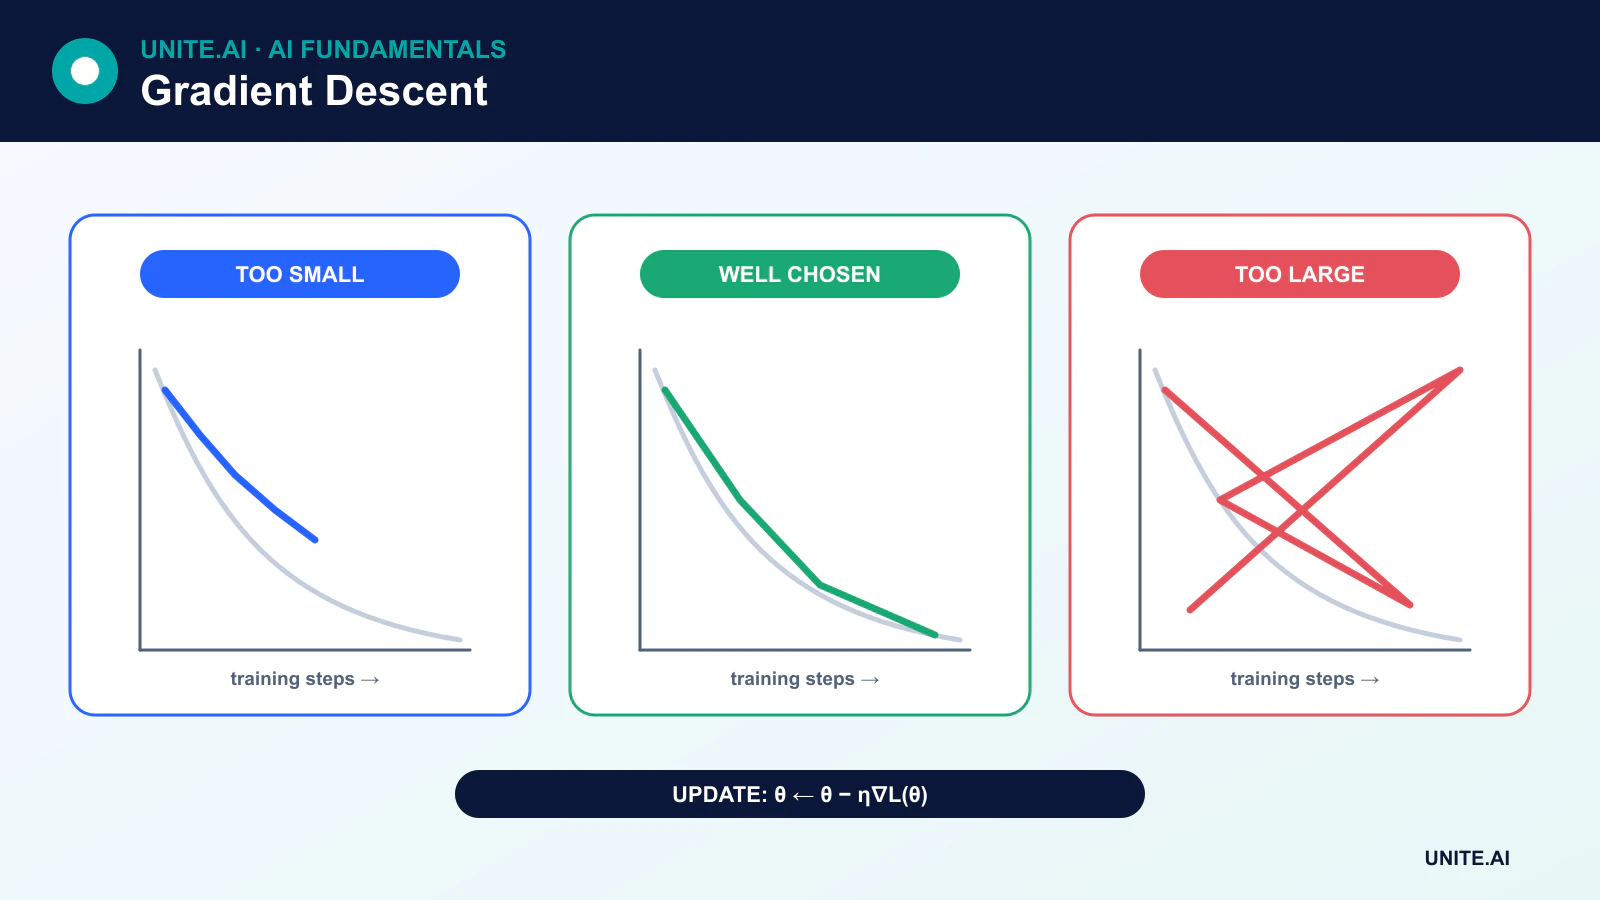
θ ← θ - η∇L(θ)
O gradiente ∇L(θ) contém uma derivada parcial por parâmetro. Subtrair esse gradiente move localmente para baixo. Um ponto estacionário tem gradiente zero, mas pode ser um mínimo, máximo, ponto de sela ou região plana. As superfícies de perda em deep learning são não convexas, portanto o treinamento não garante encontrar um mínimo global único ou perda zero.
Métodos batch, estocástico e mini-batch
Descida do gradiente batch
A descida do gradiente batch calcula o gradiente usando todo o conjunto de treinamento a cada atualização. A estimativa é estável, mas pode ser cara em tempo e memória, e uma atualização pode subutilizar aceleradores modernos.
Descida do gradiente estocástica
A descida do gradiente estocástica estrita usa um exemplo selecionado aleatoriamente por atualização. Seus gradientes são ruidosos, o que pode ajudar na exploração da superfície de perda, mas operações de um único exemplo podem ser ineficientes em hardware paralelo.
Descida do gradiente mini-batch
O treinamento mini-batch estima o gradiente a partir de um subconjunto de exemplos. Ele equilibra o ruído estatístico com operações matriciais eficientes e é a abordagem usual em deep learning. O tamanho do batch afeta memória, taxa de transferência, ruído do gradiente, normalização e, às vezes, a generalização.
Escolhendo uma taxa de aprendizado
Uma taxa que seja muito alta pode ultrapassar regiões úteis ou causar divergência. Uma taxa muito baixa pode tornar o treinamento impraticavelmente lento ou estagnar em regiões planas. A melhor escala depende do otimizador, tamanho do batch, modelo, inicialização e objetivo.
Os cronogramas podem aquecer gradualmente, decair em marcos, seguir uma curva cosseno ou responder ao progresso da validação. A taxa não precisa diminuir monotonicamente após cada atualização. Reinícios quentes e cronogramas cíclicos aumentam deliberadamente a taxa em partes do treinamento.
Momentum
Momentum mantém uma média móvel exponencial dos gradientes passados. Ele pode acelerar o progresso ao longo de direções consistentes e reduzir oscilações em direções íngremes e estreitas. O momentum no estilo Nesterov avalia ou aproxima o gradiente após olhar adiante ao longo da direção do momentum.
Otimizadores adaptativos
RMSProp escala as atualizações usando uma média móvel dos gradientes ao quadrado. Adam combina momentos de primeira ordem semelhantes ao momentum com escalonamento de segundo momento. AdamW desacopla a decaimento de peso da atualização adaptativa do gradiente e é amplamente usado para transformers.
Otimizadores adaptativos costumam facilitar o treinamento inicial, mas não são automaticamente superiores para todo modelo ou objetivo final de generalização. Comparações de otimizadores exigem cronogramas correspondentes e ajuste cuidadoso.
Clipping e acumulação de gradiente
O clipping de gradiente limita a norma ou os valores de um gradiente para reduzir o impacto de gradientes explosivos, especialmente em treinamentos recorrentes ou instáveis. A acumulação de gradiente soma gradientes de vários batches menores antes de uma atualização, aproximando um batch efetivo maior quando a memória é limitada.
Monitoramento da otimização
Acompanhe a perda de treinamento e validação, métricas da tarefa, taxa de aprendizado, normas de gradiente, normas de parâmetros e erros numéricos. Uma queda na perda de treinamento acompanhada de piora no desempenho de validação indica overfitting, não um sucesso de otimização que deva continuar automaticamente.
A otimização minimiza o objetivo que lhe é dado. Uma baixa perda não prova que os dados, a métrica ou o comportamento no mundo real sejam adequados. Vazamento, rótulos ruins e um objetivo desalinhado podem produzir um modelo bem otimizado, porém prejudicial.
Geometria da otimização e regras de atualização
A descida do gradiente atualiza os parâmetros na direção oposta ao gradiente de uma perda. A descida full-batch usa todos os exemplos de treinamento a cada passo; a descida estocástica usa um; os métodos mini-batch estimam o gradiente a partir de um subconjunto e dominam o deep learning. A taxa de aprendizado define a escala do passo. Muito pequena desperdiça computação ou estagna; muito grande oscila ou diverge. Momentum acumula uma direção móvel, enquanto métodos adaptativos como Adam escalam as coordenadas usando momentos do gradiente. Seus diferentes vieses implícitos podem gerar modelos com perda de treinamento similar, mas generalização diferente.
Superfícies de perda em redes neurais contêm regiões planas e agudas, pontos de sela, simetrias e direções mal condicionadas. Escalonamento de características, normalização, inicialização, conexões residuais e pré‑condicionamento alteram a geometria vista pelo otimizador. Cronogramas podem aquecer, decair, ciclar ou reagir a platôs. Decaimento de peso é distinto de simplesmente adicionar uma penalidade L2 em alguns otimizadores adaptativos. O tamanho do batch afeta ruído, memória, paralelismo e o regime da taxa de aprendizado, portanto comparações de otimizadores exigem orçamentos de treinamento correspondentes e ajuste cuidadoso.
Diagnóstico, reprodutibilidade e interrupção
Acompanhe a perda de treinamento e validação, métricas da tarefa, normas de gradiente e de parâmetros, taxa de aprendizado, taxa de transferência e avisos numéricos. Divergência pode surgir de batches corrompidos, rótulos inválidos, precisão mista instável ou redução de perda incorreta. Platôs podem indicar capacidade insuficiente, ativações saturadas, características pobres, regularização excessiva ou problema de cronograma. Overfitting requer dados, aumento, regularização ou early stopping — não uma alegação de que o otimizador falhou. Inspecione erros representativos e compare uma linha de base simples antes de aumentar a complexidade do treinamento.
Reprodutibilidade requer sementes, ordem dos dados, código, configuração, versões de hardware e bibliotecas, embora alguns kernels de aceleradores permaneçam não determinísticos. Salve checkpoints com o estado do otimizador e do scheduler para que o treinamento possa ser retomado de forma consistente. Selecione um checkpoint com base em critérios de validação definidos previamente e reserve um conjunto de teste intocado. No treinamento distribuído, confirme o tamanho efetivo do batch, a média dos gradientes e o tratamento de workers falhos. A otimização minimiza o objetivo escolhido nos dados disponíveis; não garante probabilidades calibradas, raciocínio causal, justiça, segurança ou utilidade no mundo real.
Exemplo prático: ajustando um otimizador para um modelo de linguagem
Uma equipe fixa o tokenizador, a ordem dos dados, o modelo, o batch efetivo e o orçamento de tokens de treinamento, então compara SGD com momentum e AdamW em cronogramas de taxa de aprendizado defensáveis. Aquecimento, decaimento, decaimento de peso, clipping e precisão são registrados. Cada candidato executa várias sementes, e a validação usa um intervalo de tempo reservado mais avaliações de tarefa. Taxa de transferência e energia são reportadas junto com a perda, de modo que um otimizador ligeiramente melhor não seja escolhido a custo desproporcional.
Diagnósticos revelam se a instabilidade tem origem em um fragmento de dados, tamanho de passo excessivo, subfluxo ou arquitetura do modelo. Checkpoints preservam o estado do otimizador e do scheduler e são retomados em um teste. A escolha final baseia‑se na qualidade e robustez da validação, não na menor perda de treinamento. Um conjunto de teste selado é executado uma vez após a seleção. A inferência em produção é calibrada e monitorada separadamente porque o sucesso do otimizador durante o pré‑treinamento não garante comportamento seguro ou verídico.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A descida do gradiente sempre alcança o mínimo global?
Não. Para objetivos convexos, condições adequadas fornecem garantias fortes. Os objetivos de redes profundas são não convexos, e otimizadores práticos geralmente buscam uma solução útil ao invés de provar que encontraram o mínimo global único.
Por que um gradiente zero pode ser enganoso?
Um gradiente zero ou muito pequeno pode indicar um mínimo, máximo, ponto de sela, saturação ou platô plano. Os diagnósticos de treinamento devem considerar o histórico de perda, curvatura, escala dos parâmetros e desempenho de validação.
Referências principais












