Fundamentos de IA
O que é Aprendizado por Reforço?

 Adicione Unite.AI às suas fontes preferidas no Google
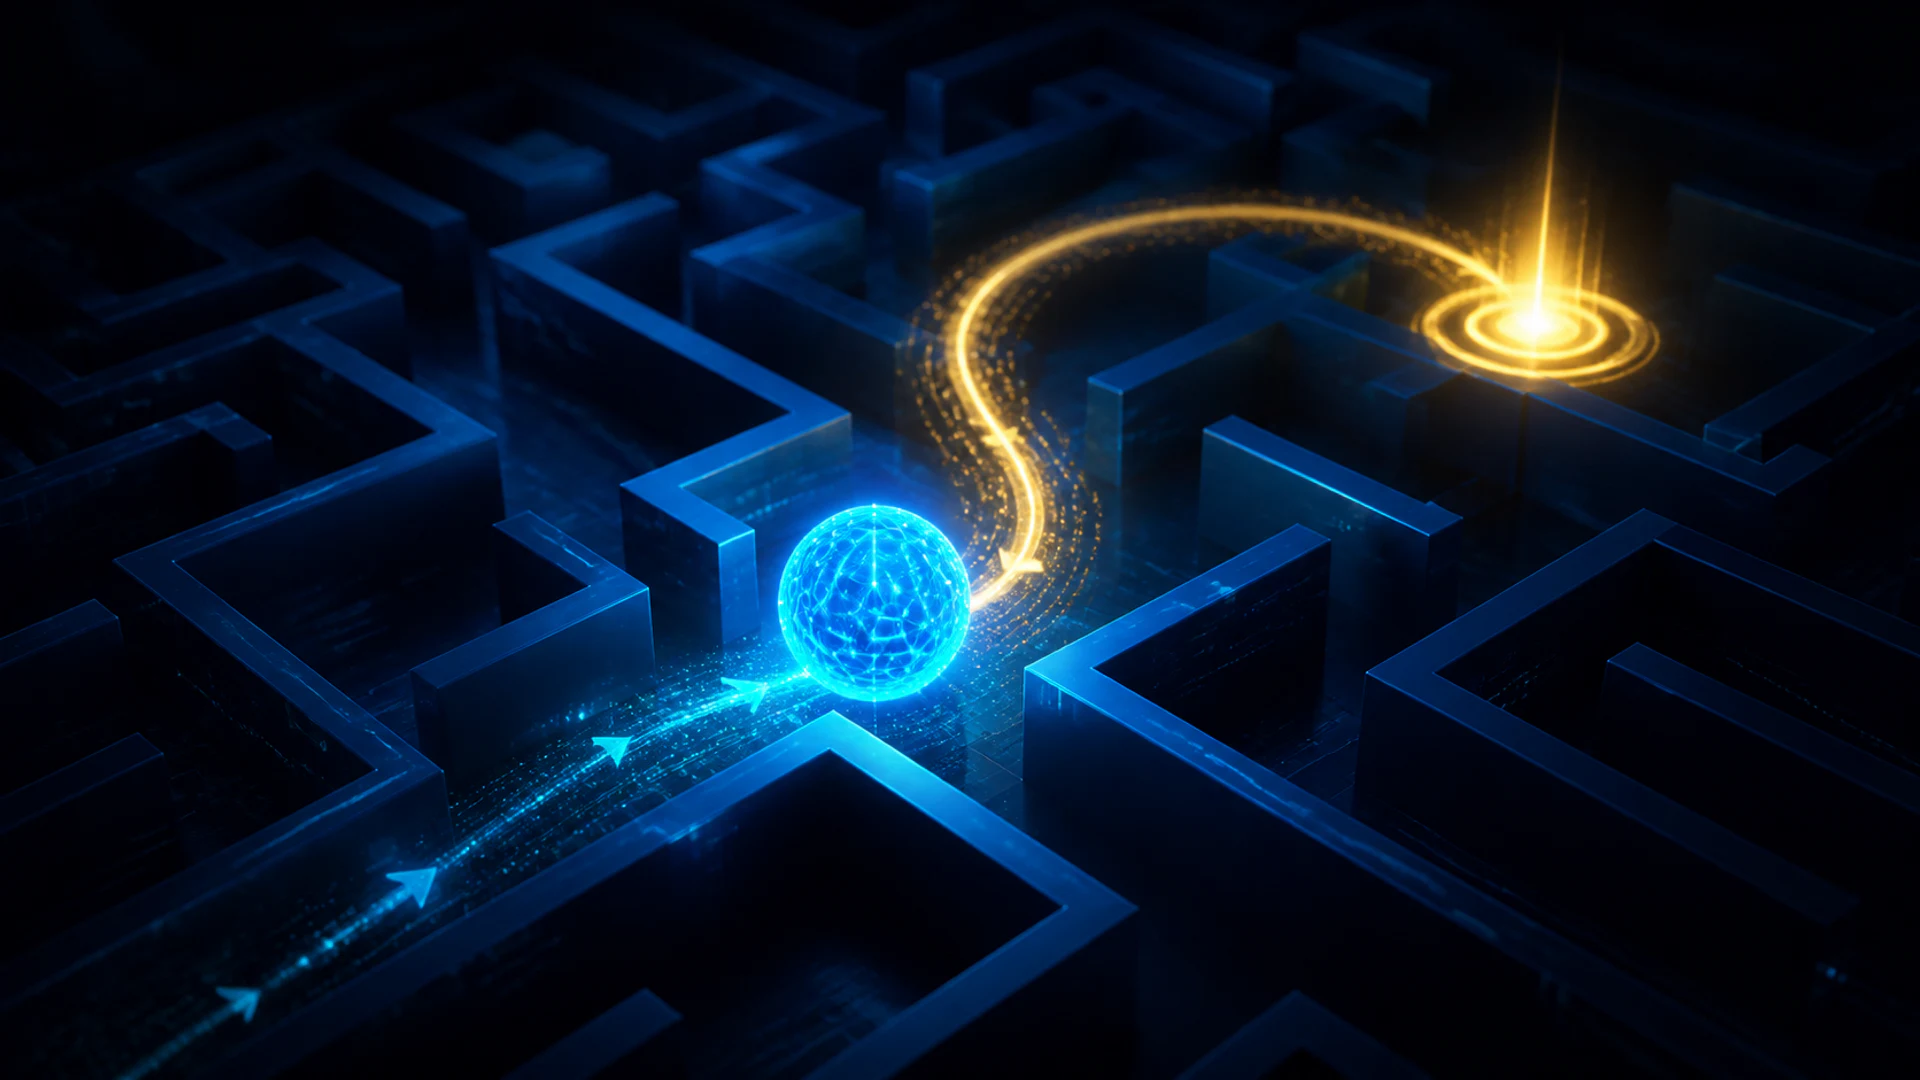
Reinforcement learning (RL) é uma estrutura de aprendizado de máquina na qual um agente aprende como agir interagindo com um ambiente. Após cada ação, o ambiente muda e pode devolver uma recompensa. O objetivo do agente é aprender uma política que maximize a recompensa cumulativa esperada, não apenas a recompensa da sua próxima ação.
RL é usado quando as decisões se desenrolam ao longo do tempo e uma ação influencia o que acontece a seguir. É conceitualmente diferente do aprendizado supervisionado, onde um conjunto de dados fornece uma resposta-alvo para cada exemplo de treinamento.
Principais pontos
- Um problema de RL contém um agente, ambiente, estados, ações, recompensas e uma política.
- Reforço positivo e negativo aumentam o comportamento; punição diminui o comportamento.
- O agente deve equilibrar a exploração de ações desconhecidas com a exploração de ações já conhecidas como eficazes.
- Métodos baseados em valor, baseados em política, ator‑crítico, baseados em modelo e offline resolvem diferentes cenários de RL.
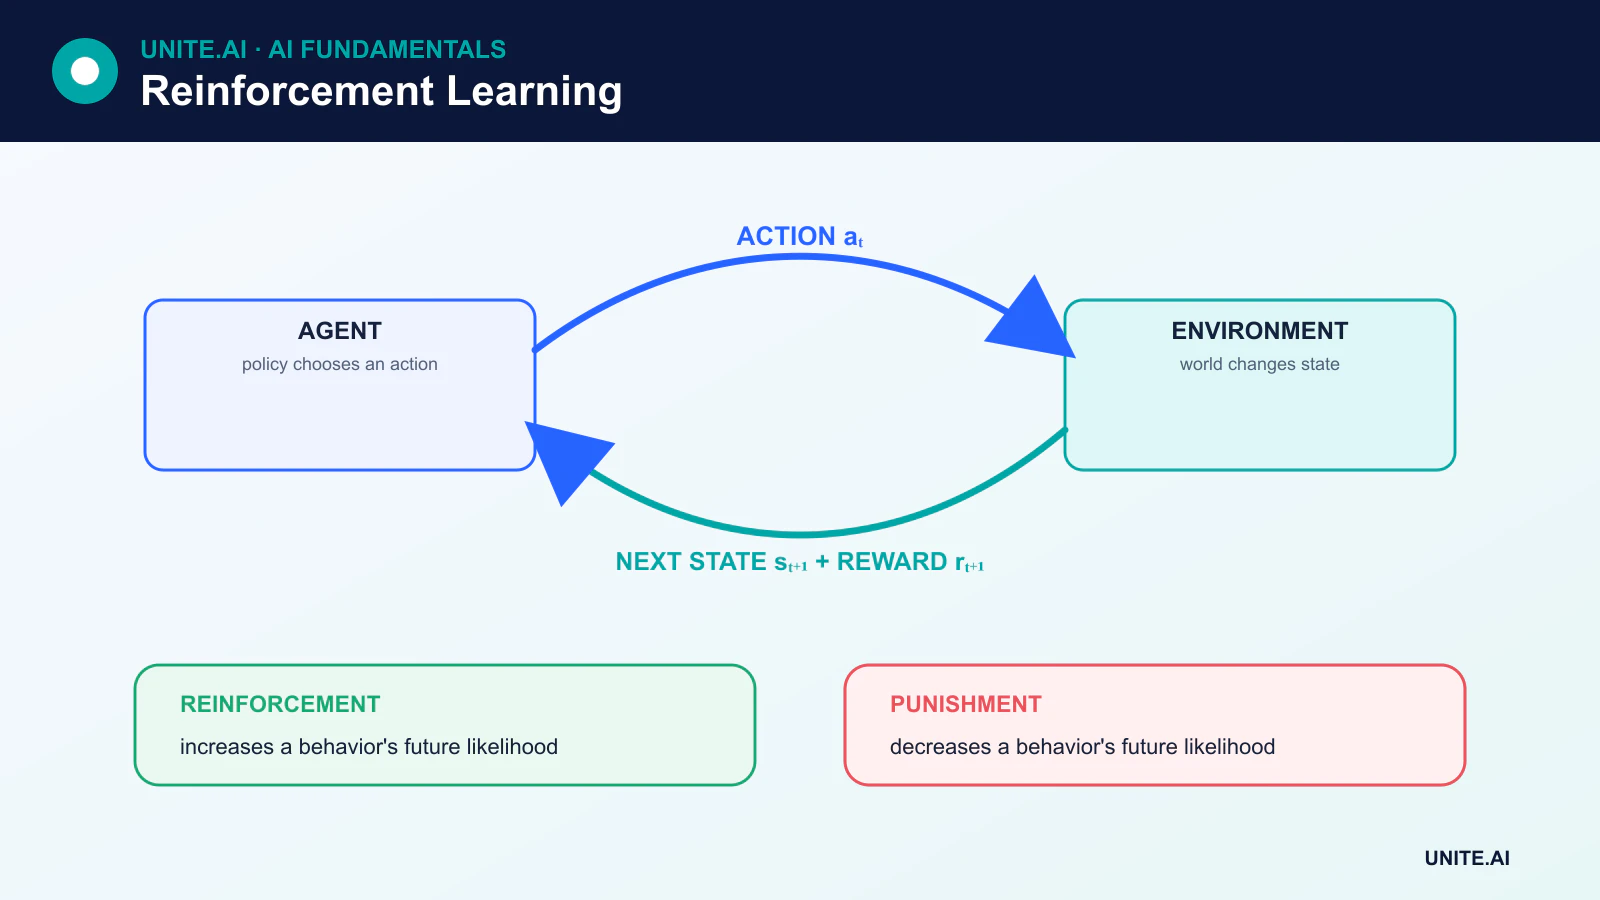
Os componentes do aprendizado por reforço
Muitos problemas de RL são modelados como um processo de decisão de Markov (MDP). Um MDP inclui:
- Estado: informação que descreve a situação atual.
- Ação: uma escolha disponível ao agente.
- Transição: como o estado muda após uma ação.
- Recompensa: feedback imediato produzido por uma transição.
- Política: a estratégia do agente para selecionar ações.
- Fator de desconto: o quanto as recompensas futuras contam em relação às recompensas imediatas.
Um estado não precisa expor tudo sobre o mundo. Quando informações importantes estão ocultas, o problema pode ser parcialmente observável e o agente pode precisar de uma memória ou estado de crença.
Reforço não é o mesmo que punição
A terminologia vem da psicologia comportamental. Reforço positivo adiciona uma consequência que torna um comportamento mais provável. Reforço negativo remove uma condição desagradável e também torna um comportamento mais provável. Uma penalidade destinada a tornar uma ação menos provável é punição, não reforço negativo.
Em aprendizado de máquina, os praticantes costumam falar diretamente sobre recompensas positivas, recompensas negativas, custos e penalidades. A questão essencial é como esses sinais moldam o retorno que o agente tenta maximizar.
Retorno, valor e atribuição de crédito
Uma recompensa descreve uma transição. O retorno combina recompensas ao longo do tempo, geralmente descontando recompensas que chegam mais longe no futuro. Uma função de valor de estado estima o retorno esperado a partir de um estado, enquanto uma função de valor de ação estima o retorno esperado após executar uma ação específica naquele estado.
Isso cria o problema de atribuição de crédito: se um resultado útil chega muito depois, quais ações anteriores merecem crédito? Algoritmos de RL diferem em como estimam essa relação.
Aprendizado Monte Carlo e de diferença temporal
Métodos Monte Carlo aprendem a partir de retornos amostrados completos, tipicamente após o fim de um episódio. Métodos de diferença temporal (TD) atualizam uma estimativa antes do resultado final combinando a recompensa observada com uma estimativa do que vem a seguir. O aprendizado TD, portanto, faz bootstrapping a partir de suas estimativas de valor atuais.
Nenhuma das famílias é universalmente melhor. Alvos Monte Carlo são imparciais sob a política amostrada, mas podem ter alta variância e exigem a conclusão do episódio. Métodos TD podem aprender online e a partir de tarefas contínuas, mas seus alvos bootstrapped introduzem viés.
Exploração versus exploração
Exploração coleta informações tentando ações cujo valor é incerto. Exploração (exploitation) seleciona a ação que atualmente se acredita oferecer o melhor retorno. Um agente que nunca explora pode se acomodar com uma estratégia ruim; um agente que nunca explora (exploitation) falha em aproveitar o que aprendeu.
Estrategias simples incluem seleção de ação epsilon‑gulosa, exploração baseada em confiança, bônus de entropia e métodos de recompensa intrínseca. Em ambientes críticos de segurança, a exploração irrestrita pode ser inaceitável, portanto simulação, restrições, dados offline ou supervisão humana tornam‑se importantes.
Principais abordagens de aprendizado por reforço
Métodos baseados em valor
Q‑learning e algoritmos relacionados aprendem valores de ação e derivam uma política selecionando ações de alto valor. Aprendizado profundo por reforço usa redes neurais para aproximar funções de valor ou políticas quando os espaços de estado são muito grandes para uma tabela.
Métodos de gradiente de política
Métodos de gradiente de política ajustam diretamente uma política parametrizada para melhorar o retorno esperado. São úteis para ações contínuas e políticas estocásticas, mas podem ter estimativas de gradiente de alta variância.
Métodos ator‑crítico
Um ator escolhe ações enquanto um crítico estima o valor e fornece um sinal de aprendizado. Isso combina otimização direta de política com estimativa de valor.
RL baseado em modelo e livre de modelo
Sistemas baseados em modelo aprendem ou utilizam um modelo de transições e recompensas para que possam planejar. Sistemas livres de modelo aprendem valores ou políticas sem modelar explicitamente o ambiente. Métodos baseados em modelo podem usar a experiência de forma eficiente, mas erros no modelo aprendido podem enganar o planejamento.
Aprendizado por reforço offline
RL offline aprende a partir de um conjunto de dados fixo ao invés de coletar novas interações durante o treinamento. Pode reduzir o custo ou risco da exploração, mas o agente deve evitar superestimar ações pouco representadas nos dados.
RLHF e preferências humanas
Aprendizado por reforço a partir de feedback humano (RLHF) usa dados de preferência para treinar um sinal de recompensa ou otimizar diretamente uma política. Tem sido usado para alinhar o comportamento de modelos de linguagem com julgamentos humanos. A otimização de preferência não garante verdade ou segurança: os resultados dependem de quem forneceu o feedback, do que foi solicitado julgar e de como o objetivo foi projetado.
Limitações
RL pode exigir um número enorme de interações, comportar‑se de forma instável durante o treinamento e explorar atalhos não intencionais em uma função de recompensa. Avaliar é difícil porque os resultados podem variar com sementes aleatórias e detalhes do ambiente. Boas práticas incluem múltiplas execuções, linhas de base transparentes, objetivos restritos, testes fora da distribuição e monitoramento de manipulação de recompensas.
Projetando um problema de RL: estado, ação, recompensa e horizonte
O aprendizado por reforço modela decisões sequenciais. O ambiente produz uma observação, o agente seleciona uma ação segundo uma política, e uma transição gera uma recompensa e a próxima observação. Um processo de decisão de Markov assume que o estado contém as informações necessárias para prever transições e recompensas futuras; a observabilidade parcial requer memória, estado de crença ou representações recorrentes. O desconto controla o peso de resultados atrasados, enquanto tarefas episódicas e contínuas exigem definições diferentes de retorno. Um mau projeto de estado ou ação pode tornar um objetivo solucionável impossível de aprender.
O design de recompensa especifica o comportamento indiretamente e é uma fonte importante de falhas. Um proxy pode ser explorado: um agente recompensado por velocidade pode ignorar a segurança, enquanto um recompensado apenas ao concluir a tarefa pode receber pouco sinal de aprendizado. Adicione restrições e regras de terminação baseadas em requisitos reais, teste a sensibilidade da recompensa e inspecione trajetórias em busca de estratégias não intencionais. Métodos de exploração equilibram a coleta de informação com a exploração do conhecimento atual. Dados fora da política podem melhorar a eficiência de amostragem, mas o descompasso entre a política de comportamento e a política‑alvo requer algoritmos projetados para isso.
Avaliação, simulação e implantação segura
Métodos baseados em valor estimam o retorno esperado para estados ou ações; métodos de gradiente de política otimizam uma política parametrizada; métodos ator‑crítico aprendem ambos. RL baseado em modelo aprende ou utiliza a dinâmica de transição para planejar. A família apropriada depende do tipo de ação, dados, fidelidade do simulador, horizonte e requisitos de estabilidade. Compare com linhas de base heurísticas, supervisionadas e de teoria de controle. Avalie retorno médio e de pior caso, violações de restrições, eficiência de amostragem, robustez a mudanças no ambiente e variância entre sementes, em vez de selecionar a execução com a melhor curva de aprendizado.
A exploração online pode ser inaceitável em saúde, finanças, robótica e infraestrutura. Treine em simulação ou em dados registrados quando possível, quantifique a lacuna simulador‑realidade e use avaliação fora da política com cautela, pois ações não vistas carecem de suporte. A implantação deve limitar ações, taxa, recursos e região operacional; incluir aprovação humana para escolhas consequenciais; e fornecer um controlador ou desligamento seguro. Monitore a recompensa junto aos resultados reais, pois um agente pode melhorar sua pontuação enquanto prejudica o objetivo pretendido. Revalide após mudanças no ambiente, política ou recompensa.
Exemplo prático: controle de energia com aprendizado por reforço
Um operador de edifício modela temperatura, ocupação, clima, estado do equipamento e preço da eletricidade, com ações limitadas a ajustes seguros de ponto de ajuste. A recompensa combina conforto, energia, encargos de demanda e restrições de equipamento, mas violações reais de conforto são avaliadas separadamente, de modo que a otimização da recompensa não pode esconder danos. Controle histórico e controle preditivo baseado em modelo fornecem linhas de base. O treinamento usa um simulador calibrado com clima aleatório, ruído de sensores e eficiência do equipamento.
Antes de influenciar o edifício, a política é executada contra observações ao vivo sem agir. Engenheiros inspecionam trajetórias, margens de restrição e comportamento durante feriados, ondas de calor, quedas de energia e sensores ausentes. A implantação limita a taxa e o alcance das ações e mantém o controlador de segurança existente. Um humano pode sobrescrever a qualquer momento. O monitoramento compara energia e conforto com períodos correspondentes, registra intervenções e reverte se violações, ciclos inesperados ou descompasso de modelo excederem os limites definidos.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, reversão e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Referências principais